Um engenheiro de processos quer aumentar a conversão de um reator químico. A receita é simples: subir a temperatura, deixar o reagente mais tempo dentro do reator. Os dois ajustes funcionam: conversões de 99% são perfeitamente alcançáveis só apertando esses dois botões. O problema é que “mais alto” e “mais devagar” custam dinheiro (energia para aquecer, capital para um reator maior) e, em algum ponto, ficam perigosos demais para operar. A pergunta de verdade é “qual o melhor equilíbrio entre conversão, custo e segurança”, e não “qual a conversão máxima possível”.
Essa é a diferença entre um problema de otimização de livro-texto e um
problema de otimização real. O
artigo anterior
estabeleceu os fundamentos do scipy.optimize: minimize,
SLSQP (sequential least squares programming, o método padrão para
problemas com restrições), bounds, restrições de igualdade. Fez isso com o
tanque cilíndrico, um problema
elegante mas com uma única restrição de igualdade em duas variáveis.
Este artigo e o anterior formam um par: lá, os fundamentos; aqui, esses
mesmos fundamentos aplicados a quatro problemas reais, de domínios
diferentes. Todos têm uma característica em comum: a solução “ótima”
não é óbvia sem calcular, e simplesmente empurrar as variáveis para o
extremo nem sempre é a resposta certa.
Por Que Otimização Aplicada Importa? #
- Química e engenharia de processos: quase todo projeto de reator, coluna de destilação ou trocador de calor envolve equilibrar desempenho contra custo de energia, custo de capital e limites de segurança, nunca “desempenho puro”.
- Física e engenharia mecânica: balística, aerodinâmica e projeto de veículos lidam com otimizações onde a função-objetivo só existe como resultado de uma simulação numérica, sem fórmula fechada nenhuma.
- Engenharia estrutural: dimensionar qualquer peça estrutural (vigas, colunas, cabos) é otimizar massa (custo, peso) sujeita a múltiplos critérios de segurança simultâneos, quase sempre mais de um ativo ao mesmo tempo.
- Ciência de dados: ajustar hiperparâmetros de um modelo é o mesmo problema em espírito, o de maximizar uma métrica de desempenho sujeita a restrições de tempo de treinamento, memória ou custo computacional.
Recapitulando o Essencial do Artigo Anterior #
Sem repetir a mecânica básica, scipy.optimize.minimize resolve
otimização multivariável, com bounds para limites de caixa e
constraints (dicionários com 'type': 'eq'/'ineq' e 'fun') para
restrições de igualdade e desigualdade: 'ineq' exige que a função da
restrição retorne um valor \(\geq 0\) quando satisfeita. method="SLSQP"
é a escolha padrão quando há restrições. Todo esse ferramental reaparece
aqui, sem reapresentação.
Uma convenção, porém, merece ser relembrada, porque ela aparece em quase todo bloco de código deste artigo e polui a leitura de quem não a reconhece:
Neste artigo, três dos quatro problemas são de maximização: lucro,
alcance, lucro de novo. Mas o scipy.optimize só minimiza: não existe função
maximize. Como vimos no
artigo anterior,
a saída é sempre a mesma: maximizar \(f\) é minimizar \(-f\).
Virar a função de cabeça para baixo troca picos por vales sem mover
nenhum deles de lugar.
Daí a convenção de nomes que você vai ver a seguir. Sempre que uma função
se chamar menos_alguma_coisa, ou aparecer um - na frente da
função-objetivo, é esse truque em ação, não um erro de sinal:
| No código | Significa |
|---|---|
def menos_lucro(v): return -lucro_liquido(*v) |
o que é minimizado |
minimize(menos_lucro, ...) |
mas o que se quer é o lucro máximo |
-res.fun |
desfaz o sinal para ler o lucro de verdade |
minimize_scalar(lambda th: -alcance(th), ...) |
mesma ideia, em uma variável |
linprog(-lucro_ton, ...) |
mesma ideia, num vetor inteiro de coeficientes |
A regra prática, para não se perder: o sinal negativo aparece duas vezes, uma ao definir o objetivo e outra ao ler o resultado. Se você vir só uma das duas, provavelmente há um bug.
Química: Reator Contínuo: Conversão × Custo × Segurança #
Um reator CSTR (continuous stirred-tank reactor, reator de mistura completa em regime contínuo) processa uma reação de 1ª ordem. A constante de velocidade segue a equação de Arrhenius, \(k(T) = A_0 e^{-E_a/(RT)}\), e a conversão de saída de um CSTR para reação de 1ª ordem tem fórmula fechada simples em função da temperatura \(T\) e do tempo de residência \(\tau\):
$$ X(T,\tau) = \frac{k(T)\tau}{1+k(T)\tau} $$Ela não é arbitrária: sai de um balanço de massa em três linhas, e vale a pena ver, porque é ela que dá o formato de toda a superfície que vamos otimizar.
Num CSTR em estado estacionário, o que entra do reagente \(A\) menos o que sai é igual ao que a reação consome. Chamando de \(F_{A0}\) a vazão molar de entrada e de \(X\) a fração convertida:
$$F_{A0} X = (-r_A) V$$Para uma reação de 1ª ordem, \(-r_A = k C_A\), e a concentração de saída de um reator de mistura completa é a mesma de dentro dele, \(C_A = C_{A0}(1-X)\). Substituindo, e escrevendo \(F_{A0} = C_{A0} v_0\) com \(v_0\) a vazão volumétrica:
$$C_{A0} v_0 X = k C_{A0}(1-X) V$$Os \(C_{A0}\) se cancelam. Dividindo por \(v_0\) e reconhecendo o tempo de residência \(\tau = V/v_0\):
$$X = k\tau(1-X) \quad\Longrightarrow\quad X(1 + k\tau) = k\tau$$Isolando \(X\), chega-se à fórmula acima. Repare no que ela diz: como \(X = k\tau/(1+k\tau)\), a conversão nunca chega a 1, por maior que seja \(\tau\), ela só se aproxima. É por isso que o problema de “maximizar a conversão” vai sempre empurrar \(\tau\) para o limite superior da busca, como veremos daqui a pouco.
import numpy as np

R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)
O Problema Errado: Maximizar Só a Conversão #
Se o objetivo for simplesmente maximizar \(X\), sem custo nenhum associado a \(T\) ou \(\tau\), a resposta é sempre “mais alto, mais devagar”, porque não existe ótimo interior, só os limites da busca:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]


def menos_conversao(v):
    T, tau = v
    return -conversao(T, tau)


res_trivial = minimize(menos_conversao, x0=[340, 2.0], method="SLSQP", bounds=bounds_reator)
print(res_trivial.x, -res_trivial.fun)
[500. 50.] 0.9993310063263992É o truque em ação, pela primeira vez: definimos menos_conversao (com o
sinal invertido) para poder minimizar, e lemos o resultado como
-res_trivial.fun para desfazer a inversão e recuperar a conversão de
verdade, \(0{,}999\). Sem esse segundo sinal, o print mostraria
\(-0{,}999\), e a “conversão máxima” pareceria negativa.
\(T = 500\) K e \(\tau = 50\) min: os dois limites superiores de bounds,
batidos com força. Isso não é uma falha do otimizador: é a resposta
matematicamente correta para a pergunta errada. Um reator a \(500\) K
com cinquenta minutos de residência é impraticável: quente demais, grande
demais, caro demais. A pergunta certa nunca foi “maximizar conversão”.
O Problema Certo: Lucro Líquido #
Receita proporcional à conversão, custo de capital do reator proporcional a \(\tau\) (reatores maiores custam mais), custo de energia proporcional ao quanto \(T\) sobe acima de uma referência \(T_{ref}\):
$$ \text{Lucro}(T,\tau) = \text{valor} \cdot X(T,\tau) - c_v \tau - c_e (T - T_{ref}) $$
Exemplo 1: Ponto ótimo de operação do reator
Enunciado: Todos os três termos são taxas, em reais por minuto de operação: receita de \(100\) R$/min à conversão completa, custo de capital de \(5\) R$/min para cada minuto de tempo de residência (reator maior custa mais para amortizar), e custo de energia de \(0{,}50\) R$/min para cada kelvin acima de \(300\) K. Encontre a combinação \((T,\tau)\) que maximiza o lucro líquido, em R$/min.
Solução:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)


def lucro_liquido(T, tau):
    return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)


def menos_lucro(v):
    T, tau = v
    return -lucro_liquido(T, tau)


res_economico = minimize(menos_lucro, x0=[340, 2.0], method="SLSQP", bounds=bounds_reator)
print(res_economico.x, -res_economico.fun)
print("conversão:", conversao(*res_economico.x))
[406.18242318 2.74348304] 16.782824870189145
conversão: 0.8359145165639981Um ótimo interior de verdade: \(T^\ast \approx 406\) K, \(\tau^\ast \approx 2{,}74\) min, conversão de \(83{,}6\%\), nem perto dos \(99{,}9\%\) da solução trivial, mas o lucro líquido agora é o que realmente importa. A conversão marginal que faltaria para chegar a \(99{,}9\%\) custaria mais em energia e capital do que valeria em receita.
A Restrição de Segurança #
Reatores exotérmicos têm um limite real de temperatura de operação: acima dele, o risco de disparo térmico (runaway) deixa de ser aceitável. Impor essa restrição de segurança:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)


def lucro_liquido(T, tau):
    return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)


def menos_lucro(v):
    T, tau = v
    return -lucro_liquido(T, tau)


T_max_seguranca = 380.0

res_seguro = minimize(
    menos_lucro,
    x0=[340, 2.0],
    method="SLSQP",
    bounds=bounds_reator,
    constraints={"type": "ineq", "fun": lambda v: T_max_seguranca - v[0]},
)
print(res_seguro.x, -res_seguro.fun)
print("conversão:", conversao(*res_seguro.x))
[380. 3.97133099] 12.811670365630604
conversão: 0.7266832532268612A restrição de segurança está expressa como constraints, não como
bounds, de propósito: é uma limitação de processo, não um limite
arbitrário de busca, e vale deixar essa distinção explícita no código. O
otimizador reage do jeito esperado: como \(380\) K é menor que o ótimo
irrestrito (\(\approx406\) K), a restrição passa a valer no limite
(binding), e o otimizador compensa aumentando \(\tau\) (de
\(2{,}74\) para \(3{,}97\) min) para recuperar parte da conversão
perdida. Mesmo assim, o lucro cai de \(16{,}78\) para \(12{,}81\),
uma queda de \(23{,}7\%\). Segurança tem custo real, e esse custo
agora está quantificado.
bounds ou constraints: a diferença não é só de estilo
Poderíamos ter escrito \(T \le 380\) K como bounds=[(280, 380), ...]
em vez de constraints. Aqui os dois dão exatamente o mesmo
resultado, e pelo mesmo preço: \(10\) iterações e \(32\) avaliações
nos dois casos. Mas eles não são intercambiáveis, e a diferença aparece
quando se registra onde o otimizador pisou durante a busca:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)


def lucro_liquido(T, tau):
    return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)


def menos_lucro(v):
    T, tau = v
    return -lucro_liquido(T, tau)


T_max_seguranca = 380.0
vistos = []


def menos_lucro_espiao(v):
    vistos.append(v[0])          # registra cada T avaliado
    return menos_lucro(v)


minimize(menos_lucro_espiao, x0=[340, 2.0], method="SLSQP",
         bounds=bounds_reator,
         constraints={"type": "ineq", "fun": lambda v: T_max_seguranca - v[0]})
acima = [T for T in vistos if T > T_max_seguranca]
print(f"avaliações acima de 380 K: {len(acima)} de {len(vistos)}")
avaliações acima de 380 K: 4 de 32Com constraints, o SLSQP avaliou a função quatro vezes acima do
limite (por \(1{,}5 \times 10^{-8}\) K; são os passos da derivada
por diferenças finitas na fronteira). Trocando para
bounds=[(280, 380), (0.01, 50)], esse número vai a zero: aqui, bounds
funcionou como uma caixa que o otimizador não atravessou.
A regra prática que sai daí:
- Se a função não existe fora da região (raiz de número negativo,
logaritmo de zero, um modelo que devolve
nanou levanta exceção), usebounds. É a única das duas que garante que ela jamais será chamada lá fora. - Se a restrição é uma limitação real do processo e a função continua
perfeitamente calculável do outro lado (é o nosso caso: nada impede de
calcular o lucro a \(400\) K, só não é seguro operar assim), use
constraints. Além de funcionar, documenta a intenção, e é a única forma de expressar restrições que misturam variáveis, como \(h \le 6b\) na viga mais adiante, que nenhuma caixa consegue representar.
import matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)


def lucro_liquido(T, tau):
    return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)


def menos_lucro(v):
    T, tau = v
    return -lucro_liquido(T, tau)


T_max_seguranca = 380.0

res_economico = minimize(menos_lucro, x0=[340, 2.0], method="SLSQP", bounds=bounds_reator)
res_seguro = minimize(
    menos_lucro,
    x0=[340, 2.0],
    method="SLSQP",
    bounds=bounds_reator,
    constraints={"type": "ineq", "fun": lambda v: T_max_seguranca - v[0]},
)

T_grid = np.linspace(300, 450, 300)
tau_grid = np.linspace(0.1, 10, 300)
TT, TAU = np.meshgrid(T_grid, tau_grid)
NET = lucro_liquido(TT, TAU)

fig, ax = plt.subplots()
cf = ax.contourf(TT, TAU, NET, levels=50, cmap="viridis")
fig.colorbar(cf, ax=ax, label="lucro líquido (R$/min)")
ax.axvline(T_max_seguranca, color="red", linestyle="--", label="limite de segurança (T=380K)")
ax.plot(*res_economico.x, "*", color="white", markersize=16, markeredgecolor="black", label="ótimo sem restrição")
ax.plot(*res_seguro.x, "o", color="orange", markersize=12, markeredgecolor="black", label="ótimo com T<=380K")
ax.set_xlabel("T (K)")
ax.set_ylabel(r"$\tau$ (min)")
ax.legend()
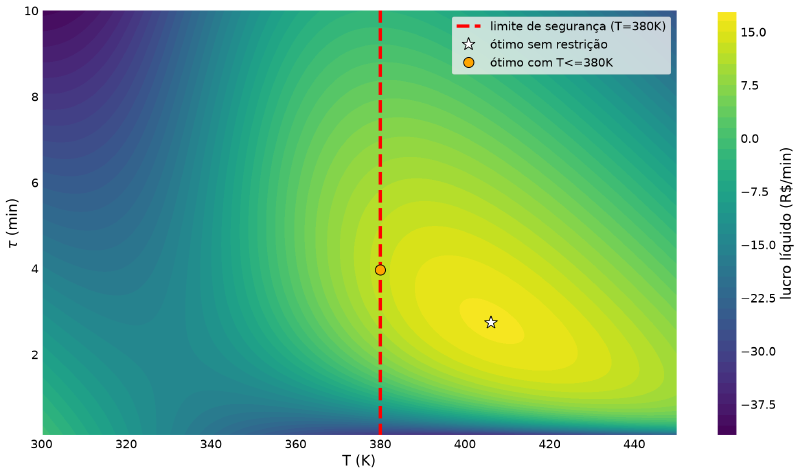
O mapa de contorno a seguir mostra o pico de lucro (estrela), o limite de segurança cortando o espaço de busca (linha tracejada), e como o ótimo restrito (círculo laranja) desliza para cima ao longo dessa linha, compensando com mais tempo de residência o que perde em temperatura:
Não Existe Um Ótimo: Existe Uma Fronteira #
Tudo até aqui devolveu um ponto. Mas “o melhor equilíbrio entre
conversão, custo e segurança” pressupõe que alguém já decidiu quanto vale
um ponto percentual de conversão, foi o que fizemos ao fixar
valor = 100. Se essa escolha mudar, o ótimo muda de lugar.
A pergunta mais honesta é outra: para cada conversão que eu queira exigir, qual é o menor custo que a atinge? Isso é um problema de otimização diferente, o de minimizar custo com a conversão como restrição, resolvido uma vez para cada alvo:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]

T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)
T_max_seguranca = 380.0


def custo_operacao(T, tau):
    return c_v * tau + c_e * (T - T_ref)


def custo_minimo_para(X_alvo):
    return minimize(
        lambda v: custo_operacao(*v),
        x0=[350.0, 3.0],
        method="SLSQP",
        bounds=bounds_reator,
        constraints=[
            {"type": "ineq", "fun": lambda v: conversao(v[0], v[1]) - X_alvo},
            {"type": "ineq", "fun": lambda v: T_max_seguranca - v[0]},
        ],
    )


alvos = np.linspace(0.40, 0.95, 60)
custos = np.array([custo_minimo_para(a).fun for a in alvos])
lucros = valor * alvos - custos
O conjunto de pares \((X, \text{custo mínimo})\) é a fronteira de Pareto do problema: a curva abaixo da qual não existe operação possível. Cada ponto dela é um compromisso legítimo, e nenhum é “o certo” sem que alguém diga quanto vale a conversão.
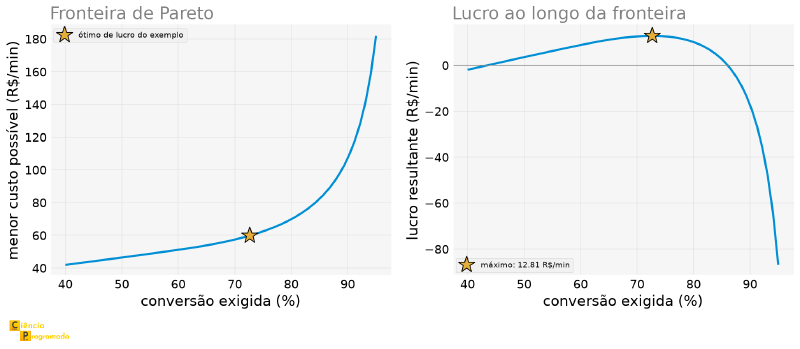
Os números explicam o formato:
| Conversão exigida | Menor custo (R$/min) | Lucro (R$/min) |
|---|---|---|
| 50% | 46,57 | +3,68 |
| 70% | 57,29 | +12,54 |
| 72,7% (ótimo) | 59,86 | +12,81 |
| 80% | 70,03 | +10,05 |
| 90% | 109,84 | −19,50 |
| 95% | 181,90 | −86,90 |
Duas leituras valem o esforço. A primeira: a estrela do ótimo econômico cai exatamente sobre a fronteira, e tinha de cair, porque o ponto de lucro máximo é necessariamente eficiente. Serve de conferência para todo o exemplo.
A segunda é a lição de engenharia de processo. Subir de \(72{,}7\%\) para \(95\%\) de conversão triplica o custo, de \(59{,}86\) para \(181{,}90\) R$/min, e leva o lucro de \(+12{,}81\) a \(-86{,}90\). O motivo está na própria fórmula deduzida no começo: como \(X = k\tau/(1+k\tau)\) se aproxima de 1 sem nunca chegar, cada ponto percentual a mais perto do topo exige um \(\tau\) desproporcionalmente maior, ou seja, um reator desproporcionalmente maior. “Rendimento quase total” costuma ser uma decisão econômica ruim, e a fronteira mostra exatamente onde ela passa a ser.
Física: Alcance Máximo de um Projétil com Arrasto Quadrático #
O artigo de equações diferenciais desta série resolveu a queda de um objeto sob arrasto proporcional ao quadrado da velocidade, mas só na direção vertical. Estendendo para duas dimensões, um projétil de massa \(m\) lançado com velocidade inicial \(v_0\) e ângulo \(\theta\) segue
$$ \begin{aligned} \frac{dx}{dt} &= v_x \\ \frac{dy}{dt} &= v_y \\ m\frac{dv_x}{dt} &= -kvv_x \\ m\frac{dv_y}{dt} &= -mg - kvv_y \end{aligned} $$com \(v = \sqrt{v_x^2+v_y^2}\) a velocidade total. O arrasto aponta na direção oposta à velocidade (por isso os termos \(-k v v_x\) e \(-k v v_y\), não só \(-k v_x\)/\(-k v_y\)) e tem magnitude proporcional ao quadrado da velocidade total, \(kv \cdot v = kv^2\). Dessa vez, sem simplificação nenhuma para a vertical, temos a equação diferencial ordinária (EDO) bidimensional completa:
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81
m_bola = 0.5  # kg
k_arrasto = 0.01  # kg/m
v0 = 40.0  # m/s, lançamento forte


def campo_projetil(t, y):
    x, alt, vx, vy = y
    v = np.hypot(vx, vy)
    return [vx, vy, -(k_arrasto / m_bola) * v * vx, -g - (k_arrasto / m_bola) * v * vy]


def evento_solo(t, y):
    return y[1]


evento_solo.terminal = True
evento_solo.direction = -1
A mesma convenção campo(t, y) do
artigo de equações diferenciais,
agora com quatro componentes (posição \(x\), altura, e as duas componentes da
velocidade) em vez de duas. evento_solo é um evento do solve_ivp que
interrompe a integração assim que a altura volta a zero: o instante em
que o projétil toca o chão.
Exemplo 2: O ângulo de \(45°\) deixa de ser ótimo
Enunciado: Sem resistência do ar, o ângulo que maximiza o alcance de um projétil é sempre \(45°\), resultado clássico, fórmula fechada. Com arrasto quadrático, encontre o ângulo ótimo de verdade.
Solução: A função-objetivo aqui não tem fórmula nenhuma: cada
avaliação dela resolve a EDO do zero. E, como queremos o alcance
máximo, aparece de novo o mesmo truque de sinal: em vez de criar uma
função menos_alcance, basta um lambda th: -alcance(th) na hora da
chamada, e o -res_angulo.fun no fim para ler o alcance de verdade.
import numpy as np
from scipy.integrate import solve_ivp
from scipy.optimize import minimize_scalar

g = 9.81
m_bola = 0.5  # kg
k_arrasto = 0.01  # kg/m
v0 = 40.0  # m/s, lançamento forte


def campo_projetil(t, y):
    x, alt, vx, vy = y
    v = np.hypot(vx, vy)
    return [vx, vy, -(k_arrasto / m_bola) * v * vx, -g - (k_arrasto / m_bola) * v * vy]


def evento_solo(t, y):
    return y[1]


evento_solo.terminal = True
evento_solo.direction = -1


def alcance(theta_graus):
    theta = np.radians(theta_graus)
    y0 = [0.0, 0.0, v0 * np.cos(theta), v0 * np.sin(theta)]
    sol = solve_ivp(campo_projetil, [0, 60], y0, events=evento_solo, rtol=1e-9, atol=1e-11)
    return sol.y[0, -1]


res_angulo = minimize_scalar(lambda th: -alcance(th), bounds=(10, 80), method="bounded")
print(res_angulo.x, -res_angulo.fun)
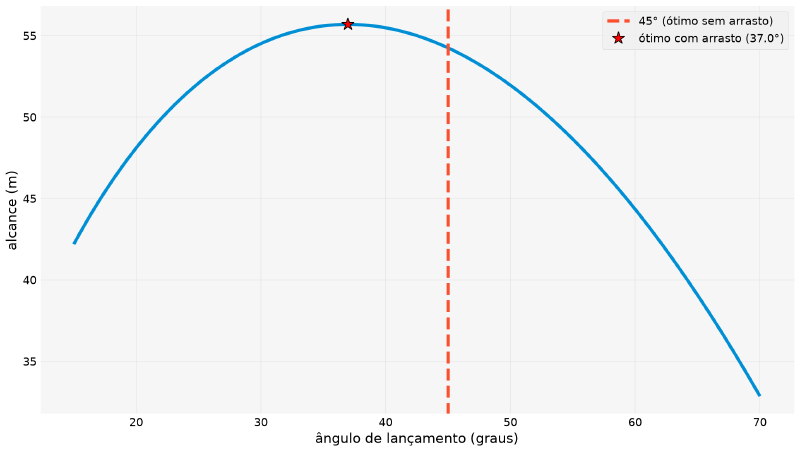
36.981129256500815 55.69219963290741O ângulo ótimo, \(\approx37°\), fica bem abaixo dos \(45°\) clássicos: o arrasto penaliza mais as trajetórias mais altas (mais tempo no ar, mais distância total percorrida sujeita ao arrasto) do que as mais rasas.
Comparando com o alcance a \(45°\) com o mesmo arrasto:
import numpy as np
from scipy.integrate import solve_ivp
from scipy.optimize import minimize_scalar

g = 9.81
m_bola = 0.5  # kg
k_arrasto = 0.01  # kg/m
v0 = 40.0  # m/s, lançamento forte


def campo_projetil(t, y):
    x, alt, vx, vy = y
    v = np.hypot(vx, vy)
    return [vx, vy, -(k_arrasto / m_bola) * v * vx, -g - (k_arrasto / m_bola) * v * vy]


def evento_solo(t, y):
    return y[1]


evento_solo.terminal = True
evento_solo.direction = -1


def alcance(theta_graus):
    theta = np.radians(theta_graus)
    y0 = [0.0, 0.0, v0 * np.cos(theta), v0 * np.sin(theta)]
    sol = solve_ivp(campo_projetil, [0, 60], y0, events=evento_solo, rtol=1e-9, atol=1e-11)
    return sol.y[0, -1]


res_angulo = minimize_scalar(lambda th: -alcance(th), bounds=(10, 80), method="bounded")

alcance_45 = alcance(45)
print("alcance a 45°:", alcance_45)
print("melhora:", (-res_angulo.fun - alcance_45) / alcance_45 * 100, "%")
alcance a 45°: 54.24944183149212
melhora: 2.659488748099452 %A melhora é modesta, \(2{,}7\%\), porque a curva de alcance por ângulo é bem achatada perto do máximo (o mesmo fenômeno já visto perto de qualquer ótimo suave). Mas o deslocamento do ângulo em si é bem mais que modesto: mais de \(8°\) abaixo do valor clássico. Para efeito de contraste, o alcance ideal a \(45°\) sem nenhum arrasto seria de \(v_0^2/g \approx 163\) m, quase o triplo do que o arrasto permite aqui, um lembrete de quanto a resistência do ar realmente pesa em velocidades de lançamento maiores.
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp
from scipy.optimize import minimize_scalar

g = 9.81
m_bola = 0.5  # kg
k_arrasto = 0.01  # kg/m
v0 = 40.0  # m/s, lançamento forte


def campo_projetil(t, y):
    x, alt, vx, vy = y
    v = np.hypot(vx, vy)
    return [vx, vy, -(k_arrasto / m_bola) * v * vx, -g - (k_arrasto / m_bola) * v * vy]


def evento_solo(t, y):
    return y[1]


evento_solo.terminal = True
evento_solo.direction = -1


def alcance(theta_graus):
    theta = np.radians(theta_graus)
    y0 = [0.0, 0.0, v0 * np.cos(theta), v0 * np.sin(theta)]
    sol = solve_ivp(campo_projetil, [0, 60], y0, events=evento_solo, rtol=1e-9, atol=1e-11)
    return sol.y[0, -1]


res_angulo = minimize_scalar(lambda th: -alcance(th), bounds=(10, 80), method="bounded")

thetas = np.linspace(15, 70, 200)
alcances = [alcance(t) for t in thetas]

fig, ax = plt.subplots()
ax.plot(thetas, alcances)
ax.axvline(45, color="C1", linestyle="--", label="45° (ótimo sem arrasto)")
ax.plot(res_angulo.x, -res_angulo.fun, "*", color="red", markersize=16, markeredgecolor="black",
        label=f"ótimo com arrasto ({res_angulo.x:.1f}°)")
ax.set_xlabel("ângulo de lançamento (graus)")
ax.set_ylabel("alcance (m)")
ax.legend()
O gráfico a seguir compara o alcance em cada ângulo com o pico encontrado pelo otimizador:
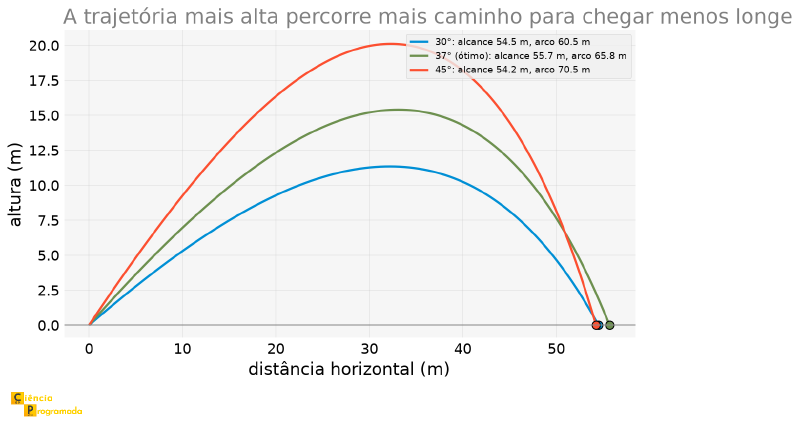
Por Que o Ângulo Caiu: Olhando as Trajetórias #
A explicação de que “o arrasto penaliza as trajetórias mais altas” fica
mais convincente quando se olha as trajetórias em si, e, principalmente,
quando se mede o comprimento do caminho percorrido, que é o que o
arrasto de fato cobra. Como o solve_ivp já devolve a solução contínua com
dense_output=True, dá para reconstruir cada trajetória e somar os
pedacinhos:
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81
m_bola = 0.5  # kg
k_arrasto = 0.01  # kg/m
v0 = 40.0  # m/s, lançamento forte


def campo_projetil(t, y):
    x, alt, vx, vy = y
    v = np.hypot(vx, vy)
    return [vx, vy, -(k_arrasto / m_bola) * v * vx, -g - (k_arrasto / m_bola) * v * vy]


def evento_solo(t, y):
    return y[1]


evento_solo.terminal = True
evento_solo.direction = -1


def trajetoria(theta_graus):
    theta = np.radians(theta_graus)
    y0 = [0.0, 0.0, v0 * np.cos(theta), v0 * np.sin(theta)]
    return solve_ivp(campo_projetil, [0, 60], y0, events=evento_solo,
                     dense_output=True, rtol=1e-9, atol=1e-11)


print(f"{'ângulo':>7} {'alcance':>9} {'t de voo':>9} {'altura máx':>11} {'arco':>8}")
for ang in (30, 36.98, 45):
    s = trajetoria(ang)
    tt = np.linspace(0, s.t[-1], 600)
    xs, ys = s.sol(tt)[0], s.sol(tt)[1]
    arco = np.sum(np.hypot(np.diff(xs), np.diff(ys)))
    print(f"{ang:>6.0f}° {xs[-1]:>8.2f}m {s.t[-1]:>8.2f}s {ys.max():>10.2f}m {arco:>7.2f}m")
ângulo alcance t de voo altura máx arco
30° 54.51m 3.00s 11.35m 60.45m
37° 55.69m 3.50s 15.40m 65.80m
45° 54.25m 4.01s 20.11m 70.47mA tabela fecha o argumento. Compare as duas pontas: o lançamento a \(45°\) percorre 70,5 m de caminho para chegar a apenas \(54{,}2\) m de distância; o de \(37°\) percorre \(65{,}8\) m e chega mais longe, a \(55{,}7\) m. Cada metro de arco extra é um metro a mais sob a ação do arrasto, e a \(45°\) esse gasto é desperdiçado subindo: \(20{,}1\) m de altura máxima contra \(15{,}4\) m.
E por que não descer ainda mais o ângulo, então? Porque o outro lado da troca aparece a \(30°\). É a trajetória mais econômica em arco (\(60{,}5\) m, a menor das três), mas fica só \(3{,}0\) s no ar contra \(4{,}0\) s da de \(45°\): pouco tempo para converter velocidade em distância horizontal, e ela também chega mais perto. O ótimo em \(\approx37°\) é exatamente o ponto onde essas duas pressões opostas se equilibram.
Desenhando as três lado a lado, a troca fica visível de uma vez:
Engenharia: Dimensionamento de Viga com Três Restrições #
O último exemplo troca “poucas restrições, ótimo suave” por “várias restrições, ótimo definido pela interseção delas”. Uma viga de seção retangular (largura \(b\), altura \(h\)), simplesmente apoiada, com uma carga central \(P\) e vão \(L\), precisa ser dimensionada com a menor área de seção possível (proxy direto de massa e custo de material), sujeita a três limites de engenharia simultâneos:
- Tensão de flexão não pode exceder a tensão admissível do material: \(\sigma = \dfrac{6M}{bh^2} \leq \sigma_{max}\), onde \(M = PL/4\) é o momento fletor máximo.
- Flecha (deflexão no meio do vão) não pode exceder um limite de serviço, tipicamente entre \(L/240\) e \(L/360\), conforme a norma e o uso (aqui, \(L/300\)): \(\delta = \dfrac{PL^3}{48EI} \leq \delta_{max}\), com \(I = bh^3/12\).
- Esbeltez não pode exceder uma razão máxima entre altura e largura (\(h/b \leq r_{max}\)), porque vigas altas e finas demais flambam lateralmente antes mesmo de atingir a tensão de flexão limite.
A esbeltez. A física invocada está certa: uma viga alta e fina realmente perde estabilidade lateral antes de atingir a tensão limite. Mas \(h/b \leq 6\) é uma regra de bolso, não um critério normativo. A flambagem lateral-torsional de verdade depende do comprimento não travado da viga (a distância entre os pontos onde ela é contida lateralmente) e de propriedades da seção que \(h/b\) não captura. Usamos a regra simples aqui porque ela cumpre o papel didático: ser uma terceira restrição, de natureza diferente das outras duas.
A seção. Vigas de aço reais são perfis I, justamente porque a seção retangular maciça é ineficiente: ela põe muito material perto da linha neutra, onde ele quase não contribui para resistir à flexão. Uma seção retangular mantém o exemplo com duas variáveis limpas e visualizáveis num plano, mas guarde a pergunta, porque ela é o passo seguinte natural: e se a própria forma da seção fosse variável de projeto?
O peso próprio também é ignorado: a única carga é a de \(20\) kN no meio do vão. Para uma viga deste porte a diferença é pequena, mas num dimensionamento real ele entra.
Exemplo 3: Dimensionamento com três restrições ativas
Enunciado: Viga de aço (\(E=200\) GPa), vão de \(4\) m, carga central de \(20\) kN, tensão admissível de \(150\) MPa, flecha máxima de \(L/300\), razão \(h/b\) máxima de \(6\). Encontre as dimensões \(b\) e \(h\) que minimizam a área da seção.
Solução:
import numpy as np
from scipy.optimize import minimize

E_aco = 200e9
L_viga = 4.0
P_carga = 20000.0
M_fletor = P_carga * L_viga / 4
sigma_max = 150e6
delta_max = L_viga / 300
r_max = 6.0


def area_secao(v):
    b, h = v
    return b * h


def restr_tensao(v):
    b, h = v
    return sigma_max - 6 * M_fletor / (b * h**2)


def restr_flecha(v):
    b, h = v
    I = b * h**3 / 12
    return delta_max - P_carga * L_viga**3 / (48 * E_aco * I)


def restr_esbeltez(v):
    b, h = v
    return r_max * b - h


res_viga = minimize(
    area_secao,
    x0=[0.1, 0.2],
    method="SLSQP",
    bounds=[(0.01, 1), (0.01, 1)],
    constraints=[
        {"type": "ineq", "fun": restr_tensao},
        {"type": "ineq", "fun": restr_flecha},
        {"type": "ineq", "fun": restr_esbeltez},
    ],
)
print(res_viga.x, res_viga.fun)
[0.02811442 0.16868653] 0.004742524405986762\(b\approx28{,}1\) mm, \(h\approx168{,}7\) mm, área \(\approx47{,}4\) cm². Verificando cada restrição na solução: a tensão fica em \(150{,}0\) MPa (exatamente no limite), a esbeltez \(h/b\) fica em \(6{,}0\) (exatamente no limite), e a flecha fica em \(11{,}9\) mm, contra um limite de \(13{,}3\) mm, \(11\%\) de folga. Duas das três restrições estão ativas simultaneamente; a terceira tem folga.
O resultado é o mesmo para vários chutes iniciais espalhados: \((0{,}05, 0{,}05)\), \((0{,}5, 0{,}5)\), \((0{,}02, 0{,}5)\) convergem todos para a mesma dimensão, sinal de que este problema (diferente do Himmelblau do artigo anterior) tem um único ótimo local, que é também o global.
O gráfico a seguir mostra a região viável (verde) delimitada pelas três curvas de restrição, com o ótimo exatamente no canto formado pelo encontro entre o limite de tensão e o de esbeltez.
A região viável sai de avaliar as três restrições sobre uma malha de \((b, h)\) e ficar com os pontos onde as três valem ao mesmo tempo. Por cima dela, desenhamos a fronteira de cada restrição isolada, cada uma obtida isolando \(h\) em função de \(b\) na igualdade correspondente:
import matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize

E_aco = 200e9
L_viga = 4.0
P_carga = 20000.0
M_fletor = P_carga * L_viga / 4
sigma_max = 150e6
delta_max = L_viga / 300
r_max = 6.0


def area_secao(v):
    b, h = v
    return b * h


def restr_tensao(v):
    b, h = v
    return sigma_max - 6 * M_fletor / (b * h**2)


def restr_flecha(v):
    b, h = v
    I = b * h**3 / 12
    return delta_max - P_carga * L_viga**3 / (48 * E_aco * I)


def restr_esbeltez(v):
    b, h = v
    return r_max * b - h


res_viga = minimize(
    area_secao,
    x0=[0.1, 0.2],
    method="SLSQP",
    bounds=[(0.01, 1), (0.01, 1)],
    constraints=[
        {"type": "ineq", "fun": restr_tensao},
        {"type": "ineq", "fun": restr_flecha},
        {"type": "ineq", "fun": restr_esbeltez},
    ],
)

b_vals = np.linspace(0.005, 0.08, 400)
h_vals = np.linspace(0.02, 0.35, 400)
B, H = np.meshgrid(b_vals, h_vals)
viavel = (
    (6 * M_fletor / (B * H**2) <= sigma_max)
    & (P_carga * L_viga**3 / (48 * E_aco * (B * H**3 / 12)) <= delta_max)
    & (H / B <= r_max)
)

b_otimo, h_otimo = res_viga.x

fig, ax = plt.subplots()
ax.contourf(B * 1000, H * 1000, viavel, levels=[-0.5, 0.5, 1.5],
            colors=["white", "#cde9d8"])

b_linha = np.linspace(0.005, 0.08, 200)
# tensão no limite:  6M/(b h²) = sigma_max   ->   h = sqrt(6M / (sigma_max b))
ax.plot(b_linha * 1000, np.sqrt(6 * M_fletor / (sigma_max * b_linha)) * 1000,
        color="C1", linewidth=2, label="limite de tensão")
# flecha no limite:  PL³/(48 E b h³/12) = delta_max   ->   h = (12 C / b)^(1/3)
C_flecha = P_carga * L_viga**3 / (48 * E_aco * delta_max)
ax.plot(b_linha * 1000, (12 * C_flecha / b_linha) ** (1 / 3) * 1000,
        color="C3", linewidth=2, label="limite de flecha")
# esbeltez no limite:  h/b = r_max   ->   h = 6b
ax.plot(b_linha * 1000, r_max * b_linha * 1000,
        color="C0", linewidth=2, label="limite de esbeltez (h = 6b)")

ax.plot(b_otimo * 1000, h_otimo * 1000, "*", color="black", markersize=18,
        markeredgecolor="white", label="ótimo")
ax.set_xlabel("b (mm)")
ax.set_ylabel("h (mm)")
ax.set_xlim(5, 80)
ax.set_ylim(20, 350)
ax.legend(fontsize=9, loc="upper right")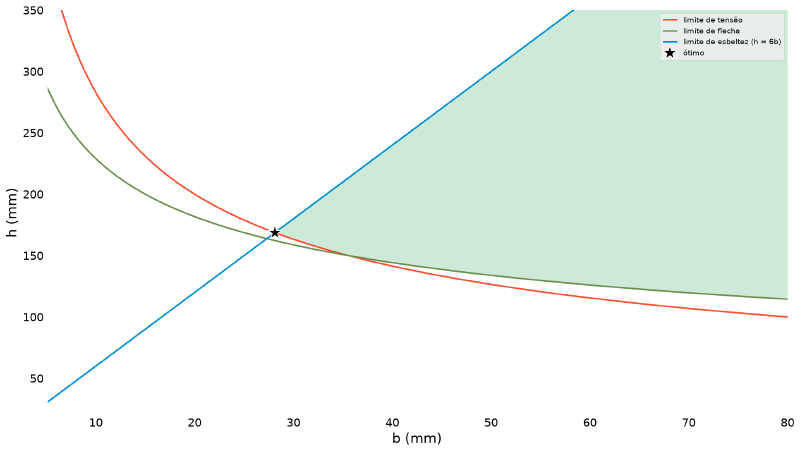
Pesquisa Operacional: Alocando Recursos com linprog
#
Os três exemplos anteriores têm algo em comum: a função-objetivo é
não-linear (uma exponencial de Arrhenius, uma EDO integrada, uma
divisão por \(bh^2\)). Existe uma família inteira de problemas em que
tanto o objetivo quanto as restrições são lineares, e para ela, usar
minimize é a ferramenta errada.
O caso clássico é o mix de produção. Uma planta fabrica dois produtos que disputam os mesmos equipamentos:
| Produto A | Produto B | Disponível | |
|---|---|---|---|
| Lucro | R$ 40/t | R$ 30/t | |
| Horas de reator | 2 h/t | 1 h/t | 100 h |
| Horas de destilação | 1 h/t | 1 h/t | 80 h |
| Demanda máxima | 65 t de B |
Quanto produzir de cada um? Em notação matricial, maximizar \(40x_A + 30x_B\) sujeito a \(A\mathbf{x} \le \mathbf{b}\), com \(x_A, x_B \ge 0\).
Exemplo 4: Mix de produção
Enunciado: Determine as quantidades de A e B que maximizam o lucro, respeitando a capacidade dos dois equipamentos e o teto de demanda de B.
Solução: O scipy.optimize.linprog resolve isso com algoritmos
feitos para problemas lineares, hoje, por padrão, o HiGHS, que
implementa simplex e pontos interiores. E ele cobra o mesmo pedágio de
sinal que já apareceu três vezes neste artigo: linprog só minimiza,
então maximizar lucro significa passar o vetor de lucros negado.
import numpy as np
from scipy.optimize import linprog

lucro_ton = np.array([40.0, 30.0])          # R$/t de A, de B
A_recursos = np.array([
    [2.0, 1.0],   # reator:     h/t de A, h/t de B
    [1.0, 1.0],   # destilação: h/t de A, h/t de B
    [0.0, 1.0],   # demanda: só B tem teto
])
b_recursos = np.array([100.0, 80.0, 65.0])
nomes = ["reator (h)", "destilação (h)", "demanda de B (t)"]

res_lp = linprog(-lucro_ton, A_ub=A_recursos, b_ub=b_recursos,
                 bounds=[(0, None), (0, None)])

print(f"produzir: A = {res_lp.x[0]:.1f} t, B = {res_lp.x[1]:.1f} t")
print(f"lucro = R$ {-res_lp.fun:.2f}")
for nome, folga in zip(nomes, res_lp.slack):
    estado = "ATIVA (esgotado)" if abs(folga) < 1e-9 else f"folga de {folga:.1f}"
    print(f"  {nome:>18}: {estado}")
produzir: A = 20.0 t, B = 60.0 t
lucro = R$ 2600.00
reator (h): ATIVA (esgotado)
destilação (h): ATIVA (esgotado)
demanda de B (t): folga de 5.0Repare no atributo slack, que não tem equivalente nos exemplos
anteriores e é metade do valor prático da resposta: ele diz quanta
sobra cada restrição tem no ótimo. Reator e destilação saem com folga
zero: estão esgotados, e são eles que travam o lucro. A demanda de B
sobra \(5\) t. A leitura gerencial é imediata: investir em mais
capacidade de destilação ou de reator aumenta o lucro; fazer propaganda
para vender mais B, não.
O gráfico a seguir mostra a região viável, as retas de lucro constante e onde o ótimo foi parar:
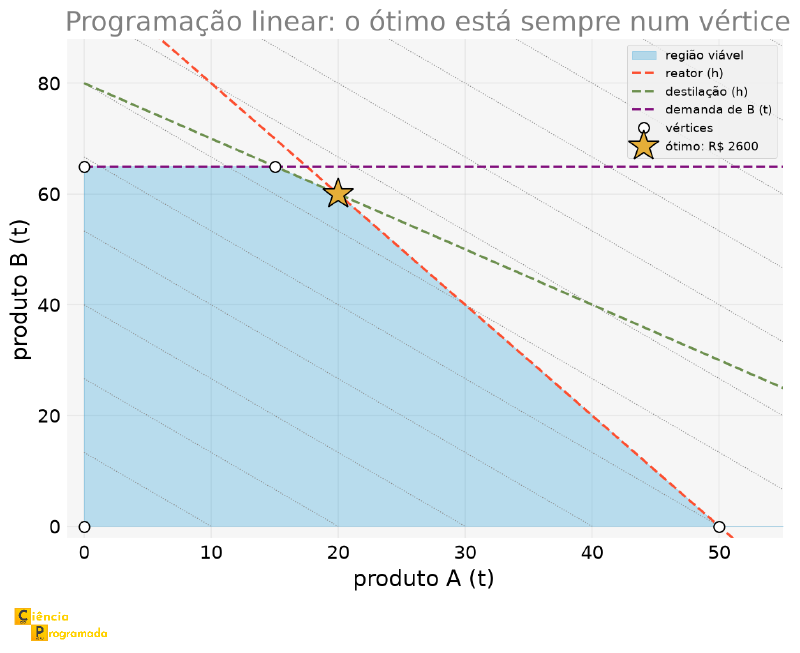
A figura mostra o fato que define programação linear: como objetivo e restrições são todos lineares, o ótimo está sempre num vértice do polígono viável. Empurrando a reta de lucro constante na direção em que ele cresce, o último ponto da região viável que ela toca é um canto. Conferindo os cinco vértices na mão:
| Vértice \((A, B)\) | Lucro |
|---|---|
| \((0, 0)\) | R$ 0 |
| \((0, 65)\) | R$ 1.950 |
| \((15, 65)\) | R$ 2.550 |
| \((20, 60)\) | R$ 2.600 |
| \((50, 0)\) | R$ 2.000 |
É por isso que existe algoritmo dedicado. O simplex não varre o interior
da região: ele caminha de vértice em vértice, sempre para um vizinho
melhor, o que resolve problemas com milhares de variáveis em tempo que
nenhum método de propósito geral alcançaria. Usar minimize aqui
funcionaria no brinquedo de duas variáveis e seria inviável numa refinaria
de verdade.
Se objetivo e restrições são lineares, use linprog: é mais rápido,
e devolve o ótimo global com certificado, coisa que minimize não
oferece em geral. Basta um termo não-linear em qualquer lugar
(um \(x^2\), um \(e^{-E_a/RT}\), uma razão \(P/(bh^2)\)) e
linprog deixa de servir: aí é minimize com SLSQP, como nos três
exemplos anteriores. Para o caso intermediário, linear mas com
variáveis obrigatoriamente inteiras (“não posso produzir 20,3 reatores”),
o linprog aceita integrality, e o problema passa a ser de
programação inteira, bem mais caro de resolver.
Bônus: Visualizando a Trajetória do Otimizador #
minimize aceita um parâmetro callback: uma função chamada a cada
iteração, recebendo o ponto atual. É a chance de ver, não só o
resultado final, mas o caminho que o otimizador percorreu, algo que
não existe no mundo do SymPy, onde solve devolve a resposta direto,
sem rastro de busca nenhum. Reaproveitando o reator como pano de fundo:
import numpy as np
from scipy.optimize import minimize


R = 8.314  # J/(mol.K)
Ea = 50000.0  # J/mol
A0 = 5e6  # 1/min


def k_arrhenius(T):
    return A0 * np.exp(-Ea / (R * T))


def conversao(T, tau):
    kk = k_arrhenius(T)
    return kk * tau / (1 + kk * tau)


bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0  # R$/min à conversão completa
c_v = 5.0      # R$/min por minuto de tempo de residência (capital)
c_e = 0.5      # R$/min por kelvin acima de T_ref (energia)


def lucro_liquido(T, tau):
    return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)


def menos_lucro(v):
    T, tau = v
    return -lucro_liquido(T, tau)


trajetoria = [np.array([340.0, 2.0])]


def registra_passo(xk):
    trajetoria.append(np.copy(xk))


res_callback = minimize(
    menos_lucro, x0=[340.0, 2.0], method="SLSQP", bounds=bounds_reator, callback=registra_passo
)
traj = np.array(trajetoria)
print(len(traj), "passos registrados")
13 passos registradosimport matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize
R = 8.314 # J/(mol.K)
Ea = 50000.0 # J/mol
A0 = 5e6 # 1/min
def k_arrhenius(T):
return A0 * np.exp(-Ea / (R * T))
def conversao(T, tau):
kk = k_arrhenius(T)
return kk * tau / (1 + kk * tau)
bounds_reator = [(280, 500), (0.01, 50)]
T_ref = 300.0
valor = 100.0 # R$/min à conversão completa
c_v = 5.0 # R$/min por minuto de tempo de residência (capital)
c_e = 0.5 # R$/min por kelvin acima de T_ref (energia)
def lucro_liquido(T, tau):
return valor * conversao(T, tau) - c_v * tau - c_e * (T - T_ref)
def menos_lucro(v):
T, tau = v
return -lucro_liquido(T, tau)
trajetoria = [np.array([340.0, 2.0])]
def registra_passo(xk):
trajetoria.append(np.copy(xk))
res_callback = minimize(
menos_lucro, x0=[340.0, 2.0], method="SLSQP", bounds=bounds_reator, callback=registra_passo
)
traj = np.array(trajetoria)
T_grid = np.linspace(300, 450, 300)
tau_grid = np.linspace(0.1, 10, 300)
TT, TAU = np.meshgrid(T_grid, tau_grid)
NET = lucro_liquido(TT, TAU)
fig, ax = plt.subplots()
cf = ax.contourf(TT, TAU, NET, levels=50, cmap="viridis")
fig.colorbar(cf, ax=ax, label="lucro líquido (R$/min)")
ax.plot(traj[:, 0], traj[:, 1], "o-", color="white", markeredgecolor="black", linewidth=1.5,
markersize=6, label="trajetória do otimizador")
ax.plot(*traj[0], "s", color="red", markersize=12, markeredgecolor="black", label="chute inicial")
ax.plot(*res_callback.x, "*", color="yellow", markersize=18, markeredgecolor="black", label="ótimo")
ax.set_xlabel("T (K)")
ax.set_ylabel(r"$\tau$ (min)")
ax.legend()Sobrepondo a trajetória ao mesmo mapa de contorno do lucro:
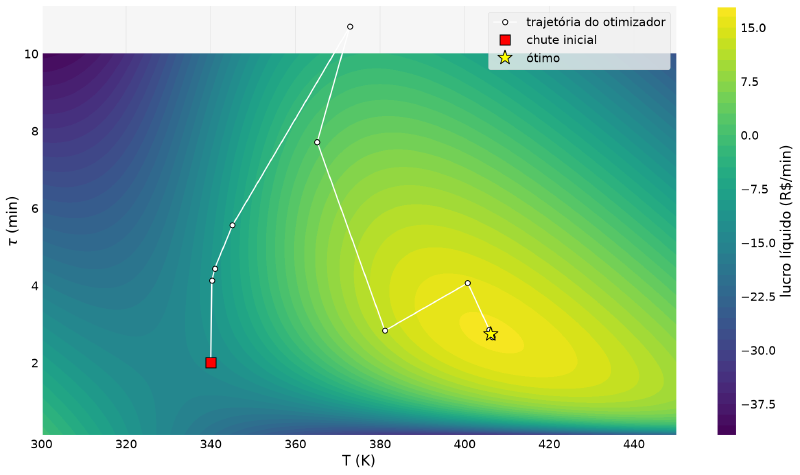
A trajetória está longe de ser uma linha reta até o pico: o otimizador
chega a subir \(\tau\) até \(10{,}7\) min (bem além do valor ótimo,
\(2{,}74\) min) antes de corrigir o rumo. SLSQP resolve, a cada
passo, uma aproximação quadrática local do problema; quando essa
aproximação erra a mão longe do ótimo, o passo seguinte pode
“ultrapassar” bastante antes de as iterações se estabilizarem. O
resultado final está correto, mas o caminho até ele raramente é óbvio.
Tabela-Resumo #
| Aplicação | Ferramenta principal | Restrições usadas |
|---|---|---|
| Reator CSTR (química) | minimize com SLSQP |
Nenhuma (ótimo econômico); 'ineq' (limite de segurança) |
| Alcance de projétil (física) | minimize_scalar + solve_ivp |
bounds no ângulo; função-objetivo sem fórmula fechada |
| Viga (engenharia) | minimize com SLSQP |
Três 'ineq' simultâneas (tensão, flecha, esbeltez) |
| Mix de produção (pesquisa operacional) | linprog (HiGHS) |
A_ub/b_ub: objetivo e restrições todos lineares |
| Trajetória de busca | callback em minimize |
Nenhuma |
| Conceito | Observação |
|---|---|
| Maximizar via \(-f\) | scipy.optimize só minimiza. Funções menos_alguma_coisa e sinais negativos soltos são esse truque, não erro, e o - tem que aparecer duas vezes: ao definir o objetivo e ao ler res.fun |
| Maximizar sem custo | Sem trade-off, a solução tende a um canto dos bounds; nem sempre é a pergunta certa |
Restrição de segurança como constraints |
Distingue uma limitação de processo real de um limite arbitrário de busca |
| Restrição binding × com folga | Numa solução com várias restrições, checar quais estão exatamente no limite e quais sobram |
bounds × constraints |
Não é só semântica: bounds garante que a função nunca é avaliada fora da caixa; constraints permite excursões. Use bounds quando a função não existe do lado de fora |
| Fronteira de Pareto | Quando há mais de um critério, o resultado honesto não é um ponto, e sim a curva dos compromissos eficientes |
linprog × minimize |
Tudo linear → linprog, mais rápido e com ótimo global certificado. Um único termo não-linear → minimize |
slack do linprog |
Diz quais recursos estão esgotados (folga zero) e quais sobram; é onde está a leitura gerencial da resposta |
| Robustez a múltiplos chutes | Convergir para o mesmo ponto a partir de chutes diferentes é evidência de ótimo único |
callback |
Expõe o caminho percorrido pelo otimizador, não só o resultado final |
Próximos Passos #
As quatro aplicações deste artigo cobrem otimização com restrições de igualdade, de desigualdade, funções-objetivo baseadas em EDOs, múltiplas restrições simultâneas e programação linear. Em todas elas, porém, os parâmetros do modelo eram dados: a energia de ativação do reator, o coeficiente de arrasto do projétil, o módulo de elasticidade da viga.
No laboratório é o contrário. Esses parâmetros são justamente o que se quer descobrir, e o que se tem é um punhado de medidas ruidosas. O próximo artigo trata desse caso, que é, ele próprio, um problema de otimização disfarçado, e responde à pergunta que a série vinha adiando: como acompanhar cada parâmetro ajustado da sua barra de erro.