Peça ao SymPy para integrar \(e^{-x^2}\) e ele não vai reclamar, não vai
travar, não vai devolver erro. Vai responder sqrt(pi)*erf(x)/2, e essa
resposta, por mais que pareça uma evasiva, é a coisa mais honesta que ele
poderia dizer.
Porque \(\int e^{-x^2}dx\) não tem primitiva elementar. Não existe combinação finita de polinômios, exponenciais, logaritmos, senos e cossenos cuja derivada seja \(e^{-x^2}\). E isso não é uma limitação do SymPy, nem um problema em aberto esperando alguém esperto o bastante: é um teorema, provado por Joseph Liouville na década de 1830. A primitiva existe (toda função contínua tem uma); ela só não é escrevível com o alfabeto de funções que se aprende no ensino médio.
O que o SymPy fez foi dar um nome a ela: erf, a função erro. É uma
resposta útil, mas repare no que aconteceu com a pergunta original. Se
alguém quer saber quanto vale \(\int_0^1 e^{-x^2}dx\) (um número, para
colocar num relatório), a resposta sqrt(pi)*erf(1)/2 apenas empurrou o
problema para dentro de um símbolo novo. Em algum momento, alguém vai ter
que calcular.
Este artigo é sobre esse momento.
Por Que Integração Numérica Importa? #
- Química e termodinâmica: variação de entalpia (\(\int C_p dT\)), trabalho de expansão (\(\int P dV\)), grau de avanço de reação. A maior parte das grandezas termodinâmicas é uma integral, e os dados de \(C_p\) e \(P\) raramente vêm em forma que se integre no papel.
- Física e engenharia: centro de massa, momento de inércia, trabalho, fluxo através de uma superfície, carga acumulada. São todas integrais, e quase sempre de funções que só existem como resultado de uma medição ou de outra simulação.
- Probabilidade e estatística: praticamente toda probabilidade é a área sob uma densidade. E a densidade normal, \(\propto e^{-x^2/2}\), tem a mesma forma da \(e^{-x^2}\) que abre este artigo (a menos de uma reescala de \(x\)), e por isso não tem primitiva elementar: as tabelas \(z\) existem desde antes dos computadores.
- Dados experimentais: integrar um pico cromatográfico para obter concentração, uma curva de potência para obter energia consumida, uma velocidade para obter distância. Aqui não há função nenhuma para integrar simbolicamente: há uma tabela de números.
Recapitulando o Essencial da Integração Simbólica #
O artigo de integrais com SymPy
mostrou o sympy.integrate resolvendo integrais indefinidas e definidas de
forma exata. Vale relembrar o essencial, porque é contra isso que a
abordagem numérica se define:
import sympy as sp

x = sp.symbols("x")
print(sp.integrate(x**2, x))            # x**3/3
print(sp.integrate(sp.sin(x), (x, 0, sp.pi)))   # 2
Quando a primitiva existe e o SymPy a encontra, use o SymPy. Uma resposta exata é melhor que qualquer aproximação, e ela ainda pode ser derivada, simplificada ou combinada com outras expressões. A integração numérica não é uma alternativa mais moderna à simbólica: é o que se faz quando a simbólica não está disponível.
E ela deixa de estar disponível em três situações bem distintas, que este artigo percorre nessa ordem:
| Situação | Exemplo | Por que o SymPy não resolve |
|---|---|---|
| A primitiva não existe em termos elementares | \(\int e^{-x^2}dx\) | Teorema de Liouville: não é limitação de software |
| A primitiva existe mas é inútil na prática | Integrandos longos, com dezenas de termos | O resultado é uma expressão que ninguém consegue ler, e avaliá-la numericamente é mais caro que integrar direto |
| Não há função nenhuma | Uma tabela de medições | Não existe expressão para integrar; só existem números |
A Integral Que Não Fecha #
Comecemos pelo caso em que a impossibilidade é demonstrável. O SymPy recebe \(e^{-x^2}\) e responde:
import sympy as sp

x = sp.symbols("x")
primitiva = sp.integrate(sp.exp(-(x**2)), x)
print("primitiva:", primitiva)

definida = sp.integrate(sp.exp(-(x**2)), (x, 0, 1))
print("de 0 a 1:", definida, "=", float(definida))
primitiva: sqrt(pi)*erf(x)/2
de 0 a 1: sqrt(pi)*erf(1)/2 = 0.746824132812427Uma função elementar tem primitiva elementar apenas quando ela satisfaz uma condição algébrica bastante restritiva. Funções como \(e^{-x^2}\), \(\frac{\sin x}{x}\), \(\frac{1}{\ln x}\) e \(\sqrt{1 - k^2\sin^2 x}\) provadamente não a satisfazem.
“Elementar”, aqui, é um termo técnico: são as funções construíveis a partir de polinômios, exponenciais e logaritmos por um número finito de somas, produtos, quocientes e composições, o que inclui as trigonométricas, que são exponenciais disfarçadas.
A consequência importante é filosófica: quando o SymPy devolve erf, ele
não falhou. Ele encontrou a resposta certa, e a resposta certa é que
essa primitiva precisa de um nome novo. É o mesmo movimento que fez
\(\sqrt{2}\) ganhar um símbolo próprio quando ficou provado que ela não
é razão de inteiros.
E a erf não é uma função arbitrária. Ela é, a menos de uma normalização,
exatamente a área acumulada sob a gaussiana:
O fator \(2/\sqrt{\pi}\) existe para que \(\mathrm{erf}\) tenda a \(1\) quando \(x \to \infty\), o que a torna conveniente em probabilidade. Os dois gráficos a seguir mostram a relação entre as duas funções, a curva e a área que ela acumula:
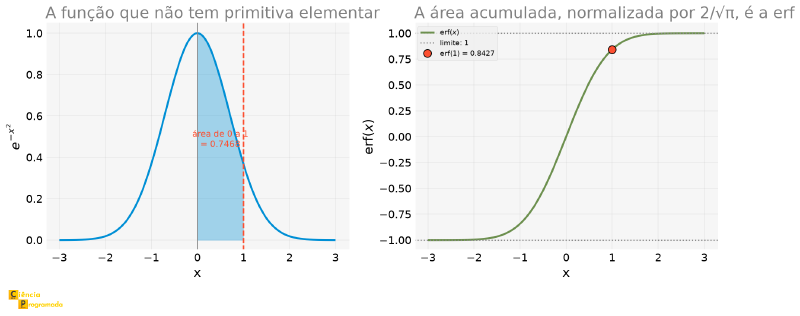
Repare no painel da direita. A erf é uma função perfeitamente bem
comportada: suave, monótona, limitada entre \(-1\) e \(1\). Não há
nada de patológico nela. O que não existe é uma fórmula fechada para
ela em termos elementares. É por isso que a erf vive em
scipy.special, ao lado de dezenas de outras funções que nasceram do mesmo
jeito: como nome para uma integral que ninguém consegue escrever de outro
modo.
E o número que interessa sai do jeito numérico, direto:
import numpy as np
import sympy as sp
from scipy import integrate

x = sp.symbols("x")
definida = sp.integrate(sp.exp(-(x**2)), (x, 0, 1))

valor, erro = integrate.quad(lambda t: np.exp(-(t**2)), 0, 1)
print(f"quad: {valor!r}")
print(f"estimativa de erro: {erro:.3e}")
print(f"diferença para o valor simbólico: {abs(valor - float(definida)):.2e}")
quad: 0.7468241328124271
estimativa de erro: 8.291e-15
diferença para o valor simbólico: 1.11e-16Uma linha, quinze dígitos corretos.
quad: a Integração e a Estimativa do Próprio Erro
#
O scipy.integrate.quad é a ferramenta padrão para integrar uma função de
uma variável. Ele implementa quadratura adaptativa: a biblioteca
QUADPACK, escrita em Fortran no início dos anos 1980, que o quad do SciPy
usa por baixo.
“Quadratura” é o nome clássico para integração numérica, vem do problema grego de construir um quadrado com a mesma área de uma figura dada.
Adaptativa é a parte interessante. Em vez de fatiar o intervalo em pedaços iguais, o método estima o erro em cada pedaço e subdivide apenas onde o erro é grande. Um trecho em que a função é quase reta é resolvido com poucas avaliações; um trecho onde ela oscila recebe subdivisão até que a estimativa de erro caia abaixo da tolerância.
É a mesma ideia do passo adaptativo que o solve_ivp usa em equações
diferenciais: gastar esforço onde o problema é difícil, e não onde ele é
fácil.
O que distingue o quad de somar retângulos na mão é o segundo valor de
retorno: uma estimativa do próprio erro. Poucos métodos numéricos
oferecem isso, e é o que permite confiar no resultado sem conhecer a
resposta de antemão:
import numpy as np
from scipy import integrate

casos = [
    ("exp(-x²) em [0, 1]", lambda t: np.exp(-(t**2)), 0.0, 1.0, 0.746824132812427),
    ("sen(x) em [0, π]",   np.sin,                    0.0, np.pi, 2.0),
    ("1/x em [1, 10]",     lambda t: 1 / t,           1.0, 10.0, np.log(10)),
]

print(f"{'integral':>22} {'quad':>14} {'erro estimado':>14} {'erro real':>12}")
for nome, f, a, b, exato in casos:
    v, e = integrate.quad(f, a, b)
    print(f"{nome:>22} {v:>14.10f} {e:>14.2e} {abs(v - exato):>12.2e}")
integral quad erro estimado erro real
exp(-x²) em [0, 1] 0.7468241328 8.29e-15 1.11e-16
sen(x) em [0, π] 2.0000000000 2.22e-14 0.00e+00
1/x em [1, 10] 2.3025850930 1.75e-08 6.22e-15Compare as duas últimas colunas. Em todos os casos a estimativa de erro é conservadora: ela é maior que o erro real, às vezes por várias ordens de grandeza. Isso é de propósito: uma estimativa que subestimasse o erro seria muito pior que uma que o exagera. Trate o segundo valor como um limite superior, não como uma medida.
De Onde Saem Trapézio e Simpson #
O quad resolve o problema, mas resolve como uma caixa-preta. Vale abrir a
caixa, porque as duas regras clássicas de integração são geometricamente
simples e explicam a estrutura de erro de tudo o que vem depois.
As duas partem da mesma ideia: se eu não sei integrar \(f\), eu integro algo parecido com \(f\) que eu saiba integrar. A diferença está no que se usa como “algo parecido”:
| Regra | Aproxima a função por | Erro |
|---|---|---|
| Trapézio | uma reta ligando cada par de nós vizinhos | \(O(h^2)\) |
| Simpson | uma parábola passando por cada trio de nós | \(O(h^4)\) |
Com \(h\) a largura de cada subintervalo. A figura a seguir desenha as duas construções sobre a mesma função, com apenas dois subintervalos para que a diferença fique visível:
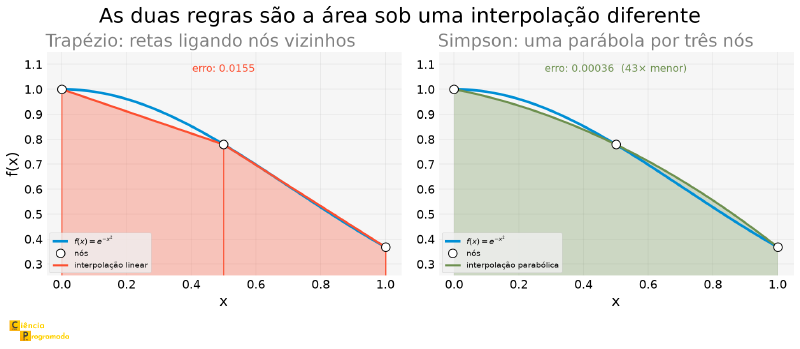
Repare no detalhe que faz toda a diferença: as duas regras usam exatamente os mesmos três pontos. O custo é o mesmo: três avaliações da função. O que muda é o que se faz com eles. E o ganho é de quarenta e três vezes.
Pode parecer que ajustar uma parábola seria mais caro que ligar dois pontos por uma reta. Não é. A regra de Simpson, depois de feitas as contas, é uma média ponderada dos valores nos nós:
$$\int_{x_0}^{x_2} f(x) dx \approx \frac{h}{3}\left[f(x_0) + 4f(x_1) + f(x_2)\right]$$Os coeficientes \(1, 4, 1\) já são o resultado de integrar a parábola. Ninguém precisa resolver um sistema para achá-la em tempo de execução: a fórmula fechada foi derivada uma vez (Kepler já a usava em 1615, e Simpson a popularizou no século XVIII) e vale para sempre. É a mesma economia da regra do trapézio, cujos pesos são \(1, 1\).
A Diferença Entre \(O(h^2)\) e \(O(h^4)\) #
Os expoentes na tabela acima não são decoração. Eles dizem exatamente quanto se ganha ao gastar mais pontos, e a diferença entre \(2\) e \(4\) é grande:
import numpy as np
from scipy import integrate


def f_teste(t):
    return np.exp(-(t**2))


A_EXATA = 0.746824132812427

print(f"{'n':>6} {'h':>10} {'erro trapézio':>15} {'erro Simpson':>14}")
for n in (4, 8, 16, 32, 64, 128, 256):
    xs = np.linspace(0, 1, n + 1)
    ys = f_teste(xs)
    e_trap = abs(integrate.trapezoid(ys, xs) - A_EXATA)
    e_simp = abs(integrate.simpson(ys, x=xs) - A_EXATA)
    print(f"{n:>6} {xs[1] - xs[0]:>10.5f} {e_trap:>15.2e} {e_simp:>14.2e}")
n h erro trapézio erro Simpson
4 0.25000 3.84e-03 3.12e-05
8 0.12500 9.59e-04 1.99e-06
16 0.06250 2.40e-04 1.25e-07
32 0.03125 5.99e-05 7.79e-09
64 0.01562 1.50e-05 4.87e-10
128 0.00781 3.74e-06 3.05e-11
256 0.00391 9.36e-07 1.90e-12Olhe as razões entre linhas consecutivas. Cada vez que \(n\) dobra (e portanto \(h\) cai pela metade), o erro do trapézio cai por 4 (\(=2^2\)) e o de Simpson por 16 (\(=2^4\)):
import numpy as np
from scipy import integrate


def f_teste(t):
    return np.exp(-(t**2))


A_EXATA = 0.746824132812427

erros_trap, erros_simp = [], []
for n in (4, 8, 16, 32, 64, 128, 256):
    xs = np.linspace(0, 1, n + 1)
    ys = f_teste(xs)
    erros_trap.append(abs(integrate.trapezoid(ys, xs) - A_EXATA))
    erros_simp.append(abs(integrate.simpson(ys, x=xs) - A_EXATA))
erros_trap, erros_simp = np.array(erros_trap), np.array(erros_simp)

print("razão entre erros consecutivos:")
print("  trapézio (esperado 4  = 2²):", np.round(erros_trap[:-1] / erros_trap[1:], 2))
print("  Simpson  (esperado 16 = 2⁴):", np.round(erros_simp[:-1] / erros_simp[1:], 2))
razão entre erros consecutivos:
trapézio (esperado 4 = 2²): [4.01 4. 4. 4. 4. 4. ]
Simpson (esperado 16 = 2⁴): [15.72 15.95 15.99 16. 16. 16. ]Essa é a mesma leitura de ordem de erro que o artigo de derivadas numéricas fez para as diferenças finitas, e vale conferir o padrão em log-log, onde uma lei de potência vira uma reta:
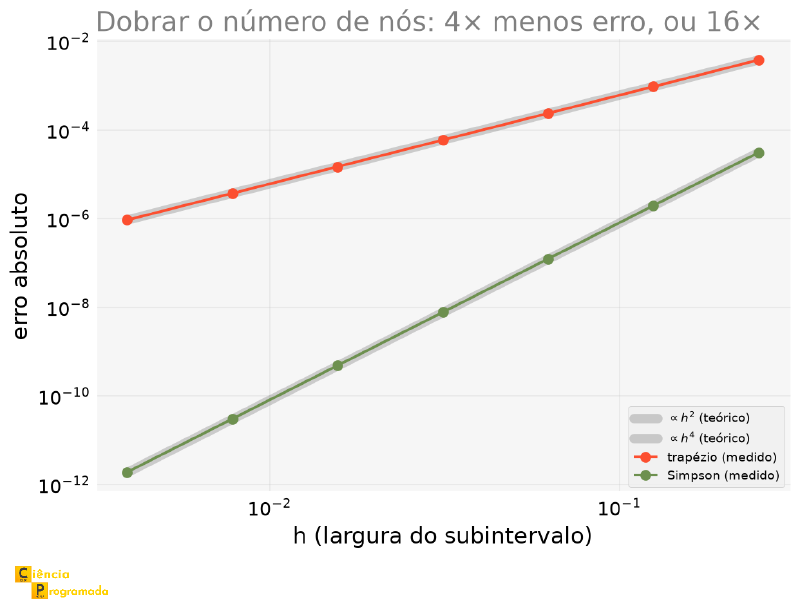
A tabela acima é limpa porque a função é suave e o intervalo é bem escolhido. Com poucos nós, e num intervalo que contenha um ponto de inflexão, Simpson pode sair pior que o trapézio.
No caso de \(e^{-x^2}\), a inflexão está em \(x = 1/\sqrt{2} \approx 0{,}707\). Integrando em \([0, 2]\) com apenas dois subintervalos, a parábola tenta acompanhar uma curvatura que troca de sinal no meio do caminho, e o erro de Simpson fica dez vezes maior que o do trapézio: \(0{,}052\) contra \(0{,}005\).
A ordem \(O(h^4)\) é um resultado assintótico: ela descreve o que
acontece quando \(h\) fica pequeno o bastante, não uma garantia para
qualquer \(h\). É por isso que o quad adaptativo é a escolha padrão:
ele subdivide até que o comportamento assintótico valha de fato, em vez
de confiar numa malha fixa escolhida a esmo.
Infinitos e Picos: Onde o quad Brilha e Onde Ele Falha
#
Limites Infinitos #
np.inf é aceito como limite de integração, e o quad faz internamente
uma troca de variável que traz o infinito para um intervalo finito:
import numpy as np
from scipy import integrate

v_inf, e_inf = integrate.quad(lambda t: np.exp(-(t**2)), -np.inf, np.inf)
print(f"∫ e^(-x²) dx em toda a reta = {v_inf:.12f}")
print(f"                    √π      = {np.sqrt(np.pi):.12f}")
∫ e^(-x²) dx em toda a reta = 1.772453850906
√π = 1.772453850906Doze dígitos corretos numa integral sobre a reta inteira. Vale notar o que isso significa na prática: não trunque a cauda na mão. A tentação de integrar de \(-10\) a \(10\) “porque o resto é desprezível” troca um resultado exato por um erro que você não controlou. A figura a seguir quantifica esse erro para a exponencial decrescente:
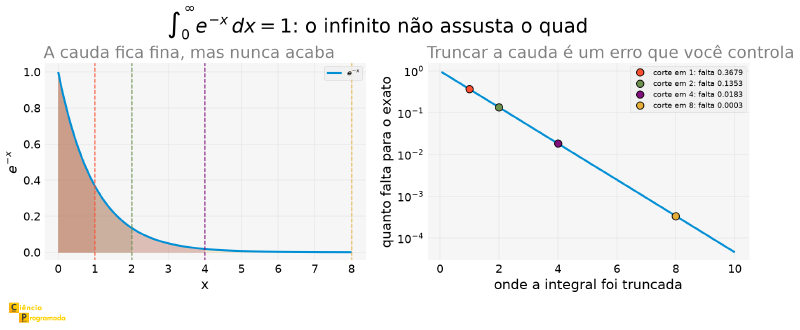
Truncar em \(x = 1\) perde \(37\%\) da integral; em \(x = 2\), ainda \(13{,}5\%\); só em \(x = 8\) o erro cai para \(0{,}03\%\). São números grandes demais para um “desprezível” estimado no olho.
O Pico Que o quad Não Vê
#
Toda essa competência tem um limite, e ele é importante o bastante para merecer o susto:
quad pode devolver zero com erro estimado zero
A quadratura adaptativa decide onde subdividir a partir do que ela já viu. Se a primeira amostragem do intervalo não encostar na região onde a função é diferente de zero, não há erro grande para detectar, e o algoritmo conclui, com toda a confiança, que a integral é nula.
import numpy as np
from scipy import integrate

LARGURA = 1e-4
f_pico = lambda t: np.exp(-((t - 0.7) / LARGURA) ** 2)  # pico estreitíssimo em 0,7
area_exata = LARGURA * np.sqrt(np.pi)

for kwargs, rotulo in (
    ({}, "quad simples"),
    ({"points": [0.7]}, "points=[0.7]"),
    ({"points": [0.7 - 10 * LARGURA, 0.7 + 10 * LARGURA]}, "points cercando o pico"),
):
    v, e = integrate.quad(f_pico, 0, 1, **kwargs)
    erro_real = abs(v - area_exata) / area_exata * 100
    print(f"{rotulo:>24}: {v:.6e}  erro estimado {e:.1e}  erro REAL {erro_real:7.3f}%")
print(f"{'exato':>24}: {area_exata:.6e}")
quad simples: 0.000000e+00 erro estimado 0.0e+00 erro REAL 100.000%
points=[0.7]: 6.524753e-22 erro estimado 1.3e-21 erro REAL 100.000%
points cercando o pico: 1.772454e-04 erro estimado 1.8e-10 erro REAL 0.000%
exato: 1.772454e-04A primeira linha é o pesadelo: resultado \(0\), erro estimado \(0\). Confiança total numa resposta cem por cento errada.
A segunda linha mostra que a correção óbvia não basta. O parâmetro
points diz ao quad onde quebrar o intervalo, mas quebrar
exatamente em \(0{,}7\) coloca o pico na borda dos dois
subintervalos, e os nós de Gauss-Kronrod são pontos interiores de cada
painel: nenhum cai exatamente na borda, e o mais próximo dela ainda fica
longe demais para enxergar um pico tão estreito. O pico continua invisível.
A terceira linha é o uso correto: points cercando a região de
interesse, não apontando para ela. Aí o pico cai no meio de um
subintervalo e o erro vai a zero.
A moral prática: conheça sua função antes de integrá-la. Um gráfico rápido do integrando custa segundos e revela qualquer estrutura fina que a quadratura pudesse pular. Nenhum algoritmo adaptativo consegue encontrar o que nunca amostrou.
Uma Família de Integrais de Uma Vez #
Quando o integrando devolve um vetor em vez de um escalar, quad_vec
resolve todas as componentes de uma vez, compartilhando as avaliações:
import numpy as np
from scipy import integrate

alphas = np.array([0.5, 1.0, 2.0, 4.0])
res, err = integrate.quad_vec(lambda t: np.exp(-alphas * t**2), 0, np.inf)

for a, v in zip(alphas, res):
    print(f"a={a:4.1f}: {v:.10f}   √(π/a)/2 = {np.sqrt(np.pi / a) / 2:.10f}")
a= 0.5: 1.2533141373 √(π/a)/2 = 1.2533141373
a= 1.0: 0.8862269255 √(π/a)/2 = 0.8862269255
a= 2.0: 0.6266570687 √(π/a)/2 = 0.6266570687
a= 4.0: 0.4431134627 √(π/a)/2 = 0.4431134627Integrando Uma Tabela: Não Há Função Para Integrar #
Os casos anteriores tinham pelo menos uma função. Agora o caso mais comum no laboratório: só existem números. Um cromatógrafo registrou sinal contra tempo; um datalogger registrou potência contra tempo; um cronômetro registrou posição contra tempo. Não há expressão para derivar nem para integrar: há uma tabela.
Aqui trapezoid e simpson deixam de ser curiosidade didática e passam a
ser a única opção, porque trabalham diretamente sobre arrays:
| Função | O que faz |
|---|---|
integrate.trapezoid(y, x) |
Regra do trapézio sobre os pontos dados |
integrate.simpson(y, x=x) |
Regra de Simpson sobre os pontos dados |
integrate.cumulative_trapezoid(y, x, initial=0) |
A integral acumulada, devolve um array, não um número |
Nenhuma delas aceita espaçamento arbitrário como problema: o vetor x pode
ser irregular, o que é o normal em dados reais.
Fechando o Círculo: a Corrida de Usain Bolt #
O artigo de derivadas numéricas pegou os tempos de passagem de Usain Bolt na final de Berlim (2009), a posição a cada \(10\) m, e derivou para estimar a velocidade instantânea. Agora fazemos o caminho de volta: integrar essa velocidade deve reconstruir a posição, e a integral sobre a prova inteira tem de dar \(100\) m.
Vejamos se dá:
import numpy as np
from scipy import integrate

distancia_bolt = np.arange(0, 101, 10)  # m, splits de 10 em 10
tempo_bolt = np.array([0, 1.89, 2.88, 3.78, 4.64, 5.47,
                       6.29, 7.10, 7.92, 8.75, 9.58])  # s

velocidade_bolt = np.gradient(distancia_bolt, tempo_bolt)   # do artigo anterior

dist_trap = integrate.trapezoid(velocidade_bolt, tempo_bolt)
dist_simp = integrate.simpson(velocidade_bolt, x=tempo_bolt)
print(f"distância real: 100 m")
print(f"  integrando a velocidade (trapézio): {dist_trap:.3f} m")
print(f"  integrando a velocidade (Simpson):  {dist_simp:.3f} m")
distância real: 100 m
integrando a velocidade (trapézio): 102.230 m
integrando a velocidade (Simpson): 102.055 mNão dá: sobram \(2{,}23\) m, mais de dois por cento, num percurso cujos dois extremos são conhecidos exatamente.
Esse é o tipo de resultado que vale mais que um fechamento perfeito, porque
ele tem uma causa localizável. Usando cumulative_trapezoid para ver onde
o erro nasce:
import numpy as np
from scipy import integrate

distancia_bolt = np.arange(0, 101, 10)  # m, splits de 10 em 10
tempo_bolt = np.array([0, 1.89, 2.88, 3.78, 4.64, 5.47,
                       6.29, 7.10, 7.92, 8.75, 9.58])  # s

velocidade_bolt = np.gradient(distancia_bolt, tempo_bolt)   # do artigo anterior

dist_cum = integrate.cumulative_trapezoid(velocidade_bolt, tempo_bolt, initial=0)
for t, medida, integrada in zip(tempo_bolt, distancia_bolt, dist_cum):
    print(f"t={t:5.2f}s  medida={medida:5.1f} m  integrada={integrada:7.3f} m"
          f"  diferença={integrada - medida:+6.3f} m")
t= 0.00s medida= 0.0 m integrada= 0.000 m diferença=+0.000 m
t= 1.89s medida= 10.0 m integrada= 12.983 m diferença=+2.983 m
t= 2.88s medida= 20.0 m integrada= 22.426 m diferença=+2.426 m
t= 3.78s medida= 30.0 m integrada= 32.329 m diferença=+2.329 m
t= 4.64s medida= 40.0 m integrada= 42.312 m diferença=+2.312 m
t= 5.47s medida= 50.0 m integrada= 52.257 m diferença=+2.257 m
t= 6.29s medida= 60.0 m integrada= 62.258 m diferença=+2.258 m
t= 7.10s medida= 70.0 m integrada= 72.198 m diferença=+2.198 m
t= 7.92s medida= 80.0 m integrada= 82.199 m diferença=+2.199 m
t= 8.75s medida= 90.0 m integrada= 92.230 m diferença=+2.230 m
t= 9.58s medida=100.0 m integrada=102.230 m diferença=+2.230 mA coluna da direita entrega o culpado. O erro inteiro, quase três metros, aparece já no primeiro trecho, entre o tiro e a marca de \(10\) m. Depois disso, ele praticamente não muda: a diferença oscila entre \(2{,}20\) e \(2{,}43\) m até o fim da prova.
E o motivo está na velocidade estimada no instante zero:
import numpy as np

distancia_bolt = np.arange(0, 101, 10)  # m, splits de 10 em 10
tempo_bolt = np.array([0, 1.89, 2.88, 3.78, 4.64, 5.47,
                       6.29, 7.10, 7.92, 8.75, 9.58])  # s

velocidade_bolt = np.gradient(distancia_bolt, tempo_bolt)   # do artigo anterior

print("velocidade estimada em cada marca (m/s):", np.round(velocidade_bolt, 2))
velocidade estimada em cada marca (m/s): [ 5.29 8.45 10.63 11.38 11.84 12.12 12.27 12.27 12.12 12.05 12.05]\(5{,}29\) m/s no início da prova. Mas Bolt parte do repouso: a
velocidade real em \(t = 0\) é exatamente zero. O np.gradient, na
borda do array, não tem ponto à esquerda para fazer uma diferença central,
e cai numa diferença unilateral, de primeira ordem, sobre um intervalo
de \(1{,}89\) s. Justamente o trecho em que o atleta acelera com a maior
intensidade de toda a corrida. A estimativa devolve algo próximo da
velocidade média do trecho, não da inicial, e integrar essa média a
partir de \(t = 0\) infla a área.
A figura mostra os dois lados do problema:
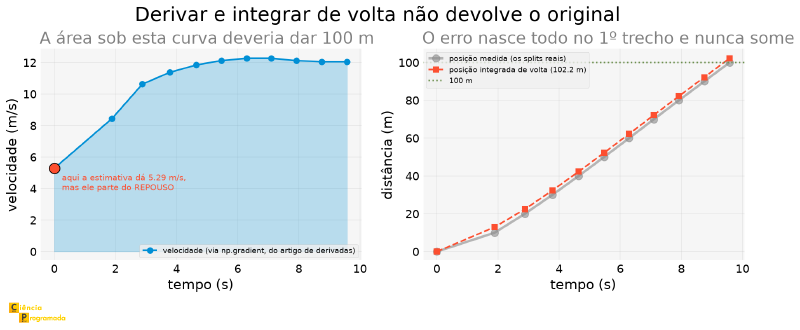
O que acabou de acontecer vale como regra geral, porque é uma armadilha comum em processamento de dados.
No cálculo, o teorema fundamental garante que derivar e integrar são operações inversas. Numericamente, não são. Cada uma introduz seu próprio erro, e os erros não se cancelam: eles se somam.
Pior: a integração é uma operação acumulativa. Um erro cometido no primeiro ponto não fica no primeiro ponto: ele é carregado, inalterado, por todo o resto do cálculo. Foi exatamente o que se viu na tabela: o desvio de \(+2{,}98\) m nasceu no primeiro trecho e nunca mais saiu.
Quando você precisar dos dois, prefira medir a grandeza que interessa a derivá-la ou integrá-la a partir de outra. E se não houver escolha, use as condições de contorno que você conhece (aqui, \(v(0) = 0\)) como checagem, não como conserto: forçar \(v(0) = 0\) neste caso leva o resultado a \(97{,}23\) m, errando para o outro lado. Os dados são grosseiros demais no arranque para que qualquer ajuste pontual resolva.
Química: Duas Integrais do Dia a Dia #
Nos dois exemplos a seguir, a integral é a definição da grandeza que se quer, e não um exercício.
Variação de Entalpia: \(\int C_p dT\) #
A capacidade calorífica de um gás não é constante: ela cresce com a temperatura, e tabelas de referência dão \(C_p\) como um polinômio em \(T\). O calor necessário para aquecer um mol de \(T_1\) a \(T_2\) a pressão constante é
$$ \Delta H = \int_{T_1}^{T_2} C_p(T) dT $$
Exemplo 1: Aquecendo CO₂ de 25 °C a 727 °C
Enunciado: Para o \(CO_2\) gasoso, \(C_p(T) = 22{,}243 + 5{,}977\times10^{-2}\ T - 3{,}499\times10^{-5}\ T^2\) em J/(mol·K), com \(T\) em kelvin. Calcule \(\Delta H\) ao aquecer de \(298{,}15\) K a \(1000\) K.
Solução:
from scipy import integrate


def cp_co2(T):
    return 22.243 + 5.977e-2 * T - 3.499e-5 * T**2


delta_H, err = integrate.quad(cp_co2, 298.15, 1000.0)
print(f"ΔH = {delta_H:.1f} J/mol = {delta_H / 1000:.2f} kJ/mol")
print(f"erro estimado: {err:.1e} J/mol")
ΔH = 31485.5 J/mol = 31.49 kJ/mol
erro estimado: 3.5e-10 J/molEste é um caso em que a primitiva existe e é trivial: é um polinômio de grau 3. Vale conferir contra o SymPy:
import sympy as sp

T = sp.symbols("T")
cp_sym = 22.243 + 5.977e-2 * T - 3.499e-5 * T**2
print("SymPy:", float(sp.integrate(cp_sym, (T, 298.15, 1000.0))))
SymPy: 31485.45630238881Concordância até o último dígito. Quando as duas rotas estão disponíveis, usar as duas é a forma mais barata de validação que existe.
O interesse aqui está na comparação com o atalho que todo curso de graduação ensina primeiro, que é supor \(C_p\) constante, avaliado na temperatura inicial:
from scipy import integrate


def cp_co2(T):
    return 22.243 + 5.977e-2 * T - 3.499e-5 * T**2


delta_H, _ = integrate.quad(cp_co2, 298.15, 1000.0)

delta_H_constante = cp_co2(298.15) * (1000.0 - 298.15)
print(f"supondo Cp constante em {cp_co2(298.15):.2f} J/(mol·K): "
      f"{delta_H_constante / 1000:.2f} kJ/mol")
print(f"erro da aproximação: {(delta_H_constante - delta_H) / delta_H * 100:+.1f}%")
supondo Cp constante em 36.95 J/(mol·K): 25.94 kJ/mol
erro da aproximação: -17.6%Quase dezoito por cento para menos. Numa faixa de \(700\) K, o \(C_p\) do \(CO_2\) cresce o bastante para que congelá-lo no valor inicial deixe de ser aproximação e passe a ser erro grosseiro. A integral custa uma linha; a aproximação custa dezoito por cento.
Trabalho de Expansão: \(\int P dV\) #
O trabalho realizado por um gás que se expande reversivelmente é a área sob a curva \(P(V)\):
$$ W = \int_{V_1}^{V_2} P(V) dV $$Para gás ideal, \(P = RT/V\), a primitiva é o logaritmo e o resultado é a fórmula clássica \(W = RT\ln(V_2/V_1)\). Mas o artigo de equações da química e da engenharia mostrou que gases reais em pressões altas não seguem a lei ideal; eles seguem, com muito mais fidelidade, a equação de van der Waals:
$$ P(V) = \frac{RT}{V - b} - \frac{a}{V^2} $$E essa, integrada, também tem primitiva elementar, mas ninguém precisa encontrá-la para obter o número:
Exemplo 2: Expansão isotérmica de CO₂, ideal contra real
Enunciado: Um mol de \(CO_2\) se expande isotermicamente a \(300\) K de \(0{,}1\) para \(2{,}0\) L/mol. Compare o trabalho previsto pelo modelo ideal com o previsto por van der Waals (\(a = 3{,}640\) L²·atm/mol², \(b = 0{,}04267\) L/mol).
Solução:
import numpy as np
from scipy import integrate

R_GAS = 0.082057   # L·atm/(mol·K)
A_VDW, B_VDW = 3.640, 0.04267
T_EXP = 300.0
V1, V2 = 0.1, 2.0


def p_ideal(V):
    return R_GAS * T_EXP / V


def p_vdw(V):
    return R_GAS * T_EXP / (V - B_VDW) - A_VDW / V**2


w_ideal, _ = integrate.quad(p_ideal, V1, V2)
w_vdw, err = integrate.quad(p_vdw, V1, V2)

print(f"gás ideal:     {w_ideal:8.4f} L·atm/mol")
print(f"  (analítico:  {R_GAS * T_EXP * np.log(V2 / V1):8.4f}  = RT ln(V2/V1))")
print(f"van der Waals: {w_vdw:8.4f} L·atm/mol   (erro estimado {err:.1e})")
print(f"diferença: {(w_vdw - w_ideal) / w_ideal * 100:+.1f}%")
gás ideal: 73.7462 L·atm/mol
(analítico: 73.7462 = RT ln(V2/V1))
van der Waals: 52.3310 L·atm/mol (erro estimado 5.2e-07)
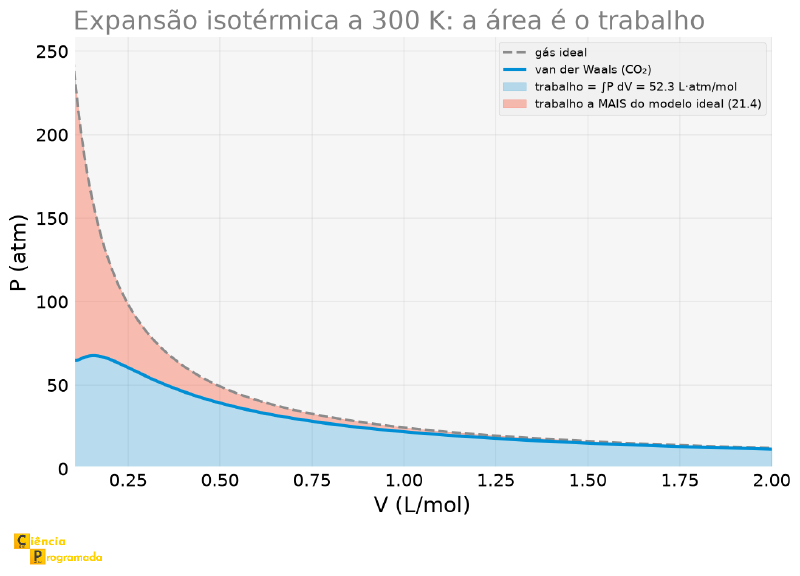
diferença: -29.0%Vinte e nove por cento de diferença. E ela não é um detalhe de modelo: em \(0{,}1\) L/mol o \(CO_2\) está comprimido a ponto de as forças atrativas entre moléculas (o termo \(-a/V^2\)) derrubarem a pressão bem abaixo do que a lei ideal prevê. Menos pressão, menos área, menos trabalho.
O gráfico deixa a diferença literalmente visível como área:
Pontos de Atenção #
As três checagens mais baratas, em ordem de custo:
- Olhe a estimativa de erro. O
quada devolve de graça. Um erro estimado da ordem do próprio resultado é um alerta vermelho. - Plote o integrando. Segundos de trabalho, e revela picos estreitos, singularidades e oscilações que qualquer método adaptativo pode pular.
- Confira contra uma rota independente. Se o SymPy fecha, compare. Se existe um caso-limite conhecido (o gás ideal, aqui), compare com ele.
A regra de Simpson consome os nós de três em três, com sobreposição,
o que exige um número par de subintervalos (ou seja, um número ímpar
de pontos). Com um número ímpar de subintervalos, o
scipy.integrate.simpson não levanta erro: ele aplica uma correção no
último intervalo, que tem ordem de erro menor que o resto. O resultado
continua utilizável, mas a convergência \(O(h^4)\) deixa de valer.
Quando a ordem importar, garanta que len(x) seja ímpar.
trapezoid e simpson não estimam erro
Diferentemente do quad, as regras sobre dados tabulados devolvem só o
valor. Não há como pedir a elas uma estimativa de erro, porque não há
como refinar a malha: os dados são o que são. A forma prática de estimar
o erro nesse caso é comparar trapezoid com simpson: se os dois
concordam em muitas casas, a malha é fina o bastante para a curvatura da
função. Foi o que aconteceu com o Bolt (\(102{,}230\) contra
\(102{,}055\)): os dois concordam, e mesmo assim ambos estão a
\(2\%\) do valor certo. Concordância entre métodos atesta que a malha
é suficiente, não que os dados de entrada estão corretos.
Tabela-Resumo #
| Ferramenta | Uso | Observação |
|---|---|---|
sympy.integrate |
Primeira tentativa, sempre | Quando fecha, a resposta exata é melhor que qualquer aproximação |
scipy.integrate.quad |
Integral de uma função de uma variável | Devolve (valor, estimativa_de_erro); a estimativa é conservadora |
quad(..., a, np.inf) |
Integrais impróprias | Melhor que truncar a cauda na mão: o erro de truncamento é grande e evitável |
quad(..., points=[...]) |
Estruturas finas no integrando | Cerque a região crítica, não aponte para ela |
scipy.integrate.quad_vec |
Família de integrais de uma vez | Integrando devolve vetor; compartilha avaliações |
integrate.trapezoid(y, x) |
Dados tabulados | Erro \(O(h^2)\); aceita espaçamento irregular |
integrate.simpson(y, x=x) |
Dados tabulados | Erro \(O(h^4)\); exige número par de subintervalos |
integrate.cumulative_trapezoid |
Integral acumulada | Devolve array; essencial para localizar onde um erro nasce |
| Conceito | Observação |
|---|---|
| Teorema de Liouville | \(\int e^{-x^2}dx\) não tem primitiva elementar: é teorema, não limitação de software |
| Funções especiais | erf, Si, Ei são nomes para integrais que não fecham; vivem em scipy.special |
| Ordem de erro | Dobrar os nós: trapézio melhora \(4\times\), Simpson \(16\times\), mas só no regime assintótico |
| Quadratura adaptativa | Subdivide onde o erro é grande; não encontra o que nunca amostrou |
| Erro acumulativo | Integração carrega adiante o erro cometido no início, sem atenuá-lo |
| Derivar × integrar | Numericamente não são inversas: os erros se somam, não se cancelam |
Próximos Passos #
As integrais deste artigo têm todas a mesma estrutura: o integrando é conhecido de antemão. Uma função que se pode avaliar em qualquer ponto, ou uma tabela já medida. Dado isso, calcular a área é um problema resolvido.
Só que o caso mais interessante da ciência aplicada não é esse. Quando a taxa de variação de uma grandeza depende do valor atual dessa mesma grandeza (a velocidade de uma reação depende de quanto reagente ainda resta, a corrente depende da carga já acumulada no capacitor), não há integrando para tabular antes de começar. Cada passo depende do anterior.
Isso deixa de ser uma integral e passa a ser uma equação diferencial, o
assunto do
próximo artigo da série.
E o instrumento lá, o solve_ivp, com seu passo adaptativo, é parente
próximo do quad adaptativo visto aqui: a mesma ideia de gastar esforço
onde o problema é difícil, aplicada a um problema em que a resposta vai
sendo construída enquanto se caminha.