Um parâmetro ajustado sem barra de erro está incompleto. Veremos como o curve_fit funciona, o que a matriz de covariância diz sobre a incerteza e a correlação dos parâmetros, e por que linearizar os dados para ajustar pode destruir o resultado, como em Lineweaver-Burk.
A função gaussiana não tem primitiva elementar, e isso é um teorema de Liouville. Quando a primitiva não existe, ou só há uma tabela de medições, o caminho é numérico: quad, trapézio e Simpson, do scipy.integrate, com os cuidados que cada um pede.
A temperatura do reator está subindo rápido demais? A pergunta é uma derivada, mas só há números numa tabela. Veremos diferenças finitas, numpy.gradient e scipy.differentiate, e por que diminuir o passo nem sempre melhora a derivada, por causa do arredondamento e do ruído.
Dados experimentais raramente caem sobre uma curva. Veremos como o NumPy ajusta polinômios a dados com ruído, o que o SymPy não faz, por que extrapolar é perigoso e por que o fenômeno de Runge vem dos nós igualmente espaçados, e não do grau alto.
Guardados em float64, os coeficientes do polinômio de Wilkinson já não devolvem as raízes de 1 a 20: duas delas viram um par complexo. Antes de chegar a ele, vemos raízes, derivadas, integrais e divisão com numpy.polynomial e a armadilha da ordem dos coeficientes.
Do pH de um ácido fraco ao volume de um gás real e ao fator de atrito de uma tubulação: três equações que a química e a engenharia usam no dia a dia e que só têm solução numérica útil. Resolvemos as três com brentq e numpy.roots e reconstruímos o diagrama de Moody.
Onde está o Cometa Halley numa data qualquer? A resposta exige resolver a equação de Kepler, que não tem forma fechada. Com newton e brentq, do SciPy, localizamos o cometa, tornamos visível a lei das áreas e calculamos o alcance de um projétil com resistência do ar.
Na equação de Kepler, a incógnita aparece dentro e fora de um seno, e nenhuma álgebra a isola. Para casos assim, o SciPy aproxima a raiz. Veremos bisseção e brentq, o método de Newton e por que ele pode falhar, e os sistemas não lineares com fsolve e root.
A maioria das equações, integrais e equações diferenciais de problemas reais não tem solução em forma fechada, e o SymPy não as resolve. Esta série de 13 artigos mostra como NumPy e SciPy atacam esses problemas: raízes, polinômios, cálculo numérico, otimização e FFT.
Tanto o NumPy quanto o Pandas usam o conceito de eixo (axis), mas com diferenças sutis. No NumPy, ele refere-se à dimensão em que uma operação é realizada, enquanto no Pandas, indica a direção de uma operação. Este artigo apresenta exemplos do uso do axis em cada biblioteca.
Aprendemos em matemática que há regras para somar ou multiplicar matrizes. Mas, em problemas matemáticos computacionais, por vezes temos matrizes ou vetores que gostaríamos de somar ou multiplicar que não cumprem as exigências. Veremos neste artigo como o conceito de broadcasting do NumPy é útil nestes contextos e como ele se relaciona com quantização vetorial.
Caso esteja se aventurando em ciência de dados, muito provavelmente já viu um reshape em algum código. Talvez com um misterioso valor de -1 em uma das posições como reshape(-1, 1). Mas, afinal, o que significa isto? Por que por vezes precisamos transformar nossos dados para utilizar métodos de modelos no Scikit-Learn? É o que veremos neste artigo.
Métodos de Monte Carlo são algoritmos computacionais que se baseiam em amostras aleatórias para obter resultados numéricos. Neste artigo, veremos como podemos obter o valor de pi com esses métodos.
Usain Bolt é considerado por muitos o melhor velocista de todos os tempos. Nesse artigo, veremos como podemos utilizar a linguagem Python para saber a velocidade e aceleração atingidas pelo jamaicano em provas. Aproveitaremos para discutir um pouco sobre modelos matemáticos e cuidados na seleção e interpretação de seus resultados.
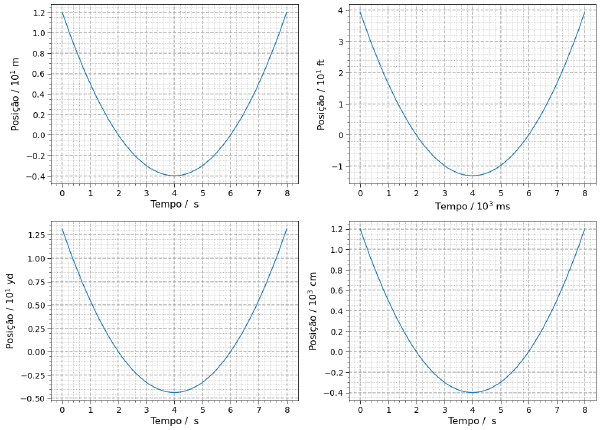
Neste artigo iremos detalhar como obter gráficos visualmente elegantes e que apresentam corretamente unidades em seus eixos. Combinaremos as bibliotecas pint, numpy e matplotlib.