Um técnico de laboratório acompanha, num datalogger (aparelho que registra medições automaticamente ao longo do tempo), a temperatura de um reator: uma sequência de números lidos a cada poucos segundos, sem fórmula nenhuma anexada. Em algum momento ele precisa responder uma pergunta muito concreta: “a temperatura está subindo rápido demais agora?”. Essa pergunta é, matematicamente, uma derivada. Só que não há \(f(x)\) nenhuma para derivar. Há só números numa tabela.
O SymPy resolve derivadas de qualquer expressão fechada com uma chamada de função, mas não tem resposta para esse problema: não existe “derivada simbólica de uma tabela”. É exatamente aqui que entram as derivadas numéricas: técnicas que estimam a taxa de variação de uma função a partir só de valores amostrados, com ou sem fórmula por trás.
Por Que Derivadas Numéricas Importam? #
- Física e engenharia de sensores: acelerômetros, sensores de posição e osciloscópios entregam sequências de leituras no tempo, e velocidade e aceleração instantâneas só existem como derivadas numéricas desses dados.
- Química e cinética de reação: a taxa de uma reação num dado instante é a derivada da concentração em relação ao tempo, estimada a partir de medições de bancada, não de uma fórmula conhecida a priori.
- Controle e processamento de sinais: um controlador PID (proporcional-integral-derivativo, arquitetura clássica de controle automático) usa a derivada do erro do sistema em tempo real, calculada sobre dados amostrados e frequentemente ruidosos.
- Otimização numérica: quando a função-objetivo não tem gradiente analítico disponível (ou é cara demais para derivar simbolicamente), otimizadores caem de volta em aproximações numéricas da derivada, tema que vai reaparecer no artigo de otimização desta série.
Do diff Simbólico à Diferença Numérica
#
O artigo de derivadas do SymPy
usou a função \(f(x) = x^3\) para apresentar diff: a derivada exata,
\(f^{\prime}(x) = 3x^2\), avaliada em \(x_0 = 2\), vale \(12\). A ideia por
trás de qualquer derivada numérica é aproximar diretamente a definição de
derivada, o limite de uma razão incremental, sem passar pelo limite de
verdade, usando um \(h\) pequeno em vez de \(h \to 0\):
Essa é a diferença central. Aplicando com alguns valores de \(h\) decrescentes, comparando com o valor exato:
import sympy as sp

x = sp.symbols("x")
f_sym = x**3
f_num = sp.lambdify(x, f_sym)
df_exata = sp.lambdify(x, sp.diff(f_sym, x))

x0 = 2.0
valor_exato = df_exata(x0)


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


for h in [1e-1, 1e-2, 1e-3, 1e-4]:
    aprox = diferenca_central(f_num, x0, h)
    erro = abs(aprox - valor_exato)
    print(f"h={h:.0e}  aproximação={aprox:.10f}  erro={erro:.2e}")
h=1e-01 aproximação=12.0100000000 erro=1.00e-02
h=1e-02 aproximação=12.0001000000 erro=1.00e-04
h=1e-03 aproximação=12.0000010000 erro=1.00e-06
h=1e-04 aproximação=12.0000000100 erro=1.00e-08Cada vez que \(h\) diminui por um fator de 10, o erro cai por um fator de aproximadamente 100. Essa é a assinatura de um método de segunda ordem, \(O(h^2)\), que a próxima seção explica.
A mesma ideia reconstrói a reta tangente daquele artigo,
\(f(x) = \frac12 x^2\) em \(x_0 = 1\), sem usar diff nenhuma vez:
import numpy as np


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


def f_tangente(x):
    return 0.5 * x**2


x0_tangente = 1.0
fp_tangente = diferenca_central(f_tangente, x0_tangente, h=1e-5)


def reta_tangente(x):
    return f_tangente(x0_tangente) + fp_tangente * (x - x0_tangente)


print("f'(1) numérica:", fp_tangente)
f'(1) numérica: 1.000000000001Praticamente \(1{,}0\), o valor exato. A figura a seguir mostra a parábola e a reta tangente construída inteiramente a partir dessa derivada numérica:
import matplotlib.pyplot as plt
import numpy as np


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


def f_tangente(x):
    return 0.5 * x**2


x0_tangente = 1.0
fp_tangente = diferenca_central(f_tangente, x0_tangente, h=1e-5)


def reta_tangente(x):
    return f_tangente(x0_tangente) + fp_tangente * (x - x0_tangente)


xs = np.linspace(-1, 3, 200)

fig, ax = plt.subplots()
ax.plot(xs, f_tangente(xs), label=r"$f(x) = \frac{1}{2}x^2$")
ax.plot(xs, reta_tangente(xs), "--", label="reta tangente (derivada numérica)")
ax.plot(x0_tangente, f_tangente(x0_tangente), "o", color="black")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.legend()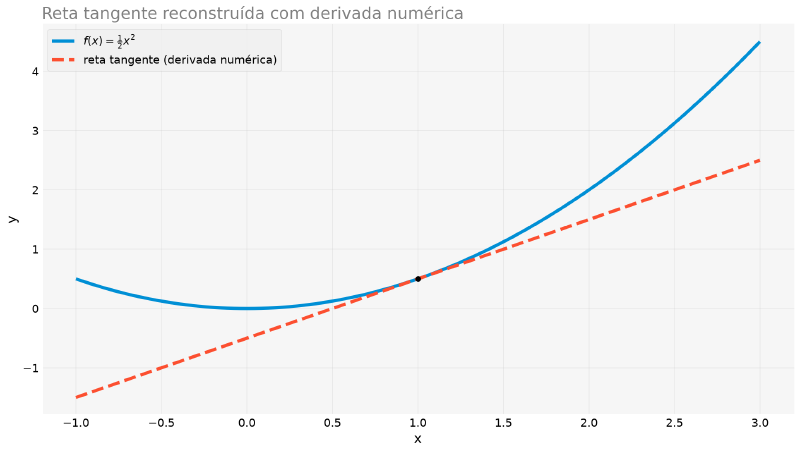
As Fórmulas das Diferenças Finitas #
A diferença central não é a única opção, e vale conhecer as outras duas para entender por que ela costuma ser a escolha padrão.
- Progressiva: \(\displaystyle f^{\prime}(x_0) \approx \frac{f(x_0+h) - f(x_0)}{h}\), erro \(O(h)\)
- Regressiva: \(\displaystyle f^{\prime}(x_0) \approx \frac{f(x_0) - f(x_0-h)}{h}\), erro \(O(h)\)
- Central: \(\displaystyle f^{\prime}(x_0) \approx \frac{f(x_0+h) - f(x_0-h)}{2h}\), erro \(O(h^2)\)
A progressiva e a regressiva só usam um “lado” de \(x_0\); a central usa os dois, e essa simetria cancela o termo de erro de primeira ordem da expansão de Taylor, por isso ela converge muito mais rápido.
Essa última frase merece as cinco linhas de conta que a justificam, porque sem elas “\(O(h^2)\)” é um rótulo decorado. Tudo sai de expandir \(f\) em Taylor nos dois lados de \(x_0\):
$$ f(x_0+h) = f + hf' + \frac{h^2}{2}f'' + \frac{h^3}{6}f''' + \cdots $$$$ f(x_0-h) = f - hf' + \frac{h^2}{2}f'' - \frac{h^3}{6}f''' + \cdots $$Progressiva. Isolando \(f^{\prime}\) da primeira:
$$ \frac{f(x_0+h) - f(x_0)}{h} = f' + \frac{h}{2}f'' + O(h^2) $$Sobra um termo proporcional a \(h\), daí o \(O(h)\).
Central. Subtraindo a segunda da primeira, todos os termos de potência par se cancelam, inclusive o \(\frac{h^2}{2}f^{\prime\prime}\) que era o vilão:
$$ f(x_0+h) - f(x_0-h) = 2hf' + \frac{h^3}{3}f''' + \cdots $$$$ \frac{f(x_0+h) - f(x_0-h)}{2h} = f' + \frac{h^2}{6}f''' + O(h^4) $$O primeiro termo de erro agora é \(h^2\), e o próximo é \(h^4\). A simetria elimina metade da série de Taylor de graça, e é isso que faz a central parecer “mais esperta”.
Vale ver isso com um \(h\) grande o bastante para as retas se separarem no desenho. Para \(f(x)=x^3\) em \(x_0=2\), com \(h = 0{,}9\):
def f(x):
    return x**3


x0, h = 2.0, 0.9
derivada_exata = 3 * x0**2

for nome, aprox in (
    ("progressiva", (f(x0 + h) - f(x0)) / h),
    ("regressiva", (f(x0) - f(x0 - h)) / h),
    ("central", (f(x0 + h) - f(x0 - h)) / (2 * h)),
):
    print(f"  {nome:>11} = {aprox:7.4f}   erro = {abs(aprox - derivada_exata):.4f}")
progressiva = 18.2100 erro = 6.2100
regressiva = 7.4100 erro = 4.5900
central = 12.8100 erro = 0.8100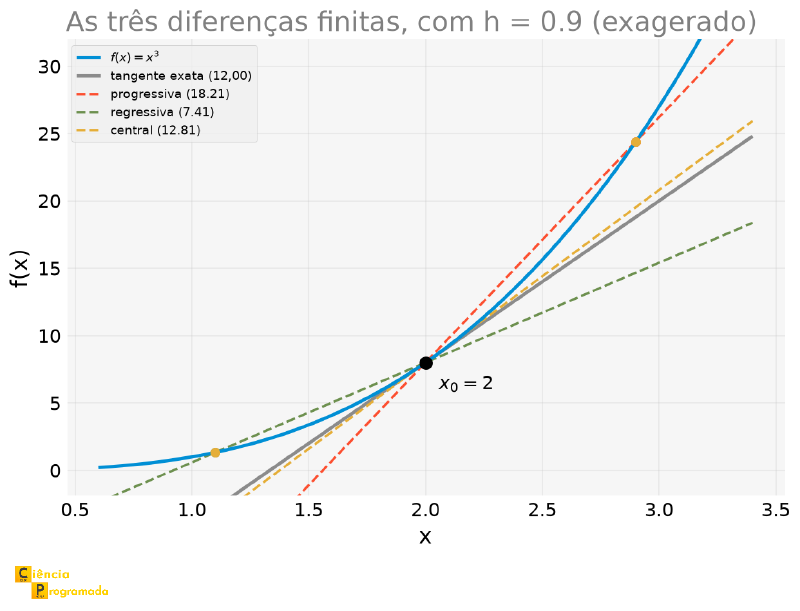
A figura mostra o mecanismo melhor que a álgebra: a progressiva erra \(+6{,}21\) e a regressiva erra \(-4{,}59\), para lados opostos. A central é essencialmente a média das duas, e os dois erros se cancelam quase inteiramente, sobrando \(0{,}81\).
Repetindo o mesmo experimento de \(f(x) = x^3\) em \(x_0 = 2\) para as três fórmulas:
import sympy as sp

x = sp.symbols("x")
f_sym = x**3
f_num = sp.lambdify(x, f_sym)
df_exata = sp.lambdify(x, sp.diff(f_sym, x))

x0 = 2.0
valor_exato = df_exata(x0)


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


def diferenca_progressiva(f, x0, h):
    return (f(x0 + h) - f(x0)) / h


def diferenca_regressiva(f, x0, h):
    return (f(x0) - f(x0 - h)) / h


print(f"{'h':>10}  {'progressiva':>14}  {'regressiva':>14}  {'central':>14}")
for h in [1e-1, 1e-2, 1e-3, 1e-4]:
    ep = abs(diferenca_progressiva(f_num, x0, h) - valor_exato)
    er = abs(diferenca_regressiva(f_num, x0, h) - valor_exato)
    ec = abs(diferenca_central(f_num, x0, h) - valor_exato)
    print(f"{h:>10.0e}  {ep:>14.2e}  {er:>14.2e}  {ec:>14.2e}")
h progressiva regressiva central
1e-01 6.10e-01 5.90e-01 1.00e-02
1e-02 6.01e-02 5.99e-02 1.00e-04
1e-03 6.00e-03 6.00e-03 1.00e-06
1e-04 6.00e-04 6.00e-04 1.00e-08| h | erro progressiva | erro regressiva | erro central |
|---|---|---|---|
| \(10^{-1}\) | \(6{,}10 \times 10^{-1}\) | \(5{,}90 \times 10^{-1}\) | \(1{,}00 \times 10^{-2}\) |
| \(10^{-2}\) | \(6{,}01 \times 10^{-2}\) | \(5{,}99 \times 10^{-2}\) | \(1{,}00 \times 10^{-4}\) |
| \(10^{-3}\) | \(6{,}00 \times 10^{-3}\) | \(6{,}00 \times 10^{-3}\) | \(1{,}00 \times 10^{-6}\) |
| \(10^{-4}\) | \(6{,}00 \times 10^{-4}\) | \(6{,}00 \times 10^{-4}\) | \(1{,}00 \times 10^{-8}\) |
Progressiva e regressiva erram por um fator de \(\approx 10\) a cada redução de \(h\) por \(10\), a assinatura de \(O(h)\). A central erra por um fator de \(\approx 100\), \(O(h^2)\), confirmando o que a teoria prevê.
Derivando Dados Tabulados: numpy.gradient
#
Fórmula em mãos, o problema real (dado tabulado, sem fórmula nenhuma)
finalmente cabe. O numpy.gradient aplica diferença central nos pontos
internos de um array (e diferença progressiva/regressiva nas bordas,
onde não há vizinho dos dois lados) e aceita coordenadas não
uniformemente espaçadas.
Exemplo: Velocidade de Usain Bolt a partir dos splits
Enunciado: O artigo sobre o recorde de Usain Bolt tem os tempos acumulados de Bolt em cada marca de 10 m da final de Berlim 2009: posição a cada 10 m, tempo não uniformemente espaçado. Estime a velocidade instantânea em cada marca.
Solução:
import numpy as np

distancia_bolt = np.arange(0, 101, 10)  # m, splits de 10 em 10
tempo_bolt = np.array(
    [0, 1.89, 2.88, 3.78, 4.64, 5.47, 6.29, 7.10, 7.92, 8.75, 9.58]
)  # s

velocidade_bolt = np.gradient(distancia_bolt, tempo_bolt)
print("velocidades (m/s):", np.round(velocidade_bolt, 2))
print("velocidade máxima:", np.round(velocidade_bolt.max(), 2), "m/s")
velocidades (m/s): [ 5.29 8.45 10.63 11.38 11.84 12.12 12.27 12.27 12.12 12.05 12.05]
velocidade máxima: 12.27 m/sO pico, \(12{,}27\) m/s, acontece entre os 60 e os 70 metros, coerente
com o que se sabe sobre a prova. No artigo
original, a velocidade veio de ajustar uma spline cúbica aos dados e
derivar essa spline analiticamente (CubicSpline(...).derivative()), o
que deu uma velocidade máxima de \(12{,}37\) m/s. Aqui, sem ajustar
nada, aplicando diferença finita direto nos pontos brutos, o resultado
fica a \(0{,}10\) m/s de distância (\(< 1\%\)), uma boa notícia:
para uma estimativa rápida, numpy.gradient já entrega um resultado
quase tão bom quanto um ajuste mais elaborado.
O gráfico a seguir mostra essa evolução:
import matplotlib.pyplot as plt
import numpy as np

distancia_bolt = np.arange(0, 101, 10)  # m, splits de 10 em 10
tempo_bolt = np.array(
    [0, 1.89, 2.88, 3.78, 4.64, 5.47, 6.29, 7.10, 7.92, 8.75, 9.58]
)  # s

velocidade_bolt = np.gradient(distancia_bolt, tempo_bolt)

fig, ax = plt.subplots()
ax.plot(tempo_bolt, velocidade_bolt, "o-")
ax.set_xlabel("tempo (s)")
ax.set_ylabel("velocidade (m/s)")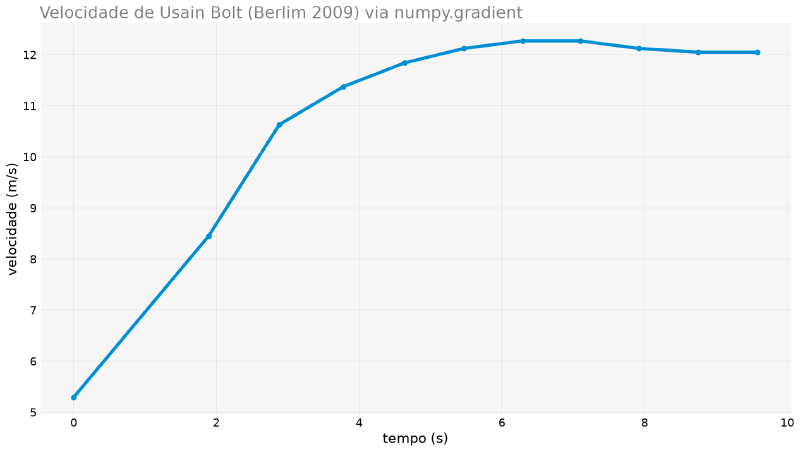
Uma API Moderna: scipy.differentiate
#
Para funções fechadas (não dados tabulados), o SciPy tem uma API dedicada a derivadas numéricas, com estimativa de erro e critério de parada automáticos, mais robusta do que escolher um único \(h\) na mão:
from scipy import differentiate

x0 = 2.0
res = differentiate.derivative(lambda x: x**3, x0)
print("f'(2):", res.df, " erro estimado:", res.error, " avaliações:", res.nfev)
f'(2): 12.0 erro estimado: 1.4210854715202004e-14 avaliações: 11scipy.misc.derivative foi removido
Versões mais antigas do SciPy tinham scipy.misc.derivative, hoje
completamente removida (não apenas descontinuada). Código antigo que
ainda a importa quebra com ImportError. A alternativa atual é
scipy.differentiate.derivative (vista acima) ou uma diferença central
manual como a das seções anteriores.
O Trade-off do Passo h: Truncamento × Arredondamento #
Voltando à diferença central manual: se erro cai com \(h\) menor, por que não escolher \(h\) minúsculo sempre? Repetindo o experimento de \(f(x)=x^3\) em \(x_0=2\), mas varrendo \(h\) numa faixa muito mais ampla, de \(10^{-16}\) a \(10^{-1}\), revela a resposta:
import matplotlib.pyplot as plt
import numpy as np
import sympy as sp

x = sp.symbols("x")
f_sym = x**3
f_num = sp.lambdify(x, f_sym)
df_exata = sp.lambdify(x, sp.diff(f_sym, x))

x0 = 2.0
valor_exato = df_exata(x0)


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


hs = np.logspace(-16, -1, 200)
erros_central = np.array(
    [abs(diferenca_central(f_num, x0, h) - valor_exato) for h in hs]
)

fig, ax = plt.subplots()
ax.loglog(hs, erros_central)
ax.set_xlabel("h")
ax.set_ylabel("erro absoluto")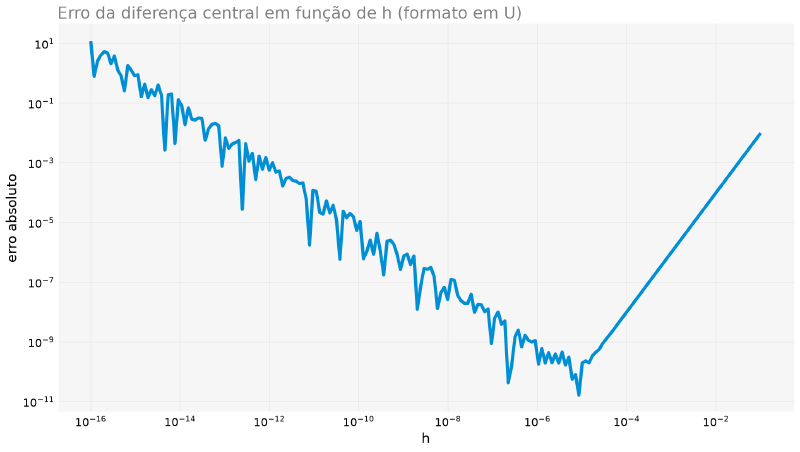
import numpy as np
import sympy as sp

x = sp.symbols("x")
f_sym = x**3
f_num = sp.lambdify(x, f_sym)
df_exata = sp.lambdify(x, sp.diff(f_sym, x))

x0 = 2.0
valor_exato = df_exata(x0)


def diferenca_central(f, x0, h):
    return (f(x0 + h) - f(x0 - h)) / (2 * h)


hs = np.logspace(-16, -1, 200)
erros_central = np.array(
    [abs(diferenca_central(f_num, x0, h) - valor_exato) for h in hs]
)

h_otimo = hs[np.argmin(erros_central)]
print("h aproximadamente ótimo:", h_otimo)
print("erro mínimo:", erros_central.min())
h aproximadamente ótimo: 8.50448934180267e-06
erro mínimo: 1.6351364706679306e-11Para \(h\) maior, domina o erro de truncamento, a própria aproximação da derivada por uma razão incremental finita, que a teoria prevê como \(O(h^2)\). Para \(h\) menor que \(\approx 10^{-5}\) a \(10^{-6}\) (nesse exemplo, em ponto flutuante de precisão dupla), domina o erro de arredondamento: \(f(x_0+h)\) e \(f(x_0-h)\) ficam tão próximos que a subtração perde dígitos significativos. O gráfico não é uma curva decrescente até zero: é um “U”, com um \(h\) ótimo no meio.
O “U” É a Soma de Duas Retas #
O formato não é mistério nenhum: são duas leis simples somadas, cada uma dominando um lado.
- Truncamento. Da dedução de Taylor, o erro é \(\frac{h^2}{6}|f^{\prime\prime\prime}|\). Para \(f = x^3\), \(f^{\prime\prime\prime} = 6\), então vale exatamente \(h^2\).
- Arredondamento. Cada avaliação de \(f\) carrega erro relativo \(\epsilon \approx 2{,}2\times10^{-16}\), logo erro absoluto \(\epsilon|f|\). A subtração no numerador soma os dois, e a divisão por \(2h\) amplifica: o erro vira \(\epsilon|f|/h\).
Derivando e igualando a zero, o mínimo fica em:
$$ h_{\text{ót}} = \sqrt[3]{\frac{\epsilon |f|}{2}} $$import numpy as np
import sympy as sp
x = sp.symbols("x")
f_sym = x**3
f_num = sp.lambdify(x, f_sym)
df_exata = sp.lambdify(x, sp.diff(f_sym, x))
x0 = 2.0
valor_exato = df_exata(x0)
def diferenca_central(f, x0, h):
return (f(x0 + h) - f(x0 - h)) / (2 * h)
hs = np.logspace(-16, -1, 200)
erros_central = np.array(
[abs(diferenca_central(f_num, x0, h) - valor_exato) for h in hs]
)
eps_maq = np.finfo(float).eps
h_teorico = (eps_maq * abs(f_num(x0)) / 2) ** (1 / 3)
print(f"h ótimo medido: {hs[np.argmin(erros_central)]:.3e}")
print(f"h ótimo previsto: {h_teorico:.3e}")h ótimo medido: 8.504e-06
h ótimo previsto: 9.612e-06Mesma ordem de grandeza, com um fator 1,1 de diferença, o que é bom o bastante, porque o modelo do arredondamento é uma estimativa grosseira. E o expoente \(1/3\) deixa de ser mágico: ele vem de equilibrar \(h^2\) contra \(1/h\).
O gráfico a seguir põe juntas as três curvas, o erro medido e as duas parcelas teóricas:
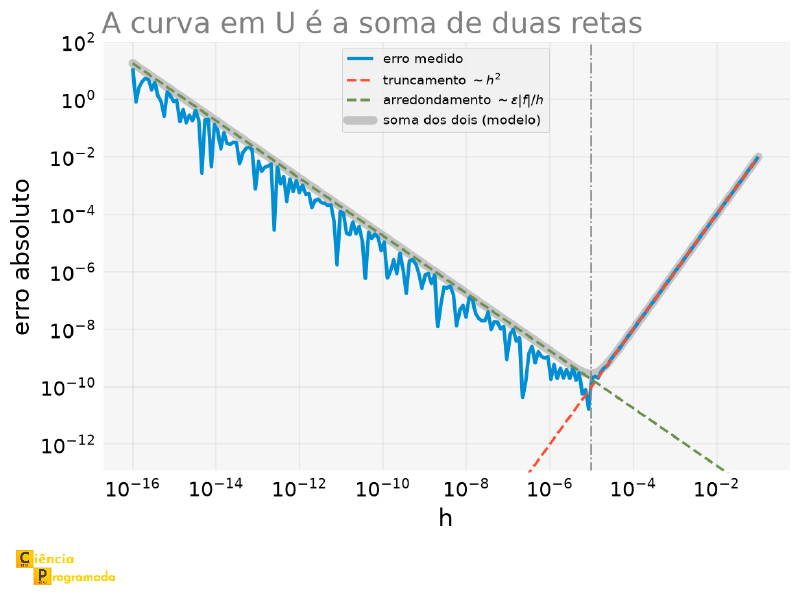
Duas coisas a notar na figura. Primeiro, a curva medida cola em cada uma das retas no seu regime: o modelo de duas parcelas descreve bem o que acontece. Segundo, o lado esquerdo é serrilhado, e o direito é liso: o erro de truncamento é determinístico, mas o de arredondamento depende de quais bits sobram em cada subtração, e varia de forma errática. Por isso o “\(h\) ótimo” é, na prática, uma região e não um ponto; não vale a pena caçar o valor exato.
A Segunda Derivada É Ainda Mais Frágil #
A mesma expansão de Taylor dá a fórmula da segunda derivada, desta vez somando as duas expansões, em vez de subtrair:
Erro de truncamento \(O(h^2)\), como a primeira derivada. É uma fórmula usada na discretização de equações diferenciais parciais.
Mas o \(h^2\) no denominador muda tudo do lado do arredondamento: em vez de \(\epsilon|f|/h\), o erro passa a ser \(\epsilon|f|/h^2\). O efeito é visível num caso limpo. Para \(f = x^3\), a quarta derivada é zero, então o truncamento some e o que sobra é 100% arredondamento:
import sympy as sp

x = sp.symbols("x")
f_num = sp.lambdify(x, x**3)
x0 = 2.0

for h in (1e-1, 1e-2, 1e-3, 1e-4, 1e-5):
    d2 = (f_num(x0 + h) - 2 * f_num(x0) + f_num(x0 - h)) / h**2
    print(f"h={h:.0e}: f''={d2:.8f}   erro={abs(d2 - 12):.2e}")
h=1e-01: f''=12.00000000 erro=8.88e-15
h=1e-02: f''=12.00000000 erro=2.80e-11
h=1e-03: f''=12.00000000 erro=9.87e-10
h=1e-04: f''=12.00000028 erro=2.82e-07
h=1e-05: f''=12.00000987 erro=9.87e-06Cada divisão de \(h\) por 10 multiplica o erro por 100, a assinatura do \(1/h^2\). Repare que aqui o “melhor” \(h\) é o maior testado, o oposto da intuição. Numa função com quarta derivada não nula haveria um \(U\) de novo, mas com o mínimo em \(h\) bem maior que o da primeira derivada.
Quando o Dado é Ruidoso #
O mesmo formato em U aparece de outro jeito quando os dados vêm de uma medição real, com ruído, e, nesse caso, a fonte do problema deixa de ser o arredondamento de ponto flutuante e passa a ser o instrumento.
import numpy as np

sigma_ruido = 0.01


def experimento_ruido(n_pontos, semente=7):
    rng = np.random.default_rng(semente + n_pontos)  # semente por chamada
    xs = np.linspace(0, 2 * np.pi, n_pontos)
    ruido = rng.normal(0, sigma_ruido, size=xs.shape)
    sinal_ruidoso = np.sin(xs) + ruido
    derivada_numerica = np.gradient(sinal_ruidoso, xs)
    erro = np.abs(derivada_numerica - np.cos(xs))
    return xs, sinal_ruidoso, derivada_numerica, erro


print(f"{'n pontos':>10}  {'h':>10}  {'erro médio':>12}  {'erro máximo':>12}")
for n in [20, 50, 200, 1000]:
    xs, _, _, erro = experimento_ruido(n)
    h = xs[1] - xs[0]
    print(f"{n:>10d}  {h:>10.4f}  {erro.mean():>12.4f}  {erro.max():>12.4f}")
n pontos h erro médio erro máximo
20 0.3307 0.0239 0.0618
50 0.1282 0.0412 0.1436
200 0.0316 0.1759 0.7145
1000 0.0063 0.8771 4.2044O sinal é \(\sin(x)\) com um ruído gaussiano pequeno, \(\sigma = 0{,}01\), quase imperceptível a olho nu. Ainda assim, refinar a malha piora a derivada: com \(1000\) pontos, o erro médio (\(0{,}88\)) já é da mesma ordem de grandeza da própria amplitude do cosseno que se quer recuperar, que vale \(1\). Ou seja: o “sinal” e o “erro” passam a ter tamanhos comparáveis, e a derivada deixa de significar grande coisa.
A razão é que o ruído não muda de amplitude quando \(h\) diminui, mas a variação real do sinal entre dois pontos vizinhos, sim; então, conforme os pontos se aproximam, o ruído passa a dominar. E isso dá para prever antes de rodar. Na diferença central, o ruído das duas amostras entra dividido por \(2h\):
$$ \sigma_{\text{derivada}} \approx \frac{\sqrt{2}\sigma}{2h} = \frac{\sigma}{\sqrt{2} h} $$Com \(1000\) pontos em \([0, 2\pi]\), temos \(h \approx 0{,}0063\) e \(\sigma = 0{,}01\), o que dá \(\sigma_{\text{derivada}} \approx 1{,}12\). O erro absoluto médio de uma gaussiana é \(\sqrt{2/\pi} \approx 0{,}80\) vezes seu desvio padrão, ou seja, \(\approx 0{,}90\), batendo com os \(0{,}88\) medidos. Repare no \(h\) no denominador: o erro da derivada cresce quando a malha refina, exatamente o contrário do que acontece com o erro de truncamento.
import matplotlib.pyplot as plt
import numpy as np

sigma_ruido = 0.01


def experimento_ruido(n_pontos, semente=7):
    rng = np.random.default_rng(semente + n_pontos)  # semente por chamada
    xs = np.linspace(0, 2 * np.pi, n_pontos)
    ruido = rng.normal(0, sigma_ruido, size=xs.shape)
    sinal_ruidoso = np.sin(xs) + ruido
    derivada_numerica = np.gradient(sinal_ruidoso, xs)
    erro = np.abs(derivada_numerica - np.cos(xs))
    return xs, sinal_ruidoso, derivada_numerica, erro


xs_fino, sinal_fino, deriv_fino, _ = experimento_ruido(200)

fig, (ax1, ax2) = plt.subplots(2, 1, sharex=True, figsize=(8, 6))
ax1.plot(xs_fino, sinal_fino, "o", color="C0", markersize=3, alpha=0.6,
         label="sinal medido (com ruído)", zorder=1)
ax1.plot(xs_fino, np.sin(xs_fino), color="C1", linewidth=2, label=r"$\sin(x)$ real", zorder=2)
ax1.legend()

ax2.plot(xs_fino, deriv_fino, color="C0", label="derivada numérica")
ax2.plot(xs_fino, np.cos(xs_fino), color="C1", linewidth=2, label=r"$\cos(x)$ real")
ax2.set_xlabel("x")
ax2.legend()
A figura a seguir compara o sinal medido com o real (acima) e a derivada numérica com a derivada real (abaixo):
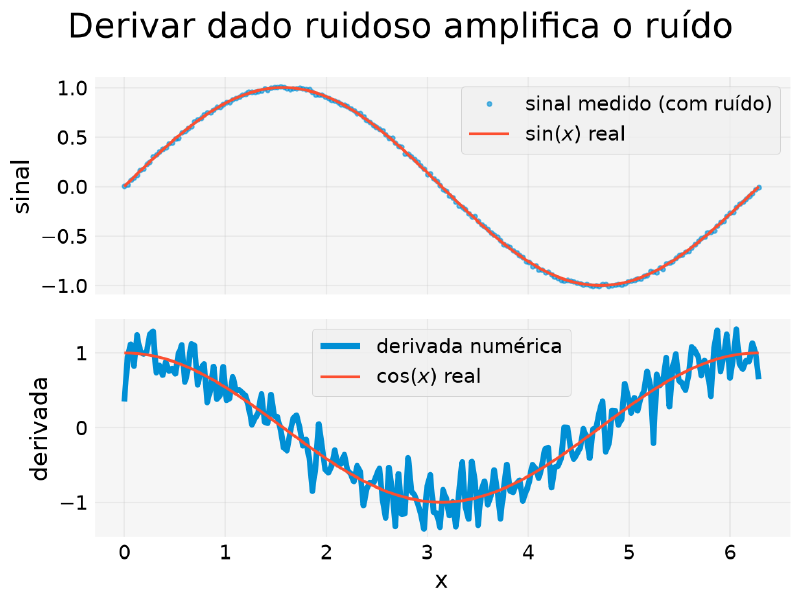
Na seção anterior, o “U” veio do arredondamento de ponto flutuante, um problema que desaparece se \(h\) for maior. Aqui, ele vem do ruído de medição, que nenhum \(h\) elimina sozinho: refinar a malha só concentra mais ruído por unidade de \(h\). Na prática, dados ruidosos às vezes pedem suavização antes de derivar, ou um \(h\) deliberadamente maior, o oposto do instinto de “mais pontos é sempre melhor”.
Aplicação: Taxa de Reação a Partir de Dado de Concentração #
Uma última aplicação, puxando para a química: um experimento de cinética mede a concentração de um reagente em instantes escolhidos pelo experimentador (não uniformemente espaçados), sem assumir de antemão qual é a lei de velocidade da reação.
Exemplo: Taxa de reação instantânea sem conhecer a cinética
Enunciado: Uma reação é acompanhada por 11 medições de concentração entre \(t=0\) e \(t=30\) min. Estime a taxa de reação instantânea, \(-dC/dt\), em cada instante medido, sem supor a ordem da reação.
Solução:
import numpy as np

tempo_cinetica = np.array([0, 2, 4, 6, 8, 10, 12, 15, 20, 25, 30])  # min
concentracao_medida = np.array(
    [2.02, 1.456, 1.102, 0.807, 0.598, 0.444, 0.31, 0.208, 0.091, 0.08, 0.024]
)  # mol/L

taxa_instantanea = -np.gradient(concentracao_medida, tempo_cinetica)
print("taxa (mol/L/min):", np.round(taxa_instantanea, 4))
taxa (mol/L/min): [0.282 0.2295 0.1622 0.126 0.0908 0.072 0.0538 0.03 0.0128 0.0067
0.0112]Só com os dados medidos e numpy.gradient, sem ajustar modelo cinético
nenhum, já se obtém a taxa em cada ponto, um primeiro passo de
análise de cinética química. Só depois de ter essa curva é que
cabe perguntar se ela é compatível com uma lei de 1ª ordem, de 2ª ordem,
ou outra coisa.
Para conferir, preciso “trapacear”. Como os dados de concentração acima foram simulados, conheço a relação real por trás deles: \(C(t) = C_0 e^{-kt}\), com \(k=0{,}15\) min\(^{-1}\) e \(C_0=2\) mol/L, algo que, com dados de bancada de verdade, jamais saberia de antemão. Uso essa relação real só para gerar uma curva de referência contínua, avaliada numa malha fina de tempo (não só nos 11 instantes medidos, senão caio no mesmo problema de ligar poucos pontos por reta da seção anterior), e comparar com a taxa estimada:
import matplotlib.pyplot as plt
import numpy as np

tempo_cinetica = np.array([0, 2, 4, 6, 8, 10, 12, 15, 20, 25, 30])  # min
concentracao_medida = np.array(
    [2.02, 1.456, 1.102, 0.807, 0.598, 0.444, 0.31, 0.208, 0.091, 0.08, 0.024]
)  # mol/L

taxa_instantanea = -np.gradient(concentracao_medida, tempo_cinetica)

tempo_fino = np.linspace(0, 30, 200)
k_real, C0_real = 0.15, 2.0  # conhecidos só porque os dados são sintéticos
taxa_real_continua = k_real * C0_real * np.exp(-k_real * tempo_fino)

fig, ax = plt.subplots()
ax.plot(tempo_cinetica, taxa_instantanea, "o", label="taxa estimada (numpy.gradient)")
ax.plot(tempo_fino, taxa_real_continua, "--", label=r"$k \cdot C_0 e^{-kt}$ (conferência)")
ax.set_xlabel("t (min)")
ax.set_ylabel("taxa de reação (mol/L/min)")
ax.legend()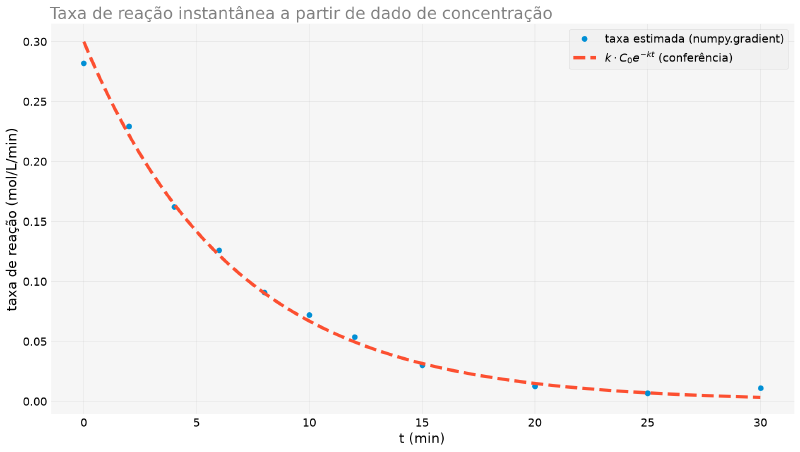
A taxa estimada por diferenças finitas, calculada sem conhecer \(k\) ou \(C_0\), acompanha a curva real com erro de poucos por cento na maior parte da faixa medida, o suficiente para suspeitar, corretamente, de uma cinética de 1ª ordem. Mas os dois últimos pontos destoam feio: em \(t=20\) min o erro é de \(-14\%\), e em \(t=30\) min passa de \(200\%\). Vale entender por quê, porque a explicação é uma lição de bancada.
A tentação é culpar a borda da série, e ela contribui, mas não é a causa principal. O culpado é o ponto medido em \(t=25\) min.
Esses dados são sintéticos, então dá para “trapacear” de novo e comparar cada medição com o valor verdadeiro. Quase todas caem dentro de \(1\sigma\) do ruído simulado. A de \(t=25\) min, não: ela vale \(0{,}080\) mol/L contra \(0{,}047\) reais, um desvio de \(+3{,}3\sigma\), o tipo de ponto que numa bancada de verdade se chamaria de “medida ruim”.
Agora repare em como a derivada na borda é calculada. Sem vizinho à
direita, o numpy.gradient usa uma diferença regressiva simples entre os
dois últimos pontos:
O outlier entra inteiro na conta. Com o valor correto no lugar dele, a mesma fórmula daria \(-0{,}0046\), erro de \(39\%\) em vez de \(200\%\). O espaçamento maior (5 min contra 2 min) e a borda pioram a situação, mas quem quintuplica o erro é o ponto isolado.
A lição: derivar amplifica erro, e o estrago é local. Um único ponto fora da curva não estraga a série inteira: estraga a derivada nos seus vizinhos imediatos. Por isso, na prática, olha-se a curva de taxa procurando exatamente esse padrão: um par de pontos discrepantes lado a lado costuma denunciar uma medição ruim entre eles, não uma mudança de mecanismo.
edge_order: mais preciso nem sempre é melhor
O numpy.gradient aceita um parâmetro edge_order, que controla a ordem
da fórmula usada nas bordas. O padrão é 1: a diferença simples de
dois pontos (regressiva na borda direita, como a que acabamos de ver). Com edge_order=2, ele usa
uma fórmula de três pontos, teoricamente mais precisa.
Parece a correção óbvia para o problema acima, mas não é:
import numpy as np

tempo_cinetica = np.array([0, 2, 4, 6, 8, 10, 12, 15, 20, 25, 30])  # min
concentracao_medida = np.array(
    [2.02, 1.456, 1.102, 0.807, 0.598, 0.444, 0.31, 0.208, 0.091, 0.08, 0.024]
)  # mol/L

for ordem in (1, 2):
    taxa = -np.gradient(concentracao_medida, tempo_cinetica, edge_order=ordem)
    print(f"edge_order={ordem}: taxa em t=30 = {taxa[-1]:.4f} (real: 0.0033)")
edge_order=1: taxa em t=30 = 0.0112 (real: 0.0033)
edge_order=2: taxa em t=30 = 0.0157 (real: 0.0033)O erro piora, de \(236\%\) para \(371\%\). O motivo é o mesmo outlier: a fórmula de ordem 2 usa três pontos em vez de dois, e dá ao ponto de \(t=25\) min um peso ainda maior.
É um lembrete útil sobre o que “ordem de convergência” significa. Uma
fórmula de ordem mais alta converge mais rápido quando a função é
suave: é uma promessa sobre o erro de truncamento, e só sobre ele. Se o
que domina o erro é ruído de medição, e não truncamento, subir a ordem
amplifica o problema em vez de resolver. Com dados suaves, edge_order=2
ajuda de verdade; com uma medição ruim na borda, atrapalha.
Mais adiante na série, no artigo de equações diferenciais,
essa mesma cinética aparece de novo, mas modelada diretamente como
equação diferencial, inclusive um caso, reações consecutivas
\(A \to B \to C\), sem solução fechada simples, que numpy.gradient
sozinho não ajudaria a prever de antemão.
E o técnico do início, acompanhando a temperatura do reator no
datalogger? Agora tem resposta: numpy.gradient nas últimas leituras
diz, na hora, se a temperatura está subindo rápido demais, sem precisar
de fórmula nenhuma, só dos números que o aparelho já está registrando.
Tabela-Resumo #
| Ferramenta / conceito | Uso | Observação |
|---|---|---|
| Diferença progressiva | \((f(x+h)-f(x))/h\) | Erro \(O(h)\); só usa um lado de \(x_0\) |
| Diferença regressiva | \((f(x)-f(x-h))/h\) | Erro \(O(h)\); só usa um lado de \(x_0\) |
| Diferença central | \((f(x+h)-f(x-h))/(2h)\) | Erro \(O(h^2)\); escolha padrão |
numpy.gradient(y, x) |
Derivada de dado tabulado, x pode ser não uniforme |
Diferença central nos pontos internos, progressiva/regressiva nas bordas |
scipy.differentiate.derivative |
Derivada numérica de função fechada, API moderna | Estimativa de erro e critério de parada automáticos; substitui scipy.misc.derivative (removida) |
| Curva em U (h vs. erro) | Trade-off truncamento × arredondamento | \(h\) ótimo existe; menor nem sempre é melhor |
| Derivada de dado ruidoso | numpy.gradient sobre sinal com ruído de medição |
Refinar a malha amplifica o ruído, mesmo formato em U, causa diferente |
Próximos Passos #
Este artigo cobriu como calcular uma derivada quando não há fórmula
fechada, só dados. A operação inversa tem exatamente o mesmo problema, e
de forma ainda mais aguda: existem integrais que provadamente não têm
primitiva elementar, não por limitação do SymPy, mas por teorema. No
próximo artigo,
o scipy.integrate resolve essas integrais numericamente, e os mesmos
dados do Usain Bolt vistos aqui voltam pelo caminho contrário: a velocidade
que acabamos de derivar é integrada de volta, para ver se ela reconstrói os
\(100\) m da prova.