A fórmula do período de um pêndulo simples, \(T = 2\pi\sqrt{L/g}\), é uma das primeiras equações de física que todo estudante decora, e quase ninguém percebe que ela só vale para oscilações pequenas. Um pêndulo de verdade, solto de um ângulo grande, tem período maior do que essa fórmula prevê. E a equação diferencial exata desse pêndulo, sem a simplificação de ângulo pequeno, não tem solução em forma fechada nenhuma, nem o SymPy resolve.
Isso não é uma limitação do SymPy especificamente. Boa parte das equações diferenciais ordinárias (EDOs) que descrevem sistemas reais (não lineares, com mais de uma variável, com termos de resistência ou de reação) simplesmente não têm solução analítica. Quando isso acontece, resta uma saída: resolver numericamente.
Este artigo fecha o bloco de cálculo numérico da série. O artigo de derivadas numéricas mostrou como derivar dados sem fórmula por trás; o anterior integrou funções e tabelas, mas sempre com o integrando conhecido de antemão. Aqui cai justamente essa hipótese: quando a taxa de variação depende do valor atual da própria grandeza, não há integrando para tabular antes de começar, porque cada passo depende do anterior. É a diferença entre calcular uma área e resolver uma equação diferencial.
Por Que Resolver Equações Diferenciais Numericamente Importa? #
- Física: pêndulos de ângulo grande, órbitas perturbadas, projéteis com resistência do ar. A maioria dos sistemas mecânicos reais só tem solução fechada sob simplificações que nem sempre valem.
- Química e cinética de reação: mecanismos com mais de uma etapa (reações consecutivas, reversíveis, catalisadas) geram sistemas de equações diferenciais acopladas que raramente fecham analiticamente.
- Engenharia elétrica e de controle: circuitos com múltiplos componentes, sistemas de controle realimentados. A análise de resposta no tempo depende de resolver EDOs, muitas vezes numericamente.
- Biologia e epidemiologia: modelos de crescimento populacional e de disseminação de doenças (predador-presa, SIR) são não lineares por natureza e quase sempre exigem solução numérica.
Do dsolve ao solve_ivp
#
O artigo de derivadas do SymPy
resolveu uma única equação diferencial: \(f(x) - f^{\prime}(x) = 0\), cuja
solução simbólica é a família \(f(x) = C_1 e^x\), com a constante
\(C_1\) em aberto. É assim que o dsolve sempre responde: a solução
geral, válida para qualquer condição inicial.
import sympy as sp

t = sp.symbols("t")
f = sp.Function("f")
eq_dif = sp.Eq(f(t) - sp.diff(f(t), t), 0)
print(sp.dsolve(eq_dif, f(t)))
Eq(f(t), C1*exp(t))O scipy.integrate.solve_ivp resolve o mesmo tipo de problema de outro
jeito: em vez de uma família de soluções, devolve uma solução
numérica, específica para uma condição inicial concreta, daí o nome,
initial value problem (problema de valor inicial, ou PVI). A convenção
de assinatura é sempre a mesma: uma função campo(t, y) que devolve a
derivada de cada componente de y, um intervalo de tempo, e a condição
inicial:
import numpy as np
from scipy.integrate import solve_ivp


def campo_exponencial(t, y):
    return y  # f'(t) = f(t)


sol = solve_ivp(campo_exponencial, [0, 3], [1.0], dense_output=True, rtol=1e-10, atol=1e-12)

t_plot = np.linspace(0, 3, 200)
y_numerica = sol.sol(t_plot)[0]
y_analitica = np.exp(t_plot)
print("erro máximo numérico × analítico:", np.max(np.abs(y_numerica - y_analitica)))
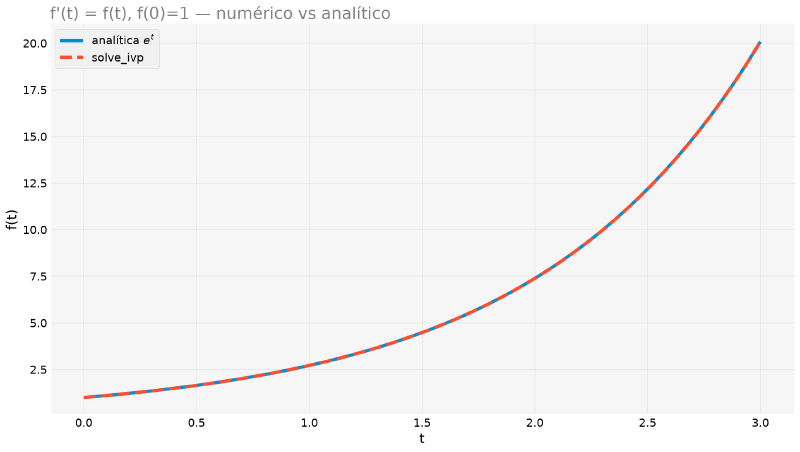
erro máximo numérico × analítico: 1.581241804160527e-09Com \(f(0) = 1\) fixando a constante (\(C_1 = 1\)), a curva numérica
cai em cima da curva analítica \(e^t\), com erro da ordem de
\(10^{-9}\), puro artefato de tolerância numérica, não da técnica.
dense_output=True permite avaliar a solução em qualquer ponto do
intervalo depois de resolvida, o que é o que sol.sol(t_plot) faz aqui.
Mas apareceram dois parâmetros sem explicação, rtol e atol, e eles vão
reaparecer em quase toda chamada deste artigo. Vale entender o que
significam antes de seguir.
rtol e atol: como o solve_ivp decide se um passo é bom
Todo método de passo adaptativo precisa de um critério para aceitar ou
rejeitar um passo. O solve_ivp estima o erro cometido em cada passo e o
compara com um limite construído a partir dos dois parâmetros:
Se o erro passar desse limite, o passo é rejeitado e refeito com \(h\) menor; se ficar bem abaixo, o integrador se permite aumentar \(h\) no passo seguinte. É assim que ele escolhe o tamanho do passo sozinho.
Os dois cumprem papéis diferentes, e por isso existem os dois:
rtol(relative tolerance) controla os dígitos significativos. Umrtol=1e-6pede, grosso modo, 6 dígitos corretos, independentemente de \(y\) valer \(10^{-3}\) ou \(10^{8}\).atol(absolute tolerance) é um piso, e existe para o caso em que \(y\) passa perto de zero. Ali o termo \(\texttt{rtol} \times |y|\) também tende a zero, e exigir precisão relativa sobre um número minúsculo seria impossível: o integrador ficaria reduzindo o passo para sempre. Oatoldiz “abaixo deste valor absoluto, pare de se preocupar”.
Os valores padrão são rtol=1e-3 e atol=1e-6, os mesmos para
todos os métodos, e bem frouxos: foram escolhidos para serem rápidos, não
precisos. A diferença é fácil de medir, resolvendo a mesma exponencial
das duas formas:
import numpy as np
from scipy.integrate import solve_ivp


def campo_exponencial(t, y):
    return y  # f'(t) = f(t)


t_plot = np.linspace(0, 3, 200)
y_analitica = np.exp(t_plot)

sol_padrao = solve_ivp(campo_exponencial, [0, 3], [1.0], dense_output=True)
print("erro com os padrões:", np.max(np.abs(sol_padrao.sol(t_plot)[0] - y_analitica)))
erro com os padrões: 0.0020342038563727627Erro de \(2 \times 10^{-3}\) contra os \(1{,}6 \times 10^{-9}\) de antes: um milhão de vezes maior, na mesma EDO e no mesmo intervalo. Três dígitos corretos bastam para desenhar um gráfico, mas não para comparar contra uma solução analítica, que é o que faremos aqui o tempo todo. Por isso as chamadas deste artigo quase sempre apertam os dois.
“Quase sempre”: a comparação de rigidez, mais adiante, usa deliberadamente os padrões, porque as contagens de passos de cada método só fazem sentido se todos correrem sob o mesmo critério, e o padrão é o critério que a maioria das pessoas vai usar na prática.
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp


def campo_exponencial(t, y):
    return y  # f'(t) = f(t)


sol = solve_ivp(campo_exponencial, [0, 3], [1.0], dense_output=True, rtol=1e-10, atol=1e-12)

t_plot = np.linspace(0, 3, 200)
y_numerica = sol.sol(t_plot)[0]
y_analitica = np.exp(t_plot)

fig, ax = plt.subplots()
ax.plot(t_plot, y_analitica, label=r"analítica $e^t$")
ax.plot(t_plot, y_numerica, "--", label="solve_ivp")
ax.set_xlabel("t")
ax.set_ylabel("f(t)")
ax.legend()
O gráfico a seguir mostra as duas curvas sobrepostas:
O Pêndulo que a Fórmula do Ensino Médio Não Descreve #
Voltando ao pêndulo da abertura: a equação de movimento exata, sem nenhuma aproximação, é
$$ \theta''(t) + \frac{g}{L}\sin\theta(t) = 0 $$O termo \(\sin\theta\) é o problema: não linear, e é exatamente o que impede uma solução fechada em termos de funções elementares. A solução exata existe, mas escrita com integrais elípticas, que não são funções elementares; voltaremos a elas daqui a pouco, para conferir o período que mediremos numericamente. A simplificação do ensino médio assume ângulo pequeno, \(\sin\theta \approx \theta\), o que transforma a equação numa EDO linear com solução fechada em cosseno: \(\theta(t) = \theta_0 \cos(\omega t)\), com \(\omega = \sqrt{g/L}\), daí a fórmula do período, \(T = 2\pi/\omega = 2\pi\sqrt{L/g}\).
solve_ivp não precisa de nenhuma dessas simplificações, mas ele só
resolve sistemas de primeira ordem, e a equação do pêndulo é de segunda.
A conversão é mecânica, e vale fazê-la explicitamente, porque é a manobra
que se repete para toda EDO de ordem alta:
Batize cada derivada até uma ordem abaixo da máxima como uma variável nova:
$$u_1 = \theta, \qquad u_2 = \dot\theta$$Agora escreva a derivada de cada uma. A primeira é imediata, por definição; a segunda vem da equação original, isolando \(\ddot\theta\):
$$\dot u_1 = u_2, \qquad \dot u_2 = -\frac{g}{L}\sin u_1$$
Pronto: duas equações de primeira ordem, cada uma dando a derivada de uma
componente em função das duas. É exatamente o que a função
campo(t, y) precisa devolver, na ordem [u1_ponto, u2_ponto].
A receita vale em geral: uma equação de ordem \(n\) vira um sistema de \(n\) equações de primeira ordem, com \(n\) condições iniciais. Um oscilador amortecido, um circuito RLC, um sistema massa-mola: todos passam por aqui.
Traduzindo para código, \(\theta\) e \(\dot\theta\) viram as duas
componentes de y:
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81  # m/s^2
L = 1.0  # m
omega = np.sqrt(g / L)


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


def pendulo_linear(t, theta0):
    return theta0 * np.cos(omega * t)


t_span = [0, 6]
t_eval = np.linspace(*t_span, 400)

for theta0_graus in [10, 60]:
    theta0 = np.radians(theta0_graus)
    sol = solve_ivp(pendulo_nao_linear, t_span, [theta0, 0.0], t_eval=t_eval, rtol=1e-8, atol=1e-10)
    diff_max = np.max(np.abs(np.degrees(sol.y[0] - pendulo_linear(t_eval, theta0))))
    print(f"theta0={theta0_graus} graus: divergência máxima da aproximação linear = {diff_max:.3f} graus")
theta0=10 graus: divergência máxima da aproximação linear = 0.330 graus
theta0=60 graus: divergência máxima da aproximação linear = 69.384 grausPara \(10°\), a aproximação de ângulo pequeno erra por menos de meio grau, motivo pelo qual ela funciona tão bem nos problemas de livro-texto, quase sempre com ângulos pequenos. Para \(60°\), a divergência passa de \(69°\).
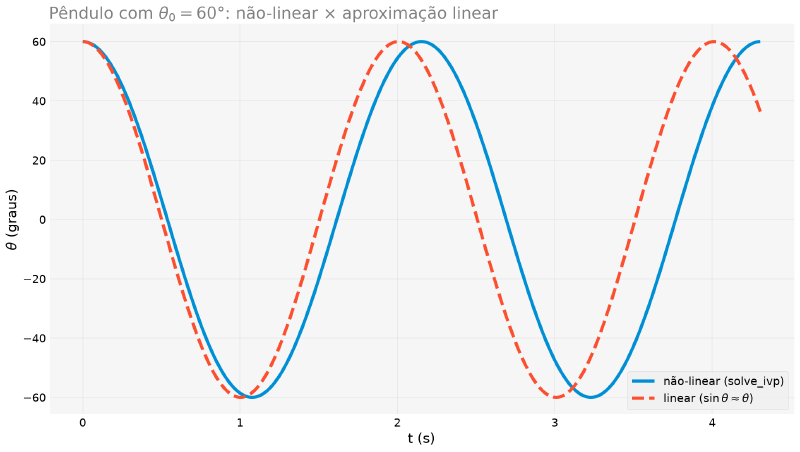
Mas cuidado com o que esse número significa. É tentador ler “\(69°\) de divergência” como “a aproximação erra o formato do movimento”, mas não é isso. A \(60°\), a solução não-linear ainda é bem parecida com uma senoide; o que muda é o período. E como a comparação acima roda por \(6\) s, ou seja, quase três oscilações, uma diferença pequena de período se acumula até as duas curvas ficarem fora de fase. Os \(69°\) medem deriva de fase acumulada, não erro de forma.
Medindo o Período de Verdade #
O gancho que abriu este artigo era exatamente sobre isso: um pêndulo solto
de um ângulo grande tem período maior que \(2\pi\sqrt{L/g}\). Chegou a
hora de pôr um número nisso, e a ferramenta certa é o parâmetro events
do solve_ivp, que interrompe (ou apenas registra) a integração quando uma
função do estado cruza zero.
Aqui, o pêndulo parte do repouso, então a velocidade angular \(\dot\theta\) volta a zero exatamente em cada extremo da oscilação. Detectar esse cruzamento dá meio período:
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81  # m/s^2
L = 1.0  # m


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


def velocidade_nula(t, y):
    return y[1]  # theta ponto

velocidade_nula.direction = 1  # só cruzamentos de negativo para positivo

T0 = 2 * np.pi * np.sqrt(L / g)

for theta0_graus in [10, 60, 90, 170]:
    theta0 = np.radians(theta0_graus)
    sol = solve_ivp(pendulo_nao_linear, [1e-9, 20], [theta0, 0.0],
                    events=velocidade_nula, rtol=1e-11, atol=1e-13)
    T = 2 * sol.t_events[0][0]
    print(f"theta0={theta0_graus:4d}°  T={T:.4f} s   T/T0={T/T0:.4f}")
theta0= 10° T=2.0099 s T/T0=1.0019
theta0= 60° T=2.1529 s T/T0=1.0732
theta0= 90° T=2.3678 s T/T0=1.1803
theta0= 170° T=4.8935 s T/T0=2.4394Agora sim o gancho está pago, e com números interpretáveis. A \(10°\), o período real excede a fórmula do ensino médio em \(0{,}2\%\), invisível em qualquer experimento de laboratório. A \(60°\), já são \(7{,}3\%\). A \(170°\), quase pendurado para cima, o pêndulo leva mais que o dobro do tempo previsto.
A solução exata do pêndulo existe, mas em termos de uma integral
elíptica completa de primeira espécie, \(K(m)\), que não é função
elementar, e é por isso que o dsolve não fecha:
O scipy.special.ellipk calcula \(K\), então dá para conferir a
medição numérica contra o valor exato:
import numpy as np
from scipy.integrate import solve_ivp
from scipy.special import ellipk

g = 9.81  # m/s^2
L = 1.0  # m


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


def velocidade_nula(t, y):
    return y[1]  # theta ponto

velocidade_nula.direction = 1  # só cruzamentos de negativo para positivo

T0 = 2 * np.pi * np.sqrt(L / g)

print(f"{'theta0':>7}  {'T numérico':>11}  {'T/T0':>7}  {'(2/pi)K':>8}  {'diferença':>10}")
for theta0_graus in [10, 60, 90, 170]:
    theta0 = np.radians(theta0_graus)
    sol = solve_ivp(pendulo_nao_linear, [1e-9, 20], [theta0, 0.0],
                    events=velocidade_nula, rtol=1e-11, atol=1e-13)
    T = 2 * sol.t_events[0][0]
    exato = (2 / np.pi) * ellipk(np.sin(theta0 / 2) ** 2)
    print(f"{theta0_graus:>6}°  {T:>11.5f}  {T/T0:>7.5f}  {exato:>8.5f}  {abs(T/T0 - exato):>10.2e}")
theta0 T numérico T/T0 (2/pi)K diferença
10° 2.00989 1.00191 1.00191 9.97e-10
60° 2.15287 1.07318 1.07318 9.96e-10
90° 2.36784 1.18034 1.18034 9.95e-10
170° 4.89352 2.43936 2.43936 9.22e-10Concordância na nona casa decimal nas quatro linhas, e o resíduo é o próprio critério de parada do evento, não erro do método.
Uma armadilha de convenção: existem duas notações para a integral
elíptica na literatura. Umas escrevem \(K(k)\), com o módulo \(k\);
outras, \(K(m)\), com o parâmetro \(m = k^2\). O SciPy usa a
segunda, daí o np.sin(theta0/2) ** 2, com o quadrado. Passar
\(k\) em vez de \(m\) não dá erro nenhum, só uma resposta silenciosamente
errada:
import numpy as np
from scipy.special import ellipk

theta0 = np.radians(60)
print("com m = sin²(θ₀/2), correto:", (2 / np.pi) * ellipk(np.sin(theta0 / 2) ** 2))
print("com k = sin(θ₀/2),  errado :", (2 / np.pi) * ellipk(np.sin(theta0 / 2)))
com m = sin²(θ₀/2), correto: 1.0731820071493645
com k = sin(θ₀/2), errado : 1.1803405990160962Repare no valor errado: \(1{,}1803\) é exatamente a resposta certa para \(\theta_0 = 90°\). Ou seja, o engano devolve um número perfeitamente plausível, do tipo que passaria despercebido numa revisão; é por isso que a conferência contra a solução numérica, feita acima, vale a pena mesmo quando existe fórmula exata.
Há também a aproximação de série que muitos livros trazem, \(T/T_0 \approx 1 + \theta_0^2/16\). Ela dá \(1{,}0019\) a \(10°\) e \(1{,}0685\) a \(60°\), boa nos dois primeiros casos. Mas prevê \(1{,}55\) a \(170°\), contra os \(2{,}44\) reais: um erro de \(36\%\). A degradação progressiva dessa série é, ela mesma, uma boa lição sobre até onde uma aproximação pode ser esticada.
Varrendo a amplitude de \(1°\) a \(179°\), as três descrições ficam lado a lado:
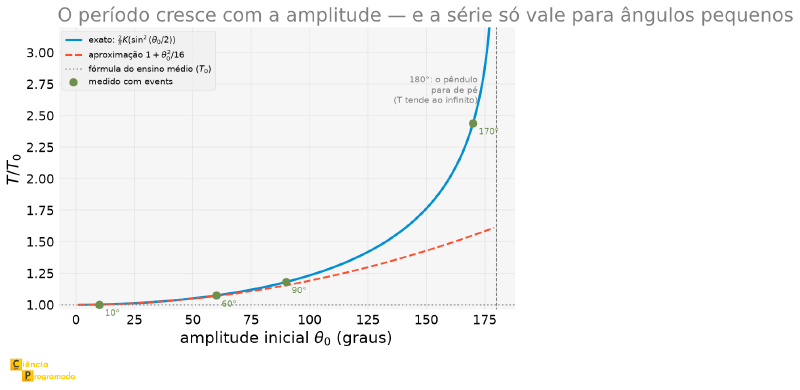
A linha pontilhada em \(1{,}0\) é o que a fórmula do ensino médio prevê: que o período não depende da amplitude. Ela é uma boa descrição até uns \(20°\), e é isso que torna um relógio de pêndulo possível, desde que oscile pouco.
E a divergência perto de \(180°\) tem significado físico direto: nessa amplitude o pêndulo chega ao topo com velocidade zero, em equilíbrio (instável). Levaria um tempo infinito para completar a oscilação.
Retrato de Fase: Todas as Soluções de Uma Vez #
Cada chamada de solve_ivp devolve uma curva, para uma condição
inicial. O retrato de fase mostra o conjunto: em vez de \(\theta\)
contra o tempo, plota-se \(\dot\theta\) contra \(\theta\), e cada
condição inicial vira uma trajetória fechada ou aberta nesse plano.
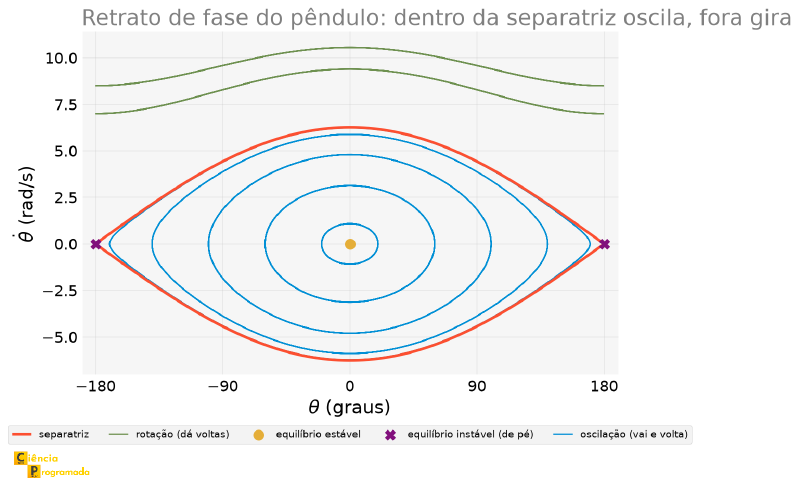
A figura resume a dinâmica inteira numa imagem:
- O ponto no centro é o equilíbrio estável (pêndulo parado embaixo). Perto dele, as curvas são quase elipses: é o regime linear, o do ensino médio.
- As curvas fechadas são oscilações. Quanto maior a órbita, maior a amplitude, e, como acabamos de ver, maior o período.
- Os dois “X” em \(\pm180°\) são o equilíbrio instável: o pêndulo em pé. São o mesmo ponto físico, já que \(-180°\) e \(+180°\) coincidem.
- A curva vermelha é a separatriz: a trajetória com exatamente a energia necessária para chegar ao topo, e nenhuma sobrando. É a fronteira entre os dois comportamentos, e é a ela que a divergência do período em \(180°\) corresponde.
- As curvas abertas, acima, são rotações: energia suficiente para passar do topo e continuar girando, sempre no mesmo sentido.
Repare que nada disso é visível numa única solução no tempo. É por isso que o retrato de fase é a ferramenta padrão para entender sistemas não lineares: ele mostra o que pode acontecer, não só o que aconteceu com uma condição inicial específica.
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81  # m/s^2
L = 1.0  # m


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


omega = np.sqrt(g / L)


def pendulo_linear(t, theta0):
    return theta0 * np.cos(omega * t)


theta0 = np.radians(60)

# 2 períodos do pêndulo NÃO-LINEAR (T = 2,153 s), em vez de 6 s fixos: assim
# a defasagem cresce visivelmente sem virar um emaranhado de curvas
t_span_fig = [0, 2 * 2.1529]
t_eval_fig = np.linspace(*t_span_fig, 400)
sol_pendulo = solve_ivp(pendulo_nao_linear, t_span_fig, [theta0, 0.0], t_eval=t_eval_fig, rtol=1e-8, atol=1e-10)

fig, ax = plt.subplots()
ax.plot(t_eval_fig, np.degrees(sol_pendulo.y[0]), label="não-linear (solve_ivp)")
ax.plot(t_eval_fig, np.degrees(pendulo_linear(t_eval_fig, theta0)), "--", label=r"linear ($\sin\theta\approx\theta$)")
ax.set_xlabel("t (s)")
ax.set_ylabel(r"$\theta$ (graus)")
ax.legend()
O gráfico a seguir deixa isso visível: as duas curvas começam juntas, mas se descolam rapidamente, porque a não-linear tem período maior (oscila mais devagar) que a aproximação linear:
Escolha de Método: Quando o Problema é Rígido #
solve_ivp aceita vários métodos via method=, e a escolha certa pode
ser a diferença entre resolver em milissegundos ou levar muito mais
tempo para resolver a mesma equação.
O Que “Rigidez” Quer Dizer #
Um exemplo clássico expõe o problema: \(y^{\prime} = -1000(y - \cos t)\). Essa equação embute duas escalas de tempo bem diferentes. O fator \(-1000\) faz qualquer desvio entre \(y\) e \(\cos t\) sumir quase instantaneamente: a escala de tempo dessa relaxação é \(1/1000 = 0{,}001\) s. Já o próprio \(\cos t\), que \(y\) passa a seguir de perto depois desse transiente inicial, varia numa escala bem mais lenta (período de \(2\pi \approx 6{,}3\) s). Um sistema assim, com uma componente que reage rapidíssimo e outra que evolui devagar, é chamado de rígido (stiff).
O problema não é falta de precisão, é estabilidade: um método como o
RK45 (visto a seguir) escolhe o tamanho do passo com base na dinâmica
mais rápida do sistema, e continua precisando de passos minúsculos mesmo
depois que essa dinâmica rápida já “morreu” e \(y\) já está evoluindo
suavemente junto com \(\cos t\). Se o passo ultrapassar o limite
imposto pela escala rápida, o método não fica só impreciso: ele diverge
numericamente (a solução oscila e explode). Por isso o integrador é
forçado a manter passos pequenos o tempo inteiro, mesmo na parte “fácil”
da solução, daí o custo.
Métodos Explícitos e Implícitos, Passo a Passo #
Todo método numérico para EDOs funciona da mesma forma geral: dado o valor atual, \(y_n\), calcular o próximo, \(y_{n+1}\), depois de um passo de tamanho \(h\). A diferença entre um método explícito e um implícito está em como esse cálculo é feito.
Um método é explícito quando calcula \(y_{n+1}\) direto, só com o que já é conhecido: o valor atual e a derivada nele (ou em pontos intermediários já calculados a partir dele). O caso mais simples, o método de Euler explícito:
$$y_{n+1} = y_n + h \cdot f(t_n, y_n)$$Tudo do lado direito já é um número conhecido antes do passo: é substituir e calcular.
Um método é implícito quando \(y_{n+1}\) aparece dos dois lados da equação, inclusive dentro da própria função que se está integrando. O equivalente implícito do Euler acima:
$$y_{n+1} = y_n + h \cdot f(t_{n+1}, y_{n+1})$$Como \(y_{n+1}\) é, ao mesmo tempo, o que se quer descobrir e um dos argumentos de \(f\) do lado direito, não dá para isolar numa conta direta: resolver essa equação normalmente exige um método iterativo (como o de Newton) a cada passo.
Os métodos de Runge-Kutta (RK45, RK23, DOP853, vistos na tabela a
seguir) seguem a lógica explícita, só que combinando várias avaliações
intermediárias de \(f\) numa fórmula mais precisa, mas sempre uma
conta direta, sem precisar resolver equação nenhuma. O custo extra por
passo de um método implícito compra estabilidade: sua região de
estabilidade é muito maior, e não depende da escala rápida do sistema do
jeito que a de um método explícito depende; por isso ele tolera passos
bem maiores em problemas rígidos, como o do exemplo acima.
import numpy as np
from scipy.integrate import solve_ivp


def rigido(t, y):
    return [-1000 * (y[0] - np.cos(t))]


for metodo in ["RK45", "Radau", "LSODA"]:
    sol = solve_ivp(rigido, [0, 2], [0.0], method=metodo)
    print(f"{metodo:>6}: sucesso={sol.success}  passos={len(sol.t)}  nfev={sol.nfev}")
RK45: sucesso=True passos=611 nfev=4238
Radau: sucesso=True passos=15 nfev=100
LSODA: sucesso=True passos=58 nfev=106RK45 precisou de \(611\) passos e \(4238\) avaliações da função
para resolver o mesmo problema que Radau resolve em \(15\) passos e
\(100\) avaliações, mais de 40 vezes menos trabalho. Esse é o sintoma
prático de rigidez: um número de passos ou de avaliações muito maior que
o esperado para o método explícito padrão, num problema que “não parece”
tão complicado.
4.238
RK45
100
Radau
40×
menos trabalho
Mas essas contagens dizem quanto, não onde. Plotando o tamanho de cada passo ao longo da integração, o mecanismo aparece:
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp


def rigido(t, y):
    return [-1000 * (y[0] - np.cos(t))]


fig, ax = plt.subplots(figsize=(9, 5.5))
for metodo, cor in (("RK45", "C1"), ("Radau", "C0"), ("LSODA", "C3")):
    sol_p = solve_ivp(rigido, [0, 2], [0.0], method=metodo)
    passos = np.diff(sol_p.t)          # o intervalo entre instantes consecutivos
    ax.semilogy(sol_p.t[1:], passos, "o-", color=cor, markersize=3, linewidth=1,
                label=f"{metodo} ({len(sol_p.t)} passos)")
    print(f"{metodo:>6}: passo mediano={np.median(passos):.2e}"
          f"  máximo={passos.max():.2e}")

ax.axhline(1 / 1000, color="C4", linestyle="--", linewidth=1.5,
           label="escala de tempo rápida (1/1000 s)")
ax.set_xlabel("t (s)")
ax.set_ylabel("tamanho do passo h")
ax.legend(fontsize=9)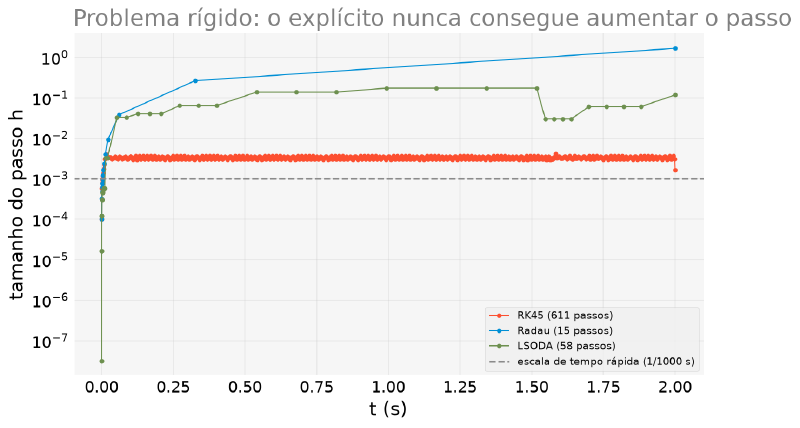
  RK45: passo mediano=3.25e-03  máximo=4.18e-03
 Radau: passo mediano=1.43e-03  máximo=1.67e+00
 LSODA: passo mediano=5.75e-04  máximo=1.75e-01
O passo máximo conta a história inteira. O RK45 nunca passa de
\(4{,}2\times10^{-3}\), sempre na mesma ordem de grandeza da escala de
tempo rápida do problema (\(1/1000\) s), do começo ao fim. O Radau
chega a \(1{,}67\), quatrocentas vezes maior.
E é isso que rigidez significa na prática. Depois do transiente inicial, a solução é suave: \(y\) simplesmente acompanha \(\cos t\), e um passo grande daria conta da precisão sem problema. Mas o método explícito não pode aumentar o passo: não por falta de precisão, e sim porque acima de um certo \(h\) ele fica instável e a solução explode. Ele permanece refém de uma dinâmica rápida que já não existe mais.
O Que Significa “Ordem p(q)” #
Antes da tabela, vale entender a notação “ordem \(p(q)\)” que aparece em quase todo método. Ela descreve um par encaixado (embedded pair) de fórmulas, que rodam juntas reaproveitando as mesmas avaliações intermediárias de \(f\):
- A solução que de fato avança, \(y_{n+1}\), vem da fórmula de ordem \(p\) (a maior). “Ordem \(p\)” quer dizer que o erro acumulado ao longo da integração cai como \(O(h^p)\), o mesmo conceito de ordem já visto no artigo de derivadas numéricas com as diferenças finitas (a central era \(O(h^2)\), a progressiva/regressiva, \(O(h)\)): quanto maior a ordem, mais rápido o erro cai quando \(h\) diminui.
- A fórmula de ordem \(q\) (a menor, entre parênteses) não avança a
solução: serve só para estimar o erro do passo, comparando seu
resultado com o da fórmula de ordem \(p\). Como as duas fórmulas
compartilham as avaliações de \(f\), essa estimativa sai sem custo
extra, e é o que permite ao
solve_ivpcrescer ou encolher \(h\) sozinho ao longo da integração (passo adaptativo), sem que o usuário precise fixar um valor.
Então “RK45, ordem 5(4)” lê-se: avança com a fórmula de 5ª ordem, mede o
erro do passo com uma fórmula de 4ª ordem embutida nela.
Guia Rápido de Métodos #
A tabela a seguir resume as opções do solve_ivp, com o nome completo
por trás de cada sigla e quando cada uma se justifica:
| Método | Nome por trás da sigla | Tipo | Quando usar |
|---|---|---|---|
RK45 (padrão) |
Runge-Kutta, par de fórmulas de Dormand-Prince, ordem 5(4) | Explícito | Primeira escolha para a maioria dos problemas não rígidos, bom equilíbrio entre custo e precisão |
RK23 |
Runge-Kutta, par de fórmulas de Bogacki-Shampine, ordem 3(2) | Explícito | Precisão baixa é aceitável, ou o campo campo(t, y) é caro de avaliar e menos avaliações por passo importa mais que a ordem |
DOP853 |
Runge-Kutta de Dormand-Prince, ordem 8 | Explícito | Problema suave e não rígido em que se precisa de alta precisão, mais exato que RK45, ao custo de mais avaliações por passo |
Radau |
Runge-Kutta implícito da família Radau IIA, ordem 5(3) | Implícito | Problemas rígidos em que também se precisa de alta precisão |
BDF |
Backward Differentiation Formulas (fórmulas de diferenciação regressiva), ordem variável de 1 a 5 | Implícito | Problemas rígidos de muitas variáveis, robusto e eficiente em sistemas grandes |
LSODA |
Solver do pacote ODEPACK (Lawrence Livermore National Laboratory), alterna automaticamente entre um método tipo Adams (não rígido) e BDF |
Automático | Quando não se sabe de antemão se o problema é rígido, detecta a transição e troca de método sozinho |
(Os nomes completos e a origem de cada método vêm da própria documentação do SciPy, que cita os artigos originais de cada um.)
Sem essa tabela como referência, a escolha padrão razoável é sempre
RK45; só vale trocar quando o sintoma de rigidez aparecer (passos ou
nfev bem acima do esperado) ou quando a precisão de RK45 não for
suficiente para um problema que se sabe suave.
Aplicações Reais #
Com a mecânica básica e a escolha de método estabelecidas, seguem cinco aplicações, das mais simples (com solução fechada, para validar) até as que não fecham de jeito nenhum.
Exemplo 1: Crescimento populacional logístico
Enunciado: Uma população cresce segundo o modelo logístico, \(\frac{dP}{dt} = rP\left(1 - \frac{P}{K}\right)\), com taxa de crescimento \(r = 0{,}5\) ano\(^{-1}\), capacidade de suporte \(K=100\) e população inicial \(P_0=5\). Resolva numericamente e compare com a solução analítica conhecida.
Solução: A solução fechada desse modelo é \(P(t) = \dfrac{K}{1 + (K/P_0 - 1)e^{-rt}}\):
import numpy as np
from scipy.integrate import solve_ivp

r, K, P0 = 0.5, 100.0, 5.0


def logistica(t, P):
    return [r * P[0] * (1 - P[0] / K)]


def logistica_analitica(t):
    return K / (1 + (K / P0 - 1) * np.exp(-r * t))


t_eval_log = np.linspace(0, 20, 200)
sol_log = solve_ivp(logistica, [0, 20], [P0], t_eval=t_eval_log, rtol=1e-8, atol=1e-10)
erro = np.max(np.abs(sol_log.y[0] - logistica_analitica(t_eval_log)))
print("erro máximo:", erro)
erro máximo: 5.216148338149651e-06Erro da ordem de \(10^{-6}\): a EDO não-linear é resolvida numericamente sem que o modelo precise ser linearizado nem simplificado em nada, e o resultado bate com a fórmula fechada dentro da tolerância pedida.
Exemplo 2: Lotka-Volterra: predador e presa
Enunciado: O modelo predador-presa de Lotka-Volterra descreve duas populações acopladas:
$$\frac{dP}{dt} = \alpha P - \beta P Q, \qquad \frac{dQ}{dt} = \delta P Q - \gamma Q$$A presa \(P\) cresce sozinha (\(\alpha\)) e é comida (\(\beta PQ\)); o predador \(Q\) morre sozinho (\(\gamma\)) e se reproduz comendo (\(\delta PQ\)). Resolva com \(\alpha=1\), \(\beta=0{,}02\), \(\delta=0{,}01\), \(\gamma=0{,}5\), partindo de 40 presas e 9 predadores.
Solução: Este é o primeiro exemplo do artigo com parâmetros passados
via args, em vez de capturados do escopo global, que é a forma
recomendada, e evita a classe de bug em que mexer numa variável global
muda silenciosamente o resultado de outra célula:
import numpy as np
from scipy.integrate import solve_ivp

def lotka_volterra(t, y, alpha, beta, delta, gamma):
    presa, predador = y
    return [alpha * presa - beta * presa * predador,
            delta * presa * predador - gamma * predador]

parametros = (1.0, 0.02, 0.01, 0.5)   # alpha, beta, delta, gamma
sol_lv = solve_ivp(lotka_volterra, [0, 40], [40.0, 9.0],
                   t_eval=np.linspace(0, 40, 2000),
                   args=parametros, rtol=1e-10, atol=1e-12)
O sistema é genuinamente não linear (o termo \(PQ\) acopla os dois) e não tem solução fechada. Mas tem uma quantidade conservada:
$$V = \delta P - \gamma\ln P + \beta Q - \alpha\ln Q$$que serve de teste de qualidade do integrador, do mesmo jeito que a conservação de massa servirá no exemplo da cinética:
import numpy as np
from scipy.integrate import solve_ivp

def lotka_volterra(t, y, alpha, beta, delta, gamma):
    presa, predador = y
    return [alpha * presa - beta * presa * predador,
            delta * presa * predador - gamma * predador]

parametros = (1.0, 0.02, 0.01, 0.5)   # alpha, beta, delta, gamma
sol_lv = solve_ivp(lotka_volterra, [0, 40], [40.0, 9.0],
                   t_eval=np.linspace(0, 40, 2000),
                   args=parametros, rtol=1e-10, atol=1e-12)

presa, predador = sol_lv.y
V = 0.01 * presa - 0.5 * np.log(presa) + 0.02 * predador - 1.0 * np.log(predador)
print(f"variação relativa do invariante: {(V.max() - V.min()) / abs(V.mean()):.2e}")
variação relativa do invariante: 7.30e-10Os dois painéis a seguir mostram o resultado no tempo e no plano de fase:
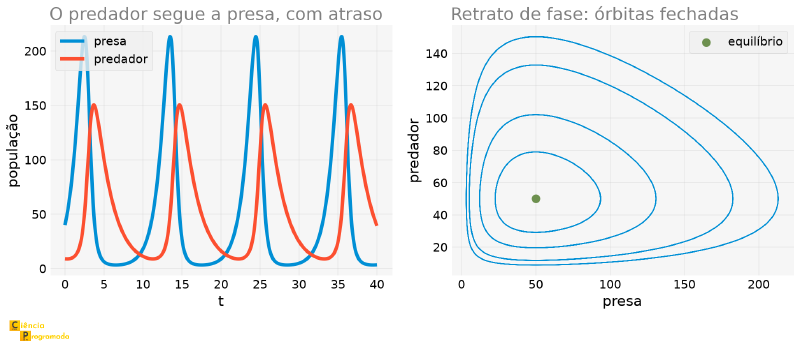
O painel da esquerda mostra o comportamento que dá nome ao modelo. As duas populações oscilam, mas defasadas: o predador só prospera depois que a presa prosperou, e o colapso do predador vem depois do colapso da presa.
O da direita é o retrato de fase, a mesma ferramenta usada no pêndulo: cada condição inicial gera uma órbita fechada em torno do equilíbrio em \((50, 50)\), que é onde as duas derivadas se anulam (\(P^\ast = \gamma/\delta\), \(Q^\ast = \alpha/\beta\)). Órbita fechada significa que o sistema volta exatamente ao ponto de partida: as oscilações não amortecem nem crescem, o que é uma peculiaridade deste modelo, e uma das razões de ele ser mais um retrato caricato que uma descrição realista de ecossistemas.
Exemplo 3: Circuito RC carregando
Enunciado: Um capacitor descarregado (\(V(0)=0\)) é conectado a uma fonte de \(5\) V através de um resistor de \(1\) k\(\Omega\) e um capacitor de \(1\) mF. Encontre a tensão no capacitor ao longo do tempo.
Solução: A EDO linear de 1ª ordem \(RC\dfrac{dV}{dt} + V = V_0\) tem solução fechada conhecida, \(V(t) = V_0(1 - e^{-t/RC})\), mais uma validação com solução fechada antes de avançar para exemplos mais complexos:
import numpy as np
from scipy.integrate import solve_ivp

R, C, V0 = 1e3, 1e-3, 5.0  # ohm, F, V
tau = R * C


def rc_carregando(t, V):
    return [(V0 - V[0]) / tau]


t_eval_rc = np.linspace(0, 5 * tau, 200)
sol_rc = solve_ivp(rc_carregando, [0, 5 * tau], [0.0], t_eval=t_eval_rc, rtol=1e-8, atol=1e-10)
V_analitica = V0 * (1 - np.exp(-t_eval_rc / tau))
print("erro máximo:", np.max(np.abs(sol_rc.y[0] - V_analitica)))
erro máximo: 9.250205046384963e-09
Exemplo 4: Queda com resistência do ar quadrática
Enunciado: Um objeto de massa \(80\) kg cai a partir do repouso, sujeito à gravidade e a uma resistência do ar proporcional ao quadrado da velocidade (\(F_{\text{arrasto}} = -kv^2\), com \(k=0{,}25\) kg/m, modelo mais realista que o arrasto linear em velocidades maiores). Encontre a velocidade em função do tempo.
Solução: A equação de movimento é \(m\dfrac{dv}{dt} = mg - kv^2\). A velocidade terminal, onde \(dv/dt=0\), sai de imediato: \(v_t = \sqrt{mg/k}\).
import numpy as np
from scipy.integrate import solve_ivp

m, g_local, k = 80.0, 9.81, 0.25  # kg, m/s^2, kg/m
v_terminal = np.sqrt(m * g_local / k)


def queda_com_arrasto(t, v):
    return [g_local - (k / m) * v[0] ** 2]


t_eval_queda = np.linspace(0, 15, 200)
sol_queda = solve_ivp(queda_com_arrasto, [0, 15], [0.0], t_eval=t_eval_queda,
                      rtol=1e-10, atol=1e-12)
print("velocidade terminal:", round(v_terminal, 2), "m/s")
print("velocidade em t=15s:", round(sol_queda.y[0][-1], 2), "m/s")
velocidade terminal: 56.03 m/s
velocidade em t=15s: 55.45 m/sAos 15 s, o objeto já está a \(98{,}9\%\) da velocidade terminal, mas formalmente nunca a atinge, já que \(v_t\) é um limite assintótico, não um valor alcançado em tempo finito.
E este caso ainda tem forma fechada, o que faz dele a terceira validação desta sequência de exemplos. Separando as variáveis em \(dv/(1 - v^2/v_t^2) = g\ dt\) e integrando, chega-se a uma tangente hiperbólica:
$$v(t) = v_t \tanh\left(\frac{g t}{v_t}\right)$$import numpy as np
from scipy.integrate import solve_ivp
m, g_local, k = 80.0, 9.81, 0.25 # kg, m/s^2, kg/m
v_terminal = np.sqrt(m * g_local / k)
def queda_com_arrasto(t, v):
return [g_local - (k / m) * v[0] ** 2]
t_eval_queda = np.linspace(0, 15, 200)
sol_queda = solve_ivp(queda_com_arrasto, [0, 15], [0.0], t_eval=t_eval_queda,
rtol=1e-10, atol=1e-12)
v_analitica = v_terminal * np.tanh(g_local * t_eval_queda / v_terminal)
print("erro máximo:", np.max(np.abs(sol_queda.y[0] - v_analitica)))erro máximo: 1.00780468414996e-08Bate na oitava casa decimal, puro resíduo de tolerância. É um resultado clássico da mecânica, e é bom que apareça aqui: “tem arrasto quadrático” não é sinônimo de “não fecha”.
O artigo sobre órbitas e trajetórias desta série já tinha resolvido um problema da mesma família (projétil sob resistência do ar), mas como equação transcendental para o tempo de voo, com arrasto linear (\(F_{\text{arrasto}} = -kmv\), 2D, com ângulo de lançamento). Aqui a física é outra (arrasto quadrático, só a componente vertical), mas a virada de abordagem é a mesma lição: sem arrasto simplificado o suficiente para isolar uma variável numa equação fechada, resolver a EDO diretamente no tempo é o caminho.
Exemplo 5: Cinética química: reações consecutivas
Enunciado: Numa reação \(A \to B \to C\), com constantes de velocidade \(k_1=0{,}3\) s\(^{-1}\) e \(k_2=0{,}1\) s\(^{-1}\), partindo de \(A_0=1\) mol/L e nada de \(B\) ou \(C\), encontre as concentrações das três espécies ao longo do tempo.
Solução: O sistema de EDOs acopladas é \(\frac{dA}{dt}=-k_1A\), \(\frac{dB}{dt}=k_1A-k_2B\), \(\frac{dC}{dt}=k_2B\), três equações encadeadas, cada uma alimentando a seguinte:
import numpy as np
from scipy.integrate import solve_ivp

k1, k2 = 0.3, 0.1  # 1/s
A0 = 1.0


def reacoes_consecutivas(t, y):
    A, B, C = y
    return [-k1 * A, k1 * A - k2 * B, k2 * B]


t_eval_cin = np.linspace(0, 30, 300)
sol_cin = solve_ivp(
    reacoes_consecutivas, [0, 30], [A0, 0.0, 0.0], t_eval=t_eval_cin, rtol=1e-8, atol=1e-10
)

A_analitica = A0 * np.exp(-k1 * t_eval_cin)
print("erro máximo em A(t):", np.max(np.abs(sol_cin.y[0] - A_analitica)))
print("desvio da conservação de massa:", np.max(np.abs(sol_cin.y.sum(axis=0) - A0)))
erro máximo em A(t): 4.733793357303284e-10
desvio da conservação de massa: 4.440892098500626e-16Duas conferências: \(A(t)\) bate com a exponencial pura (já que \(A\) não depende de \(B\) nem \(C\)), e a soma \(A+B+C\) permanece igual a \(A_0\) o tempo todo. É a conservação de massa, que nenhuma linha de código impôs explicitamente e que só decorre de como as três equações foram escritas.
E dá para conferir mais. Este sistema, apesar de acoplado, tem solução fechada, um resultado clássico da cinética química:
$$B(t) = \frac{k_1 A_0}{k_2-k_1}\left(e^{-k_1t}-e^{-k_2t}\right)$$import numpy as np
from scipy.integrate import solve_ivp
k1, k2 = 0.3, 0.1 # 1/s
A0 = 1.0
def reacoes_consecutivas(t, y):
A, B, C = y
return [-k1 * A, k1 * A - k2 * B, k2 * B]
t_eval_cin = np.linspace(0, 30, 300)
sol_cin = solve_ivp(
reacoes_consecutivas, [0, 30], [A0, 0.0, 0.0], t_eval=t_eval_cin, rtol=1e-8, atol=1e-10
)
B_analitica = A0 * k1 / (k2 - k1) * (np.exp(-k1 * t_eval_cin) - np.exp(-k2 * t_eval_cin))
print("erro máximo em B(t):", np.max(np.abs(sol_cin.y[1] - B_analitica)))erro máximo em B(t): 7.066555118839801e-10Terceira conferência, e a mais exigente das três: a curva inteira do intermediário, com seu pico característico, reproduzida na nona casa decimal.
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp

k1, k2 = 0.3, 0.1  # 1/s
A0 = 1.0


def reacoes_consecutivas(t, y):
    A, B, C = y
    return [-k1 * A, k1 * A - k2 * B, k2 * B]


t_eval_cin = np.linspace(0, 30, 300)
sol_cin = solve_ivp(
    reacoes_consecutivas, [0, 30], [A0, 0.0, 0.0], t_eval=t_eval_cin, rtol=1e-8, atol=1e-10
)

fig, ax = plt.subplots()
for serie, nome in zip(sol_cin.y, ["A", "B", "C"]):
    ax.plot(t_eval_cin, serie, label=nome)
ax.set_xlabel("t (s)")
ax.set_ylabel("concentração (mol/L)")
ax.legend()
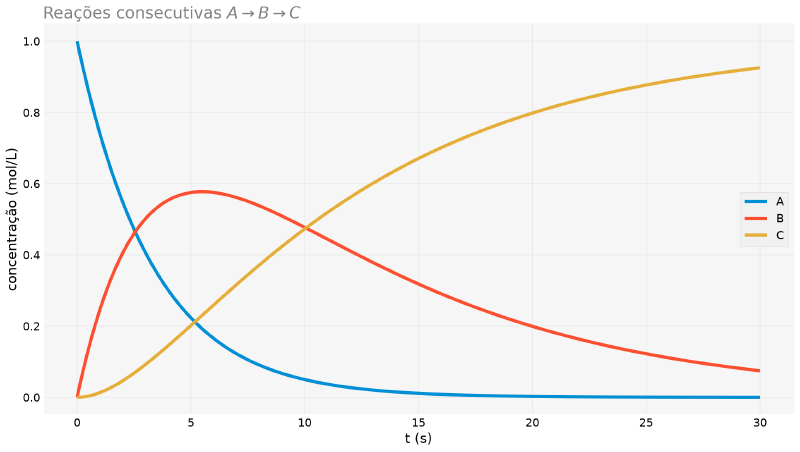
O gráfico a seguir mostra as três concentrações ao longo do tempo:
Onde a Fórmula Fechada Quebra de Verdade #
Se o sistema fecha, por que resolvê-lo numericamente? Porque a fórmula é frágil de dois jeitos, e os dois aparecem cedo.
Primeiro: ela explode quando \(k_1 = k_2\). Repare no \(k_2 - k_1\) no denominador. Não é uma singularidade física (duas etapas com a mesma constante de velocidade são perfeitamente razoáveis): é uma singularidade da fórmula. Em Python, o resultado é literalmente uma exceção:
import numpy as np

A0 = 1.0
t = np.linspace(0, 30, 300)

k1 = k2 = 0.2
B_analitica = A0 * k1 / (k2 - k1) * (np.exp(-k1 * t) - np.exp(-k2 * t))
ZeroDivisionError: float division by zeroA solução correta nesse caso existe, mas tem outra forma funcional, em que some a diferença de exponenciais e entra um fator \(t\):
$$ B(t) = A_0 k t e^{-kt} $$Para chegar a ela é preciso refazer a integração do zero, ou tomar o limite
\(k_2 \to k_1\) com L’Hôpital. Já o solve_ivp não percebe diferença
nenhuma. É o mesmo campo, o mesmo código, e a resposta sai certa:
import numpy as np
from scipy.integrate import solve_ivp

k1 = k2 = 0.2  # o caso degenerado
A0 = 1.0


def reacoes_consecutivas(t, y):
    A, B, C = y
    return [-k1 * A, k1 * A - k2 * B, k2 * B]


t_eval_cin = np.linspace(0, 30, 300)
sol_deg = solve_ivp(reacoes_consecutivas, [0, 30], [A0, 0.0, 0.0],
                    t_eval=t_eval_cin, rtol=1e-8, atol=1e-10)
print("erro contra A0*k*t*exp(-k*t):",
      np.max(np.abs(sol_deg.y[1] - A0 * 0.2 * t_eval_cin * np.exp(-0.2 * t_eval_cin))))
erro contra A0*k*t*exp(-k*t): 8.172407195417009e-10Segundo: ela não sobrevive a um mecanismo um pouco mais realista. Basta tornar a primeira etapa reversível (\(A \rightleftharpoons B \to C\), com uma constante \(k_{-1}\) de volta) para que o sistema deixe de ser uma cascata e vire genuinamente acoplado:
k1, k_menos1, k2 = 0.3, 0.15, 0.1

def reacoes_reversiveis(t, y):
    A, B, C = y
    return [-k1 * A + k_menos1 * B,
            k1 * A - k_menos1 * B - k2 * B,
            k2 * B]
Agora \(A\) depende de \(B\), que depende de \(A\). Resolver isso à
mão significa achar os autovalores de uma matriz \(3\times3\) (as raízes
de um polinômio característico cúbico) e montar a solução como combinação
de três exponenciais com esses expoentes. É possível, é feio, e some
completamente assim que se acrescenta uma quarta espécie ou uma etapa de
segunda ordem (onde nem existe solução fechada). Para o solve_ivp, a
mudança é de três linhas.
Esse é o padrão que se repete em toda esta série: a forma fechada não some de uma vez, ela se degrada. Primeiro vira um caso especial que precisa de tratamento à parte, depois vira uma expressão que ninguém quer escrever, depois não existe mais. O método numérico atravessa os três estágios sem mudar de código, e é por isso que vale ter a validação analítica enquanto ela existe: é o que dá confiança para usá-lo quando ela acaba.
O artigo de derivadas numéricas estimou a taxa de uma cinética de 1ª ordem a partir de dados de concentração medidos, sem modelo nenhum. Aqui a lógica se inverte: partindo do modelo (as constantes \(k_1\), \(k_2\) e o mecanismo em duas etapas), a EDO gera a concentração ao longo do tempo, inclusive o pico característico do intermediário \(B\), em \(t = \ln(k_1/k_2)/(k_1-k_2) \approx 5{,}49\) s, que uma cinética de 1ª ordem pura jamais produziria.
Pontos de Atenção #
A mesma EDO do pêndulo, com condições iniciais diferentes (\(10°\), \(60°\) ou \(170°\), todas partindo do repouso), gera curvas com períodos diferentes: 2,01 s, 2,15 s e 4,89 s. Isso é uma peculiaridade das equações não lineares que vale destacar: num oscilador linear, o período não depende da amplitude (é o que torna um relógio de pêndulo possível, desde que oscile pouco). Assim que o \(\sin\theta\) entra sem aproximação, essa independência acaba.
solve_ivp sempre resolve um PVI específico: muda a condição inicial,
muda a curva inteira. É bem diferente da família geral que o dsolve
simbólico devolve, com a constante \(C_1\) em aberto: ali, “a solução”
é uma família; aqui, é sempre uma curva.
atol, rtol) afeta o resultado silenciosamente
Resolvendo o pêndulo de \(60°\) duas vezes, com tolerâncias diferentes:
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81  # m/s^2
L = 1.0  # m


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


t_span = [0, 6]
t_eval = np.linspace(*t_span, 400)
theta0 = np.radians(60)

sol_apertada = solve_ivp(pendulo_nao_linear, t_span, [theta0, 0.0], t_eval=t_eval, rtol=1e-10, atol=1e-12)
sol_frouxa = solve_ivp(pendulo_nao_linear, t_span, [theta0, 0.0], t_eval=t_eval, rtol=1e-2, atol=1e-2)
diff = np.max(np.abs(np.degrees(sol_apertada.y[0] - sol_frouxa.y[0])))
print("divergência máxima:", round(diff, 3), "graus")
divergência máxima: 12.628 grausMais de \(12°\) de diferença entre dois solve_ivp “aparentemente
iguais”: mesma EDO, mesma condição inicial, só a tolerância mudou.
Repare onde o padrão fica nessa comparação: rtol=1e-3 está entre as
duas, dez vezes mais apertado que a versão frouxa e dez milhões de vezes
mais frouxo que a apertada. Ou seja, aceitar o padrão sem pensar não é
uma escolha neutra: é uma escolha, e neste problema ela ainda deixaria
erro visível a olho nu depois de algumas oscilações.
A receita prática é simples: resolva duas vezes, com tolerâncias diferentes, e compare. Se as duas curvas coincidem, a tolerância mais frouxa já bastava. Se não coincidem, aperte até que coincidam. É o equivalente, para EDOs, do “confira o resíduo” que o artigo sobre raízes recomendava.
import matplotlib.pyplot as plt
import numpy as np
from scipy.integrate import solve_ivp

g = 9.81  # m/s^2
L = 1.0  # m


def pendulo_nao_linear(t, y):
    theta, theta_ponto = y
    return [theta_ponto, -(g / L) * np.sin(theta)]


t_span = [0, 6]
t_eval = np.linspace(*t_span, 400)
theta0 = np.radians(60)

sol_apertada = solve_ivp(pendulo_nao_linear, t_span, [theta0, 0.0], t_eval=t_eval, rtol=1e-10, atol=1e-12)
sol_frouxa = solve_ivp(pendulo_nao_linear, t_span, [theta0, 0.0], t_eval=t_eval, rtol=1e-2, atol=1e-2)

fig, ax = plt.subplots()
ax.plot(t_eval, np.degrees(sol_apertada.y[0]), label="tolerância apertada")
ax.plot(t_eval, np.degrees(sol_frouxa.y[0]), "--", label="tolerância frouxa (rtol=atol=1e-2)")
ax.set_xlabel("t (s)")
ax.set_ylabel(r"$\theta$ (graus)")
ax.legend()
As duas curvas partem juntas e se descolam com o tempo, o mesmo tipo de divergência progressiva já visto entre o pêndulo não-linear e sua aproximação linear, agora causada só pela tolerância numérica:
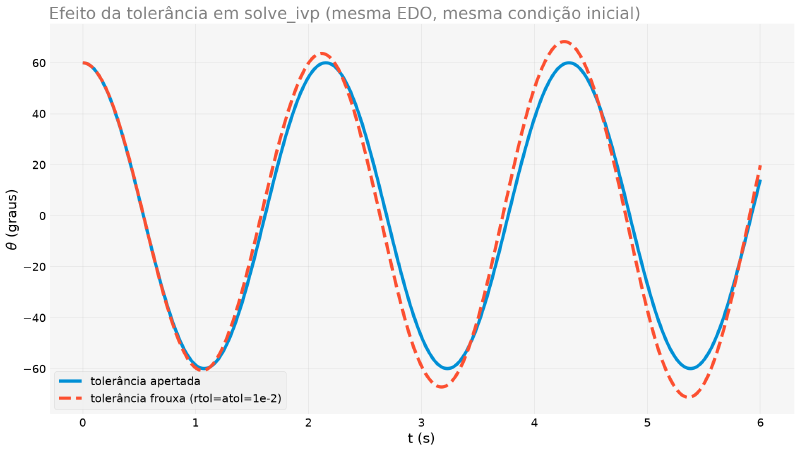
Tabela-Resumo #
| Ferramenta / conceito | Uso | Observação |
|---|---|---|
dsolve (SymPy) |
Solução geral simbólica, com constantes em aberto | Só funciona quando existe forma fechada |
solve_ivp(campo, t_span, y0) |
Solução numérica de um PVI específico | campo(t, y) devolve a derivada de cada componente de y |
dense_output=True |
Permite avaliar a solução em qualquer ponto após resolver | Usa sol.sol(t) |
| Método explícito | Calcula \(y_{n+1}\) direto, só com valores já conhecidos | Conta simples, sem resolver equação, mas instável em problemas rígidos com passo grande |
| Método implícito | \(y_{n+1}\) aparece dos dois lados da equação | Mais caro por passo (exige resolver a equação), mas muito mais estável |
| Ordem \(p(q)\) | Par encaixado: avança com a fórmula de ordem \(p\), estima erro com a de ordem \(q\) | Base do passo adaptativo, erro estimado sem avaliações extras |
method="RK45" (padrão) |
Runge-Kutta explícito | Rápido na maioria dos casos; ineficiente em problemas rígidos |
method="Radau" / "BDF" |
Métodos implícitos | Escolha para sistemas rígidos (stiff) |
method="LSODA" |
Detecta rigidez automaticamente | Alterna de método sozinho |
| Sintoma de rigidez | Número de passos/avaliações muito acima do esperado | Comparar len(sol.t) ou sol.nfev entre métodos |
| Condição inicial | Determina qual curva específica é obtida | Diferente da família geral do dsolve |
Tolerância (rtol, atol) |
Controla precisão vs. custo computacional | Duas soluções com tolerâncias diferentes podem divergir visivelmente |
Próximos Passos #
Este artigo cobriu como resolver uma equação diferencial quando não há
solução fechada, mas sempre partindo de um modelo já escrito, com as
equações e os parâmetros conhecidos de antemão. Falta um problema
irmão: e se o que se quer não é resolver a EDO, mas encontrar os
melhores parâmetros para um modelo, ou o ponto de mínimo (ou máximo)
de uma função sem fórmula fechada para sua derivada? No
próximo artigo,
o scipy.optimize ataca justamente esse problema, e, mais adiante na
série, num artigo de aplicações de otimização, a própria equação
diferencial resolvida aqui volta a aparecer como parte do modelo a
otimizar.