
Em 1609, o astrônomo alemão Johannes Kepler publicou duas leis que mudariam para sempre a forma como entendemos o movimento dos planetas. A primeira era revolucionária para a época: as órbitas não são círculos perfeitos, como Ptolomeu e até Copérnico acreditavam, mas elipses, com o Sol em um dos focos. A segunda — a “lei das áreas” — dizia que um planeta varre áreas iguais em tempos iguais ao longo de sua órbita: mais rápido perto do Sol, mais devagar longe dele.
Lindo do ponto de vista geométrico. Mas escondia um problema prático incômodo. Se um astrônomo quisesse saber exatamente onde um planeta estaria em um instante específico — não “em algum momento”, mas às 14h32 de uma data determinada — precisava resolver uma equação. Essa equação, batizada mais tarde de equação de Kepler, é:
$$ M = E - e \sin(E) $$onde \(M\) é a anomalia média (proporcional ao tempo decorrido — fácil de calcular), \(e\) é a excentricidade da órbita (o quão “achatada” é a elipse) e \(E\) é a anomalia excêntrica — o ângulo que de fato conecta o tempo à posição do planeta na órbita. Dados \(M\) e \(e\), queremos \(E\).
O problema: essa equação mistura \(E\) livre com \(\sin(E)\). Não existe nenhuma manipulação algébrica capaz de isolar \(E\) de um lado só. Gerações de astrônomos, de Kepler a Gauss, desenvolveram métodos e tabelas só para contornar essa equação — muito antes de “método numérico” ser um termo formal.
Será que alguma ferramenta atual resolve isso de forma exata? Vamos deixar o SymPy tentar:
import sympy as sp

E, M, e = sp.symbols("E M e")
kepler_eq = sp.Eq(M, E - e * sp.sin(E))

sp.solve(kepler_eq, E)
NotImplementedError: multiple generators [E, sin(E)]
No algorithms are implemented to solve equation M + (-E + e*sin(E))Nem o SymPy, com toda a sua força simbólica, dá conta. E não é um problema de a biblioteca ser “fraca” — é a natureza da equação: ela mistura um polinômio (\(E\)) com uma função transcendente (\(\sin E\)) na mesma incógnita, e não existe fórmula fechada, em termos de funções elementares, que resolva isso em geral.
Este é o primeiro de três artigos sobre uma dessas soluções: resolver numericamente, com o SciPy, equações que o SymPy não consegue resolver simbolicamente.
Por Que Resolver Equações Numericamente Importa? #
A equação de Kepler não é uma curiosidade isolada. Equações sem solução em forma fechada aparecem o tempo todo em problemas reais:
- Engenharia: o fator de atrito em escoamento de fluidos em tubulações
(equação de Colebrook) é definido implicitamente — décadas de engenheiros
resolveram isso por iteração manual antes de existir
scipy.optimize. - Química: equações de estado de gases reais (como a de van der Waals) e equilíbrios químicos completos, sem as aproximações simplificadoras de livro-texto, viram polinômios ou equações transcendentais sem fórmula fechada prática.
- Astronomia e aeroespacial: a própria equação de Kepler é resolvida numericamente, bilhões de vezes por dia, em software de navegação de satélites e sondas espaciais.
- Finanças: a taxa interna de retorno (TIR) de um fluxo de caixa é a raiz de um polinômio — e, para graus altos, não existe garantia de fórmula fechada (veja a nota a seguir).
- Ciência de dados e otimização: encontrar pontos críticos de funções de perda complexas é, no fundo, resolver “derivada igual a zero” — uma equação que raramente tem solução fechada em modelos não triviais.
Em 1824, o matemático norueguês Niels Henrik Abel provou que não existe fórmula geral, envolvendo apenas radicais, que resolva toda equação polinomial de grau 5 ou superior — o Teorema de Abel-Ruffini. Ou seja, mesmo restringindo a problemas puramente polinomiais (nada de senos ou exponenciais), a ausência de solução fechada não é exceção: é a regra a partir de um certo grau. Métodos numéricos não são um substituto de segunda classe para a álgebra — são, com frequência, a única ferramenta que existe.
O resultado tem três nomes e três tempos. O italiano Paolo Ruffini publicou uma primeira demonstração em 1799, com uma lacuna que passou despercebida por décadas; Abel a fechou em 1824, de forma independente. Mas foi o francês Évariste Galois quem, por volta de 1832, respondeu à pergunta maior: não só que não existe fórmula geral, mas quais equações específicas têm solução por radicais e quais não têm — e a resposta depende da estrutura de simetria das raízes, dando origem à teoria de grupos. Galois morreu num duelo aos 20 anos, e seus manuscritos só foram compreendidos mais de uma década depois.
Já escrevemos bastante aqui no site sobre o SymPy, a biblioteca simbólica de Python: ela resolve equações e sistemas de forma exata sempre que existe uma solução em forma fechada. O SciPy entra exatamente onde o SymPy para: quando não existe fórmula, ele aproxima a resposta numericamente, com controle de erro e (quase sempre) muita velocidade.
Terreno Conhecido, Agora em Números #
Antes de atacar o que o SymPy não resolve, vale ver como o SciPy se sai com problemas que o SymPy já resolve com exatidão — para comparar diretamente. E, já que o NumPy vai aparecer o artigo inteiro ao lado do SciPy, vale explicar por quê antes de seguir.
O SciPy é construído sobre o NumPy: usa o mesmo array (ndarray) como
estrutura de dado central e depende dele para funcionar. A divisão de
trabalho, historicamente, ficou assim — o NumPy cuida do array em si:
operações elementares, um pouco de álgebra linear e de transformadas de
Fourier, geração de números aleatórios, e alguns utilitários genéricos de
comparação. O SciPy adiciona algoritmos especializados por domínio,
organizados em subpacotes — scipy.optimize, o assunto deste artigo, é um
deles. O SciPy nunca reimplementa o que o NumPy já resolve bem, então é
normal os dois aparecerem lado a lado no mesmo trecho de código.
Há também um ponto de sobreposição real: numpy.linalg.solve (usado no
Exemplo 2 logo abaixo) e scipy.linalg.solve fazem essencialmente a mesma
coisa, e a versão do SciPy costuma ser a mais recomendada quando os dois
estão instalados (mais opções, sempre via LAPACK). Usamos a do NumPy aqui
só por ser a mais conhecida — para um sistema simples como esse, não faz
diferença prática.
A tabela a seguir resume de onde vem cada ferramenta usada neste artigo, e por quê:
| Ferramenta | Vem de | Papel |
|---|---|---|
numpy.roots |
NumPy | Raízes de um polinômio (via autovalores da matriz companheira) |
numpy.linalg.solve |
NumPy | Sistema linear — scipy.linalg.solve é equivalente |
numpy.isclose / numpy.allclose |
NumPy | Comparação de floats com tolerância |
numpy.sign, numpy.diff, numpy.linspace |
NumPy | Operações básicas de array |
scipy.optimize.bisect / brentq |
SciPy | Busca de raiz por bracket |
scipy.optimize.newton |
SciPy | Método de Newton |
scipy.optimize.fsolve / root |
SciPy | Sistemas de equações não lineares |
Exemplo 1 — a mesma quadrática do artigo sobre equações
Enunciado: No artigo Resolvendo Equações com SymPy,
resolvemos \(x^2 + 2x - 8 = 0\) com sympy.solve, obtendo as raízes
exatas \(-4\) e \(2\). Como fica o mesmo problema resolvido
numericamente?
Solução: O equivalente numérico é numpy.roots, que
recebe os coeficientes do maior grau para o menor — a mesma convenção do
all_coeffs() do SymPy:
import numpy as np

print(np.roots([1, 2, -8]))
[-4. 2.]Mesmo resultado, agora como float64 em vez de inteiros exatos do SymPy.
Para uma quadrática simples como essa, a diferença é cosmética. Mais
adiante ela deixa de ser.
Exemplo 2 — o mesmo sistema linear
Enunciado: O mesmo artigo resolveu o sistema \(x + y = 3\),
\(3x - 2y = 0\) com sympy.solve, obtendo \(x = 6/5\), \(y = 9/5\) —
exato. E numericamente?
Solução: Na forma matricial \(A\mathbf{x} = \mathbf{b}\), o
equivalente numérico é numpy.linalg.solve:
import numpy as np

A = np.array([[1.0, 1.0], [3.0, -2.0]])
b = np.array([3.0, 0.0])

sol_linear = np.linalg.solve(A, b)
print(sol_linear)
[1.2 1.8]De novo, o mesmo resultado — \(1{,}2 = 6/5\) e \(1{,}8 = 9/5\) — só que como aproximação em ponto flutuante.
No artigo original, comparar a solução com == depois de substituir 6/5
como float dava False numa das equações — só funcionava com Rational
(veja por quê). Aqui a
situação se inverte: estamos deliberadamente trabalhando em ponto
flutuante, então a checagem “essa solução está correta?” nunca deve usar
== contra zero.
import numpy as np

A = np.array([[1.0, 1.0], [3.0, -2.0]])
b = np.array([3.0, 0.0])
sol_linear = np.linalg.solve(A, b)

residual = A @ sol_linear - b
print("resíduo A@x - b:", residual)
print("é zero, com tolerância?", np.allclose(residual, 0))
print("é zero, exatamente? (não faça isso)", np.all(residual == 0))
resíduo A@x - b: [4.4408921e-16 0.0000000e+00]
é zero, com tolerância? True
é zero, exatamente? (não faça isso) FalseO resíduo é praticamente zero (\(4{,}4 \times 10^{-16}\), a ordem de
grandeza do erro de arredondamento de ponto flutuante de precisão dupla),
mas comparar exatamente contra zero falha porque uma das entradas tem um
resquício de arredondamento. A partir daqui, toda checagem de “isso é
solução?” neste artigo (e nos dois seguintes) usa
numpy.isclose
— compara dois números e diz se a diferença entre eles é menor que uma
tolerância — ou sua versão para arrays inteiros,
numpy.allclose.
A Ideia da Bisseção: bisect e brentq
#
Voltemos ao problema real: equações sem forma fechada, como \(e^x = x^{100}\) — sim, essa equação já apareceu por aqui, no artigo sobre limites, quando comparamos o crescimento de uma exponencial contra o de uma potência. Lá, o SymPy encontrou uma das raízes, \(647{,}2775124394\), mas por baixo dos panos ele próprio recorre a métodos numéricos para isso — a resposta “exata” que o SymPy imprime já é uma aproximação disfarçada.
A ideia mais simples e mais robusta para achar raízes numericamente vem diretamente do Teorema do Valor Intermediário, provavelmente já visto em qualquer curso de cálculo:
Se \(f\) é contínua em \([a, b]\) e \(f(a)\) e \(f(b)\) têm sinais opostos, então existe pelo menos um \(c \in (a, b)\) tal que \(f(c) = 0\).
Um intervalo \([a, b]\) onde \(f\) troca de sinal é chamado de bracket — termo em inglês (sem tradução consagrada em português) que a literatura de métodos numéricos usa para designar exatamente esse intervalo que “contém” a raiz. É a garantia mínima de que existe uma raiz ali dentro — e é exatamente essa garantia que a bisseção explora: divida o intervalo ao meio, veja de que lado o sinal muda, descarte a outra metade, repita.
O SciPy implementa essa ideia ao pé da letra em scipy.optimize.bisect —
sem nenhuma esperteza extra, só a divisão do intervalo repetida até a
tolerância desejada. Vamos aplicá-la ao mesmo \(f(x) = x^2 - 2\) que
reaparece adiante neste artigo, buscando \(\sqrt{2}\) no bracket
\([1, 2]\) (\(f(1) = -1\), \(f(2) = 2\) — sinais opostos, bracket
válido):
from scipy import optimize


def f(x):
    return x**2 - 2


print(optimize.bisect(f, 1.0, 2.0))1.4142135623715149Correto até a 11ª casa decimal, comparado ao valor exato
\(\sqrt{2} \approx 1{,}4142135623730951\) — o erro é de
\(1{,}6 \times 10^{-12}\), exatamente a ordem da tolerância padrão do
bisect. Funciona, é garantido — mas é lento: cada iteração só reduz o
intervalo pela metade (a seção sobre ordens de convergência, mais adiante
neste artigo, mostra exatamente quão mais devagar).
Vale abrir a caixa-preta e ver as quatro primeiras iterações à mão. A regra é sempre a mesma: calcule o ponto médio \(m\), veja se \(f(m)\) tem o mesmo sinal de \(f(a)\), e descarte a metade onde a raiz não pode estar:
| Iteração | Intervalo \([a, b]\) | \(m = \frac{a+b}{2}\) | \(f(m)\) | Metade descartada | Nova largura |
|---|---|---|---|---|---|
| 1 | [1,0000; 2,0000] | \(1{,}5000\) | \(+0{,}2500\) | [1,5000; 2,0000] | \(0{,}5000\) |
| 2 | [1,0000; 1,5000] | \(1{,}2500\) | \(-0{,}4375\) | [1,0000; 1,2500] | \(0{,}2500\) |
| 3 | [1,2500; 1,5000] | \(1{,}3750\) | \(-0{,}1094\) | [1,2500; 1,3750] | \(0{,}1250\) |
| 4 | [1,3750; 1,5000] | \(1{,}4375\) | \(+0{,}0664\) | [1,4375; 1,5000] | \(0{,}0625\) |
Como \(f(1) = -1\) é negativo, sempre que \(f(m)\) também é negativo a raiz está do lado direito de \(m\), e a metade esquerda vai fora — e vice-versa. Depois de 4 iterações sabemos que \(\sqrt{2}\) está em \([1{,}3750\) e \(1{,}4375]\), e de fato está. Repare na última coluna: a largura cai por um fator exato de 2 a cada passo, sempre, independentemente da função. É essa garantia — e só ela — que a bisseção oferece.
Para a maioria dos casos, o SciPy oferece uma versão turbinada da mesma
ideia: a função scipy.optimize.brentq, que usa o método de Brent — uma
combinação de bisseção com interpolação, que preserva a garantia de
convergência da bisseção mas costuma ser bem mais rápida na prática.
Vamos aplicá-la à mesma equação do artigo de limite. Só que há um detalhe: a função \(f(x) = e^x - x^{100}\) varia de \(10^0\) a \(10^{304}\) nessa faixa de \(x\) — um gráfico comum do valor de \(f(x)\) fica visualmente inútil (uma linha achatada em zero até quase o fim). O que realmente importa para escolher um bracket é o sinal de \(f(x)\), não sua magnitude — então é isso que plotamos. O código a seguir gera a figura logo abaixo:
import matplotlib.pyplot as plt
import numpy as np
from scipy import optimize


def f(x):
    return np.exp(x) - x**100


root = optimize.brentq(f, 600, 700)

x_vals = np.linspace(600, 700, 2000)
sign_vals = np.sign(f(x_vals))

fig, ax = plt.subplots(figsize=(8, 5))
ax.step(x_vals, sign_vals, color="C0", where="post")
ax.axhline(0, color="gray", linewidth=1, zorder=0)
ax.axvline(root, color="C1", linestyle="--", label=f"raiz ≈ {root:.2f}")
ax.set_yticks([-1, 0, 1])
ax.set_xlabel("x")
ax.set_ylabel(r"sinal de $e^x - x^{100}$")
ax.set_title("Escolhendo o bracket para brentq: onde o sinal troca")
ax.legend()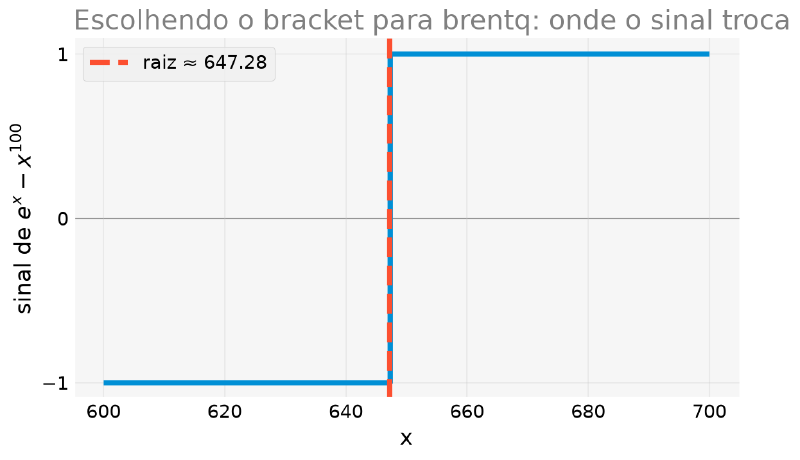
Mas como chegar a um gráfico desses sem já saber onde procurar? Na prática, ninguém “advinha” um bracket — ele vem de conhecimento do problema (limites físicos razoáveis, por exemplo) ou de uma varredura computacional simples: avalia-se a função num conjunto de pontos igualmente espaçados e procura-se onde o sinal muda de um ponto para o seguinte.
import numpy as np


def f(x):
    return np.exp(x) - x**100


x_varredura = np.linspace(600, 700, 1000)
sinais = np.sign(f(x_varredura))
mudancas = np.where(np.diff(sinais) != 0)[0]
print("sinal muda entre x =", x_varredura[mudancas], "e x =", x_varredura[mudancas + 1])
sinal muda entre x = [647.24724725] e x = [647.34734735]numpy.diff calcula a diferença entre elementos consecutivos do array de
sinais — onde essa diferença é diferente de zero, o sinal mudou de um ponto
para o próximo, e ali está o bracket que buscamos: (647.247..., 647.347...),
exatamente ao redor da raiz \(647{,}28\) já conhecida. É essa mesma lógica
— varrer, comparar sinais consecutivos, refinar o intervalo — que algoritmos
de busca de raiz mais sofisticados automatizam por baixo dos panos.
import numpy as np
from scipy import optimize


def f(x):
    return np.exp(x) - x**100


root = optimize.brentq(f, 600, 700)
print("raiz encontrada:", root)
raiz encontrada: 647.2775124394004O mesmo valor do artigo de limite, agora obtido com controle explícito do
método usado. E o brentq não é mágico — ele exige o bracket. Um intervalo
sem troca de sinal falha explicitamente, em vez de devolver algo errado
silenciosamente:
import numpy as np
from scipy import optimize


def f(x):
    return np.exp(x) - x**100


optimize.brentq(f, 2, 5)
ValueError: f(a) and f(b) must have different signs(0, 10) não seria um bom contraexemplo aqui — há uma raiz bem menor
nessa faixa, \(x \approx 1{,}01\) (também citada no artigo de limite),
então o sinal troca ali e brentq funcionaria normalmente. O erro acima só
aparece porque escolhi um intervalo, (2, 5), onde \(f\) fica negativa o
tempo todo — entre as duas raízes vizinhas. Sempre plote a função (ou,
como aqui, seu sinal) antes de escolher um bracket.
O Método de Newton #
A bisseção (e o brentq, por extensão) é robusta mas “cega”: ela só usa o
sinal da função, ignorando toda a informação sobre o quão rápido ela está
mudando. O método de Newton (ou Newton-Raphson) usa a derivada para dar
passos muito mais espertos — e, em troca, perde a garantia incondicional de
convergência.
Dada uma estimativa \(x_n\) para a raiz de \(f\), trace a reta tangente ao gráfico de \(f\) em \(x_n\) e use o ponto onde essa tangente cruza o eixo \(x\) como a próxima estimativa:
$$x_{n+1} = x_n - \frac{f(x_n)}{f'(x_n)}$$Repita até o valor convergir dentro de uma tolerância desejada.
Essa fórmula não precisa ser decorada — ela sai em duas linhas. A reta tangente ao gráfico de \(f\) no ponto \(x_n\) é
$$ y = f(x_n) + f'(x_n)(x - x_n) $$Queremos onde essa reta cruza o eixo \(x\), ou seja, onde \(y = 0\):
$$ 0 = f(x_n) + f'(x_n)(x - x_n) \quad\Longrightarrow\quad x = x_n - \frac{f(x_n)}{f'(x_n)} $$E esse \(x\) é justamente o próximo palpite, \(x_{n+1}\). Toda a fórmula é isto: trocar a função pela sua tangente e resolver o problema fácil no lugar do difícil. Fica claro, de passagem, de onde vem a fragilidade do método — se \(f’(x_n)\) for zero, a tangente é horizontal e nunca cruza o eixo; se for quase zero, ela cruza muito longe. É exatamente o que vamos ver falhar daqui a pouco.
Antes de tratar scipy.optimize.newton como caixa-preta, vale reconstruir
manualmente o que ele faz — no exemplo mais clássico possível: achar
\(\sqrt{2}\) resolvendo \(f(x) = x^2 - 2 = 0\).
import numpy as np


def f(x):
    return x**2 - 2


def fp(x):
    return 2 * x


def newton_manual(f, fp, x0, n_iter):
    xs = [x0]
    for _ in range(n_iter):
        x_atual = xs[-1]
        xs.append(x_atual - f(x_atual) / fp(x_atual))
    return xs


xs = newton_manual(f, fp, x0=1.0, n_iter=4)
for i, x_i in enumerate(xs):
    print(f"x_{i} = {x_i:.10f}   (erro: {abs(x_i - np.sqrt(2)):.2e})")
x_0 = 1.0000000000 (erro: 4.14e-01)
x_1 = 1.5000000000 (erro: 8.58e-02)
x_2 = 1.4166666667 (erro: 2.45e-03)
x_3 = 1.4142156863 (erro: 2.12e-06)
x_4 = 1.4142135624 (erro: 1.59e-12)Repare na velocidade: o número de dígitos corretos praticamente dobra a cada passo — de 1 para 2, para 5, para 12. Essa é a chamada convergência quadrática do método de Newton, e é o motivo de ele ser tão popular quando a derivada está disponível. A figura abaixo mostra visualmente os 3 primeiros passos — as retas tangentes convergindo rapidamente para \(\sqrt{2}\) (a partir do quarto passo a tangente já fica colada demais na raiz para ser distinguível no desenho).
import matplotlib.pyplot as plt
import numpy as np


def f(x):
    return x**2 - 2


def fp(x):
    return 2 * x


def newton_manual(f, fp, x0, n_iter):
    xs = [x0]
    for _ in range(n_iter):
        x_atual = xs[-1]
        xs.append(x_atual - f(x_atual) / fp(x_atual))
    return xs


xs_plot = newton_manual(f, fp, x0=1.0, n_iter=2)   # x_0, x_1, x_2

x_plot = np.linspace(0.8, 2.1, 400)
fig, ax = plt.subplots(figsize=(8, 6))
ax.plot(x_plot, f(x_plot), color="C0", label=r"$f(x) = x^2 - 2$", zorder=2)
ax.axhline(0, color="gray", linewidth=1, zorder=0)

for i in range(len(xs_plot) - 1):
    x_atual = xs_plot[i]
    x_novo = xs_plot[i + 1]
    # reta tangente em x_atual, desenhada até cruzar y=0 (que é x_novo)
    tangente_x = np.array([x_atual, x_novo])
    tangente_y = np.array([f(x_atual), 0.0])
    ax.plot(tangente_x, tangente_y, color="C1", linestyle="--", linewidth=1.5, zorder=1)
    ax.scatter([x_atual], [f(x_atual)], color="C1", zorder=3)
    ax.annotate(f"$x_{i}$", (x_atual, f(x_atual)), textcoords="offset points",
                xytext=(6, 8))

ax.axvline(np.sqrt(2), color="C2", linestyle=":", label=r"$\sqrt{2}$ (raiz exata)")
ax.legend()
ax.set_xlabel("x")
ax.set_ylabel("f(x)")
ax.set_title(r"Newton passo a passo: tangentes sucessivas convergindo a $\sqrt{2}$")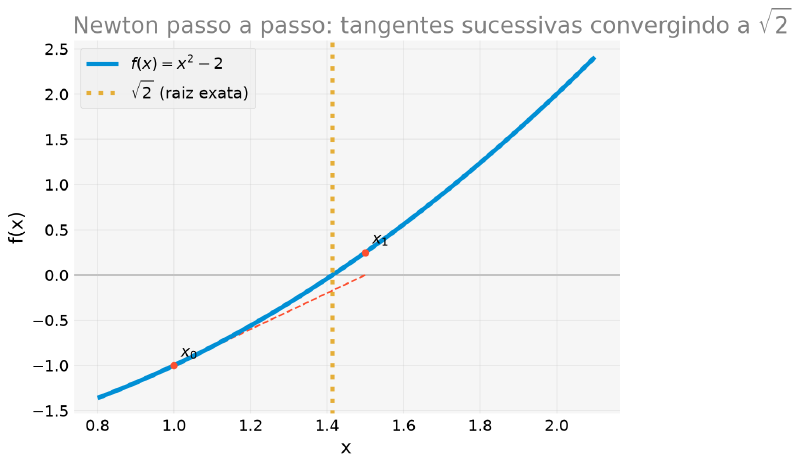
A versão oficial do SciPy faz exatamente isso, só que mais rápido e com critérios de parada mais robustos:
from scipy import optimize


def f(x):
    return x**2 - 2


def fp(x):
    return 2 * x


print(optimize.newton(f, x0=1.0, fprime=fp))1.4142135623730951Quando Newton Falha #
A rapidez de Newton tem um preço: sem a garantia de bracket, ele pode divergir — e não é preciso um exemplo artificial para ver isso. O caso a seguir é clássico de qualquer livro de cálculo numérico: \(f(x) = x^3 - 2x + 2\), partindo de \(x_0 = 0\).
from scipy import optimize


def f(x):
    return x**3 - 2*x + 2


def fp(x):
    return 3*x**2 - 2


optimize.newton(f, x0=0.0, fprime=fp)
RuntimeError: Failed to converge after 50 iterations, value is 0.0.Para enxergar exatamente o que acontece, vale fazer as contas dos dois primeiros passos à mão, usando a mesma fórmula \(x_{n+1} = x_n - f(x_n)/f’(x_n)\) que acabamos de deduzir:
- Em \(x_0 = 0\): \(f(0) = 2\) e \(f’(0) = -2\), então \(x_1 = 0 - \dfrac{2}{-2} = 1\).
- Em \(x_1 = 1\): \(f(1) = 1\) e \(f’(1) = 1\), então \(x_2 = 1 - \dfrac{1}{1} = 0\) — de volta, exatamente, a \(x_0\).
Não é uma aproximação que “quase” volta ao início: é um ciclo perfeito de período 2. A partir daqui, o método salta para sempre entre \(0\) e \(1\), sem nunca se aproximar da raiz real (que existe, e é única, em torno de \(x \approx -1{,}77\)). A figura a seguir desenha esse vaivém: as duas retas tangentes tracejadas, que se cruzam em vez de convergir, e as linhas pontilhadas que fecham o ciclo — desce pela tangente até o eixo, sobe de volta até a curva, repete.
import matplotlib.pyplot as plt
import numpy as np


def f(x):
    return x**3 - 2*x + 2


raiz_real = -1.7692923542386314

x_vals = np.linspace(-2.5, 2.5, 500)
fig, ax = plt.subplots(figsize=(8, 5.5))
ax.plot(x_vals, f(x_vals), color="C0", label=r"$f(x) = x^3 - 2x + 2$", zorder=2)
ax.axhline(0, color="gray", linewidth=1, zorder=0)

# tangente em x=0 leva a x=1; tangente em x=1 leva de volta a x=0
for x_atual, x_novo in [(0.0, 1.0), (1.0, 0.0)]:
    ax.plot([x_atual, x_novo], [f(x_atual), 0.0],
            color="C1", linestyle="--", linewidth=1.6, zorder=3)
    ax.plot([x_novo, x_novo], [0.0, f(x_novo)],
            color="C1", linestyle=":", linewidth=1.2, alpha=0.7, zorder=1)

ax.scatter([0.0, 1.0], [f(0.0), f(1.0)], color="C1", s=60, zorder=4,
           label="tangentes do ciclo")
ax.scatter([raiz_real], [0.0], color="C2", s=90, marker="*", zorder=4,
           label=f"raiz real (≈ {raiz_real:.2f})")
ax.set_ylim(-2.5, 5.5)
ax.legend(loc="upper left")
ax.set_xlabel("x")
ax.set_ylabel("f(x)")
ax.set_title("Newton em ciclo: as duas tangentes que se alternam para sempre")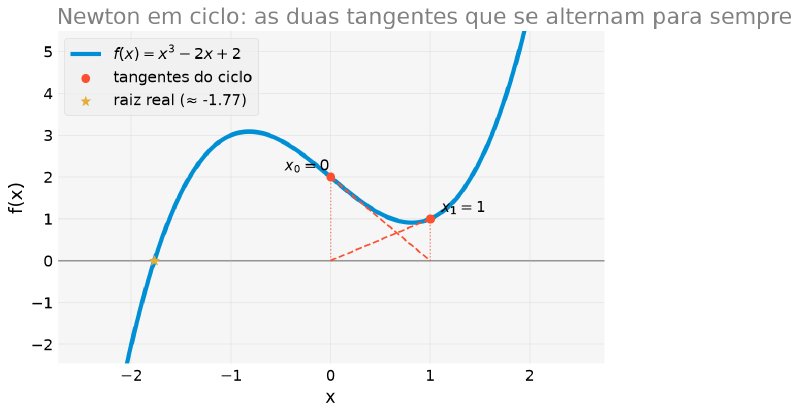
Com um chute inicial melhor, o mesmo método converge sem obstáculos:
from scipy import optimize


def f(x):
    return x**3 - 2*x + 2


def fp(x):
    return 3*x**2 - 2


print(optimize.newton(f, x0=-2.0, fprime=fp))-1.7692923542386314\(x_0 = 0\) Não é um Azar Isolado #
Seria confortável concluir que \(x_0 = 0\) foi só um chute infeliz, um ponto singular que dá para evitar com um pouco de cuidado. Não é. Dá para varrer milhares de chutes iniciais, rodar Newton a partir de cada um, e classificar: convergiu para a raiz real, ou não convergiu?
import numpy as np


def f(x):
    return x**3 - 2*x + 2


def fp(x):
    return 3*x**2 - 2


raiz_real = -1.7692923542386314


def newton_destino(x0, n_iter=200):
    """Roda Newton a partir de x0 e devolve o ponto final (ou nan se escapou)."""
    x = float(x0)
    for _ in range(n_iter):
        derivada = fp(x)
        if abs(derivada) < 1e-14:
            return np.nan
        x = x - f(x) / derivada
        if not np.isfinite(x) or abs(x) > 1e8:
            return np.nan
    return x


x0_grid = np.linspace(-3, 3, 6001)
convergiu = np.array([abs(newton_destino(x0) - raiz_real) < 1e-6 for x0 in x0_grid])
print(f"fração dos chutes que converge: {convergiu.mean():.1%}")
fração dos chutes que converge: 80.2%Quase um em cada cinco chutes iniciais nessa faixa falha. E a distribuição deles não é nada intuitiva — é o que a figura a seguir mostra, pintando de verde os \(x_0\) que convergem e de vermelho os que não:
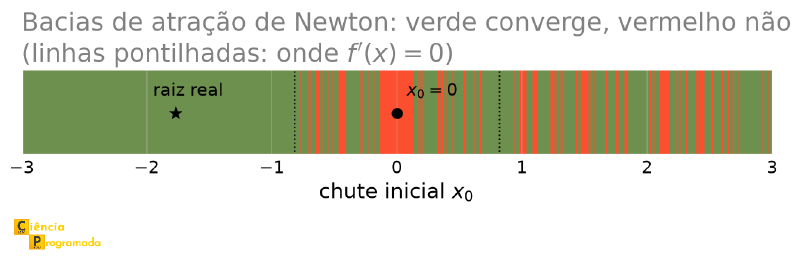
Longe do centro, tudo é verde: Newton se comporta. Mas entre as duas linhas pontilhadas — que marcam onde \(f’(x) = 3x^2 - 2 = 0\), ou seja, \(x = \pm\sqrt{2/3} \approx \pm 0{,}816\) — a coisa se despedaça. Há uma faixa vermelha larga em torno de \(x_0 = 0\) (o nosso ciclo, que arrasta consigo toda uma vizinhança) e, ao redor dela, listras verdes e vermelhas que se alternam cada vez mais finas conforme se aproximam dos pontos onde a derivada zera. Nesse intervalo, essa alternância nunca “termina”: por mais que se dê zoom, continuam aparecendo listras — a fronteira entre convergir e não convergir é fractal.
É por isso que “escolha um chute inicial melhor” é um conselho mais difícil de seguir do que parece: em boa parte do domínio, chutes vizinhos podem ter destinos completamente diferentes.
Newton não “não presta” — ele é sensível ao chute inicial de um jeito que
brentq simplesmente não é (contanto que o bracket seja válido). Trate
newton como a ferramenta rápida para quando você já tem uma boa ideia de
onde a raiz está; trate brentq como a ferramenta padrão, mais tolerante à
ignorância inicial.
Comparando Ordens de Convergência #
As palavras “convergência quadrática” (Newton) e a garantia de robustez da
bisseção fazem mais sentido lado a lado, com números. Vamos resolver o mesmo
\(f(x) = x^2 - 2\) pelos dois métodos e acompanhar o erro a cada iteração,
em escala logarítmica. Para isso, reimplementamos a bisseção manualmente em
vez de chamar scipy.optimize.bisect diretamente — é a única forma de
guardar o valor a cada iteração para o gráfico, já que a função pronta só
devolve o resultado final.
O erro pontual do ponto médio, \(|x_n - \sqrt{2}|\), não decresce de forma monótona — o ponto médio pode “pular” para o outro lado da raiz a cada passo. Isso é normal, mas gera um gráfico serrilhado e confuso. O que a bisseção garante mesmo, sempre, é reduzir a largura do intervalo pela metade a cada iteração — e essa largura é um limite superior confiável para o erro. É essa quantidade que aparece no gráfico abaixo, no lugar do erro pontual bruto.
import matplotlib.pyplot as plt
import numpy as np


def f(x):
    return x**2 - 2


def fp(x):
    return 2 * x


def newton_manual(f, fp, x0, n_iter):
    xs = [x0]
    for _ in range(n_iter):
        x_atual = xs[-1]
        xs.append(x_atual - f(x_atual) / fp(x_atual))
    return xs


def bissecao_com_historico(f, a, b, n_iter):
    xs, larguras = [], []
    for _ in range(n_iter):
        m = (a + b) / 2
        xs.append(m)
        larguras.append(b - a)
        if np.sign(f(a)) == np.sign(f(m)):
            a = m
        else:
            b = m
    return xs, larguras


raiz_exata = np.sqrt(2)
n_iter = 12

xs_bissecao, larguras_bissecao = bissecao_com_historico(f, a=1.0, b=2.0, n_iter=n_iter)

xs_newton_conv = newton_manual(f, fp, x0=1.0, n_iter=n_iter)[1:]
erro_newton = [abs(x - raiz_exata) for x in xs_newton_conv]

fig, ax = plt.subplots(figsize=(8, 5))
ax.semilogy(range(1, len(larguras_bissecao) + 1), larguras_bissecao, "o-", color="C0",
            label="bisseção (largura do intervalo, linear)")
ax.semilogy(range(1, len(erro_newton) + 1), erro_newton, "o-", color="C1",
            label="Newton (erro, quadrática)")
ax.axhline(1e-15, color="gray", linestyle=":", linewidth=1, label="precisão de máquina")
ax.set_xlabel("iteração")
ax.set_ylabel("erro (ou limite superior do erro)")
ax.set_title("Ordem de convergência: bisseção x Newton")
ax.legend()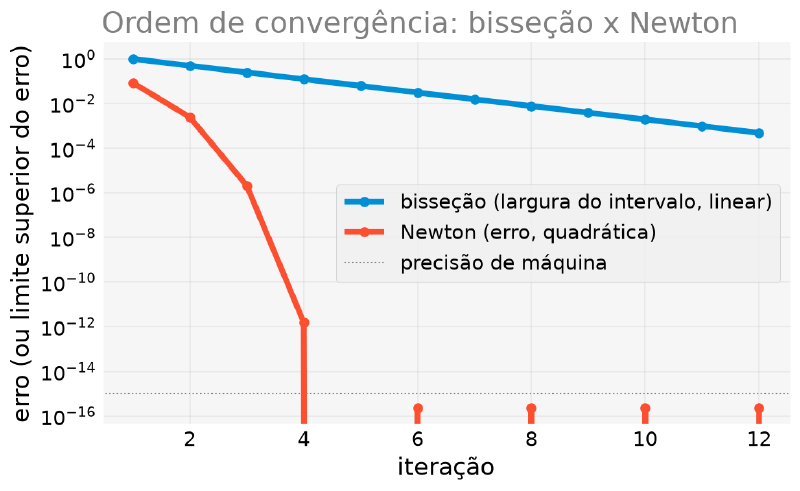
A diferença visual é gritante: a bisseção é uma reta bem-comportada em escala
log (perde uma quantidade constante de erro a cada passo — convergência
linear); Newton despenca quase verticalmente depois de poucas iterações
(convergência quadrática). E o brentq, que combina os dois mundos,
resolve o mesmo problema em pouquíssimas iterações:
from scipy import optimize


def f(x):
    return x**2 - 2


_, info = optimize.brentq(f, 1.0, 2.0, full_output=True)
print("brentq convergiu em", info.iterations, "iterações,",
      info.function_calls, "avaliações da função")
brentq convergiu em 7 iterações, 8 avaliações da funçãoRápido como Newton, sem exigir derivada e sem risco de divergência — o melhor dos dois mundos, na maioria dos casos práticos.
Sistemas de Equações Não Lineares: fsolve e root
#
Tudo até aqui resolveu uma equação em uma variável. E quando há mais de uma
incógnita e as equações não são lineares — situação em que
sympy.solve não tem
garantia de encontrar (ou nem sempre consegue) uma forma fechada? O SciPy
resolve com scipy.optimize.fsolve.
Considere a interseção entre um círculo, \(x^2+y^2=4\), e uma parábola, \(y=x^2\) — duas soluções, por simetria em \(x\).
from scipy import optimize


def sistema(vars_):
    x, y = vars_
    return [x**2 + y**2 - 4, y - x**2]


sol_a = optimize.fsolve(sistema, [1, 1])
sol_b = optimize.fsolve(sistema, [-1, 1])
print("a partir de (1, 1):", sol_a)
print("a partir de (-1, 1):", sol_b)
a partir de (1, 1): [1.24962107 1.56155281]
a partir de (-1, 1): [-1.24962107 1.56155281]O gráfico a seguir mostra as duas curvas e as duas soluções encontradas.
import matplotlib.pyplot as plt
import numpy as np
from scipy import optimize


def sistema(vars_):
    x, y = vars_
    return [x**2 + y**2 - 4, y - x**2]


sol_a = optimize.fsolve(sistema, [1, 1])
sol_b = optimize.fsolve(sistema, [-1, 1])

theta = np.linspace(0, 2 * np.pi, 300)
x_circ, y_circ = 2 * np.cos(theta), 2 * np.sin(theta)
x_par = np.linspace(-2, 2, 300)
y_par = x_par**2

fig, ax = plt.subplots(figsize=(7, 7))
ax.plot(x_circ, y_circ, color="C0", label=r"$x^2+y^2=4$")
ax.plot(x_par, y_par, color="C1", label=r"$y=x^2$")
ax.scatter(*sol_a, color="C2", zorder=3)
ax.scatter(*sol_b, color="C2", zorder=3, label="soluções (fsolve)")
ax.set_aspect("equal")
ax.legend()
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_title("Sistema não linear: círculo × parábola")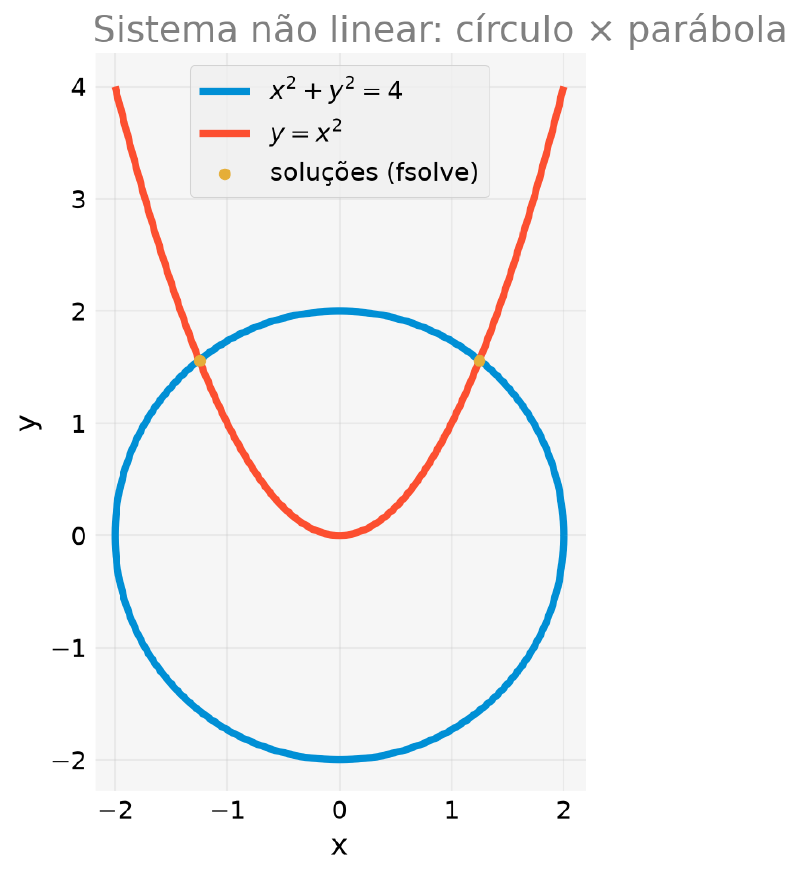
Repare que foi preciso variar o chute inicial para achar cada solução —
diferente do sympy.solve, que devolveria as duas de uma vez quando consegue
resolver simbolicamente. fsolve encontra uma solução por chamada, a mais
próxima do chute fornecido.
E se o Chute Inicial for Ruim? #
Assim como brentq exige um bracket válido e Newton pode divergir com chute
ruim, fsolve também não tem garantia de convergência — e, ao contrário do
brentq, ele não avisa isso com um erro por padrão. Para investigar,
usamos full_output=True, que faz fsolve devolver, além da solução, um
código de status chamado ier: um simples número inteiro que funciona como
sinalizador — 1 significa sucesso; qualquer outro valor indica que algo
deu errado (o motivo específico vem descrito à parte, na mensagem msg).
Esse padrão de retornar um inteiro como “veredito” vem das rotinas
numéricas em Fortran (no caso, do pacote MINPACK) que o fsolve usa por
baixo dos panos.
import numpy as np
from scipy import optimize


def sistema(vars_):
    x, y = vars_
    return [x**2 + y**2 - 4, y - x**2]


solucao, info, ier, msg = optimize.fsolve(sistema, [0, 0], full_output=True)
print("solução retornada:", solucao)
print("convergiu (ier == 1)?", ier == 1)
print("mensagem do solver:", msg)
print("resíduo no ponto retornado:", np.array(sistema(solucao)))
solução retornada: [0. 0.]
convergiu (ier == 1)? False
mensagem do solver: The iteration is not making good progress, as measured by the
improvement from the last ten iterations.
resíduo no ponto retornado: [-4. 0.]fsolve nem saiu do lugar: devolveu o próprio chute como “solução”, com
resíduo \([-4, 0]\) — claramente errado. E o motivo é exatamente o mesmo
que faz o método de Newton travar quando a derivada é zero, só que
generalizado para sistemas: no lugar da derivada \(f’(x)\), entra a matriz
de derivadas parciais de todas as equações em relação a todas as incógnitas —
a jacobiana. Para o nosso sistema,
Avaliando no chute \((0,0)\):
$$ J(0, 0) = \begin{pmatrix} 0 & 0 \\ 0 & 1 \end{pmatrix} $$A primeira linha inteira zera. Isso significa que, nas vizinhanças de
\((0,0)\), a equação do círculo não “responde” a nenhuma mudança em
\(x\) nem em \(y\) — em primeira ordem, ela é insensível às duas
incógnitas ao mesmo tempo. O determinante é zero, a jacobiana é singular,
e o passo de Newton generalizado (que precisa resolver um sistema linear com
essa matriz) não tem para onde ir. Daí o fsolve devolver o próprio chute.
ier e o resíduo
Por padrão, fsolve devolve só o array de solução — sem full_output=True,
o erro acima passaria silenciosamente. Em qualquer uso sério, vale a
pena checar ier ou, no mínimo, substituir a “solução” de volta no sistema
e confirmar que o resíduo é próximo de zero.
fsolve é uma Casca: Conheça o root
#
fsolve existe há décadas no SciPy e, por baixo dos panos, é hoje uma casca
fina sobre uma interface mais nova e mais uniforme:
scipy.optimize.root. A vantagem de root é devolver sempre um objeto
OptimizeResult, com .x (a solução) e .success (booleano) direto — sem
precisar lembrar de passar full_output=True para saber se convergiu.
from scipy import optimize


def sistema(vars_):
    x, y = vars_
    return [x**2 + y**2 - 4, y - x**2]


resultado = optimize.root(sistema, [1, 1])
print("solução:", resultado.x)
print("convergiu?", resultado.success)
solução: [1.24962107 1.56155281]
convergiu? TrueE, claro, root sofre exatamente do mesmo problema com o chute
\((0, 0)\) — internamente, o método padrão de root ('hybr') é o mesmo
algoritmo que fsolve usa:
from scipy import optimize


def sistema(vars_):
    x, y = vars_
    return [x**2 + y**2 - 4, y - x**2]


resultado_ruim = optimize.root(sistema, [0, 0])
print("solução:", resultado_ruim.x)
print("convergiu?", resultado_ruim.success)
print("mensagem:", resultado_ruim.message)
solução: [0. 0.]
convergiu? False
mensagem: The iteration is not making good progress, as measured by the
improvement from the last ten iterations.Mesmo resultado de antes, mas com uma checagem de sucesso direta, sem
full_output. root também aceita outros algoritmos via method
('broyden1', 'krylov', entre outros) para sistemas maiores ou mais
difíceis — para os sistemas deste artigo, o padrão já resolve bem. Fica a
recomendação: em código novo, prefira root a fsolve só pela clareza da
interface.
Tabela-Resumo dos Métodos #
A tabela a seguir resume quando usar cada método visto neste artigo.
| Método | Precisa de bracket? | Precisa de derivada? | Convergência garantida? | Ordem de convergência | Quando usar |
|---|---|---|---|---|---|
bisect |
Sim (troca de sinal) | Não | Sim, se o bracket é válido | Linear | Robustez acima de tudo; velocidade não importa |
brentq |
Sim (troca de sinal) | Não | Sim, se o bracket é válido | Superlinear, rápido na prática | Escolha padrão para uma variável |
newton (com fprime) |
Não | Sim | Não — depende do chute inicial | Quadrática | Derivada disponível e chute inicial bom |
newton (sem fprime) |
Não | Não (secante) | Não — depende do chute inicial | Superlinear | Sem derivada, mas com chute razoável |
fsolve / root |
Não | Opcional (jacobiana) | Não — depende do chute inicial | Varia com o método interno | Sistemas com mais de uma equação/variável |
Regra prática: para uma variável só, comece por brentq — não exige
derivada e é confiável. Use newton quando já tiver a derivada e precisar de
mais velocidade. Para sistemas, fsolve/root — mas sempre valide o
resíduo, porque não há garantia de convergência.
Próximos Passos #
Todos os métodos deste artigo foram testados em problemas didáticos: equações escolhidas para ilustrar um comportamento específico (um bracket, uma divergência, uma convergência lenta), não para resolver um problema real de ponta a ponta. Falta a etapa que dá sentido prático a tudo isso: aplicar essas mesmas ferramentas a equações que vêm de um problema físico, químico ou de engenharia de verdade — com as unidades, as interpretações e as armadilhas que só aparecem fora do laboratório didático.
Ficou pendente, inclusive, a pergunta que abriu este artigo: qual é, afinal,
a posição de um planeta numa órbita elíptica dada sua anomalia média e a
excentricidade? Agora temos as ferramentas para responder — newton, com a
derivada exata da
equação de Kepler, converge rapidamente para a anomalia excêntrica
\(E\). No próximo artigo,
resolvemos essa equação de verdade, visualizamos a órbita resultante e
aplicamos os mesmos métodos ao alcance de um projétil sob resistência do ar —
outro clássico da física sem solução em forma fechada.
Depois, em Da Química à Engenharia, veremos três equações reais de química e engenharia — o volume molar de um gás real, o pH de um ácido fraco e o fator de atrito de Colebrook — todas resolvidas com as mesmas ferramentas apresentadas aqui.