Dimensionar um tanque cilíndrico de custo mínimo, dado um volume fixo, é um exercício clássico: escreve-se o custo em função do diâmetro e da altura, usa-se a restrição de volume para eliminar uma das duas variáveis, deriva-se o que sobrou e iguala-se a zero. Três linhas de álgebra e o problema está resolvido. Mas essa elegância depende de uma condição que passa despercebida: dava para isolar uma variável em função da outra numa expressão fechada. E se não desse, porque a relação entre as variáveis é complicada demais, ou porque há mais de uma restrição, ou porque a função de custo não tem derivada simbólica tratável? A conta que resolve tudo derivando e igualando a zero, à mão, trava.
Por Que Otimização Numérica Importa? #
- Engenharia: dimensionar equipamentos e estruturas quase sempre envolve várias variáveis de projeto e restrições simultâneas (custo, segurança, espaço disponível), raramente cabe numa única substituição algébrica.
- Ciência de dados e aprendizado de máquina: treinar um modelo é, no fundo, minimizar uma função de perda com milhares (ou milhões) de parâmetros, impossível de resolver derivando à mão.
- Economia e pesquisa operacional: alocar recursos limitados de forma ótima é um problema de otimização com restrições quase por definição.
- Ciências naturais: ajustar os parâmetros de um modelo não linear a dados experimentais é minimizar o erro entre modelo e medição, ou seja, otimização disfarçada de ajuste de curva.
Do Critério f’=0 ao scipy.optimize
#
O artigo de otimização do SymPy
resolveu \(f(x) = x^3 - 2x^2 + x\) do jeito simbólico: diff para
achar a derivada, solve para igualar a zero. O resultado é uma lista
com todos os pontos críticos de uma vez, \(x=1/3\) (máximo local)
e \(x=1\) (mínimo local):
import sympy as sp

x = sp.symbols("x")
f_sym = x**3 - 2 * x**2 + x
pontos_criticos = sp.solve(sp.diff(f_sym, x), x)
print(pontos_criticos)
[1/3, 1]scipy.optimize.minimize_scalar ataca o mesmo tipo de problema de outro
jeito: em vez de resolver uma equação simbólica, faz uma busca numérica
por um mínimo dentro de um intervalo. A diferença de filosofia já aparece
aqui, porque minimize_scalar só procura mínimo, então nunca vai devolver o
máximo local em \(1/3\), não importa o intervalo:
import sympy as sp
from scipy.optimize import minimize_scalar

x = sp.symbols("x")
f_sym = x**3 - 2 * x**2 + x
f_num = sp.lambdify(x, f_sym)

res = minimize_scalar(f_num, bounds=(0.5, 1.5), method="bounded")
print(res.x, res.fun, res.success)
1.0000000114867313 0.0 TrueBate com \(x=1\), o mínimo local, dentro da tolerância numérica esperada.
method="bounded"
O minimize_scalar tem três métodos, e a escolha não é indiferente:
| Método | Precisa de intervalo? | Observação |
|---|---|---|
brent (padrão) |
Não, aceita um bracket opcional |
Combina seção áurea com interpolação parabólica; é o análogo do brentq para minimização |
golden |
Não | Busca pela seção áurea pura; mais lenta, valor histórico |
bounded |
Sim, obrigatório | O único que respeita bounds e nunca sai do intervalo |
A distinção importa: bounds só é honrado por bounded. Com brent, o
otimizador pode perfeitamente sair vagando para fora do intervalo que você
imaginou ter imposto, e num problema com significado físico (uma
concentração, uma temperatura absoluta) isso costuma acabar em avaliação
da função em valores sem sentido.
O scipy.optimize não tem nenhuma função maximize. Isso não faz falta:
maximizar \(f\) é a mesma coisa que minimizar \(-f\), já
que virar a função de cabeça para baixo troca picos por vales sem mover
nenhum deles de lugar. É o truque mais usado da biblioteca inteira, e
resolve o máximo em \(1/3\) que o minimize_scalar “não acha”:
import sympy as sp
from scipy.optimize import minimize_scalar

x = sp.symbols("x")
f_sym = x**3 - 2 * x**2 + x
f_num = sp.lambdify(x, f_sym)

res_max = minimize_scalar(lambda t: -f_num(t), bounds=(0, 0.8), method="bounded")
print("x do máximo:", res_max.x)
print("f(x) no máximo:", -res_max.fun)  # desfaz o sinal!
x do máximo: 0.3333331957133562
f(x) no máximo: 0.1481481481481292Bate com \(x = 1/3\) e \(f(1/3) = 4/27 \approx 0{,}1481\).
Duas armadilhas nesse padrão, as duas fáceis de cometer:
res.funvem com o sinal trocado. Ele guarda o valor de \(-f\), que é o que foi minimizado. Esquecer o-na hora de ler o resultado devolve um máximo com sinal invertido, e nada avisa.- O intervalo passa a importar de outro jeito. Aqui usei \((0;\ 0{,}8)\) e não \((0{,}5;\ 1{,}5)\), porque o máximo está em \(1/3\), fora do intervalo do exemplo anterior. Mudar o objetivo costuma exigir mudar o intervalo junto.
Esse mesmo truque reaparece no
próximo artigo
quatro vezes seguidas: lá o objetivo é maximizar lucro e alcance, e todas
as funções aparecem escritas como menos_lucro, menos_conversao,
-alcance. O prefixo “menos” no nome não é estilo: é o truque.
Restringir a busca a \([0, 1]\) pareceria mais natural (contém os dois pontos críticos), mas essa função tem uma coincidência, \(f(0) = f(1) = 0\), e os dois extremos do intervalo empatam no valor mínimo. Isso não invalida o método, mas deixa a checagem menos limpa (o otimizador converge para perto de um dos extremos, sem tanta precisão, porque o mínimo está na borda). Escolher um intervalo em que o mínimo cai estritamente por dentro, como \([0{,}5, 1{,}5]\), evita essa ambiguidade.
O Tanque Cilíndrico, Sem Isolar Nenhuma Variável #
O mesmo artigo de otimização do SymPy citado acima, além do exemplo introdutório, também propôs um problema mais elaborado: dimensionar um tanque cilíndrico de volume fixo (\(V\)) minimizando o custo de construção, dado o custo por unidade de área da lateral (\(c_s\)) e do topo/fundo (\(c_t\)). Vale a pena retomá-lo por completo, com os mesmos símbolos.
Vamos lembrar de onde vem a função de custo. Com um pouco de geometria básica (a área lateral de um cilindro é \(\pi D L\), e a área do topo mais a do fundo é \(2 \times \frac{\pi}{4}D^2 = \frac{\pi}{2}D^2\)), chega-se à função de custo:
$$ f = c_s \pi D L + c_t \frac{\pi}{2} D^2 $$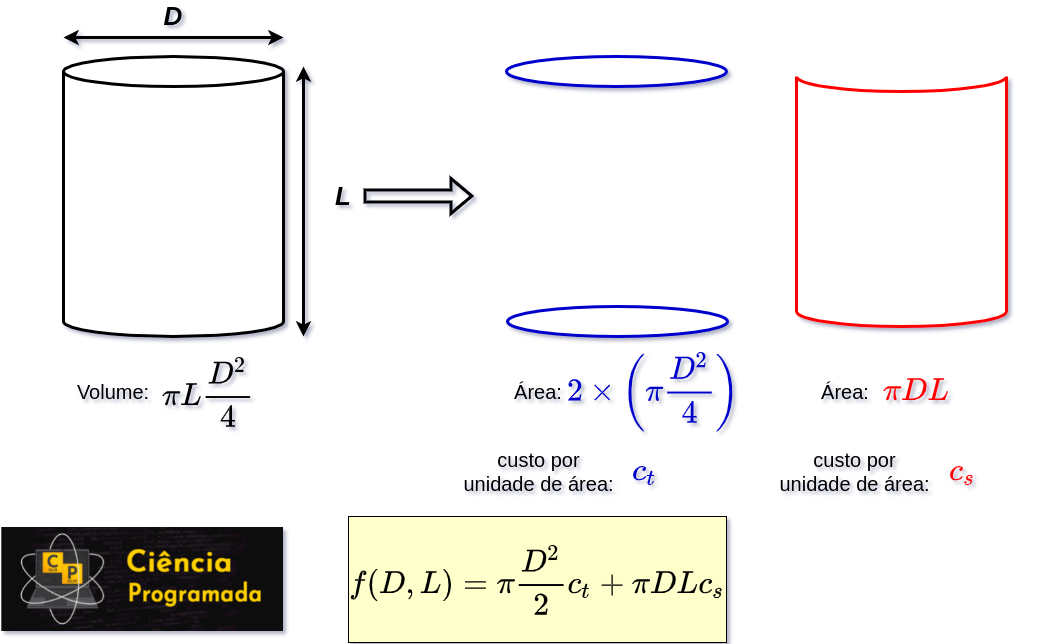
Essa função está sujeita ao volume ser fixo, \(\frac{\pi}{4}D^2 L = V\), a mesma restrição do artigo original.
Exemplo 1: Revalidando o resultado já publicado
Enunciado: Com \(c_s = c_t = 1\) e \(V=10\), encontre o diâmetro que minimiza o custo, isolando \(L\) em função de \(V\) primeiro, do mesmo jeito que o artigo original.
Solução:
import numpy as np
from scipy.optimize import minimize_scalar

V, cs, ct = 10.0, 1.0, 1.0


def custo_1var(D):
    L = 4 * V / (np.pi * D**2)
    return cs * np.pi * D * L + ct * (np.pi / 2) * D**2


res_1var = minimize_scalar(custo_1var, bounds=(0.01, 20), method="bounded")
print("D ótimo:", res_1var.x)
D ótimo: 2.335088713257265O valor simbólico publicado no artigo original foi \(2{,}33508864988147\); bate até a 6ª casa decimal, dentro da tolerância padrão do otimizador.
O gráfico a seguir mostra a curva de custo em função de \(D\), com o mínimo encontrado marcado:
import matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize_scalar

V, cs, ct = 10.0, 1.0, 1.0


def custo_1var(D):
    L = 4 * V / (np.pi * D**2)
    return cs * np.pi * D * L + ct * (np.pi / 2) * D**2


res_1var = minimize_scalar(custo_1var, bounds=(0.01, 20), method="bounded")

Ds = np.linspace(0.5, 6, 200)
fig, ax = plt.subplots()
ax.plot(Ds, custo_1var(Ds))
ax.plot(res_1var.x, res_1var.fun, "o", color="black")
ax.set_xlabel("D (m)")
ax.set_ylabel("custo")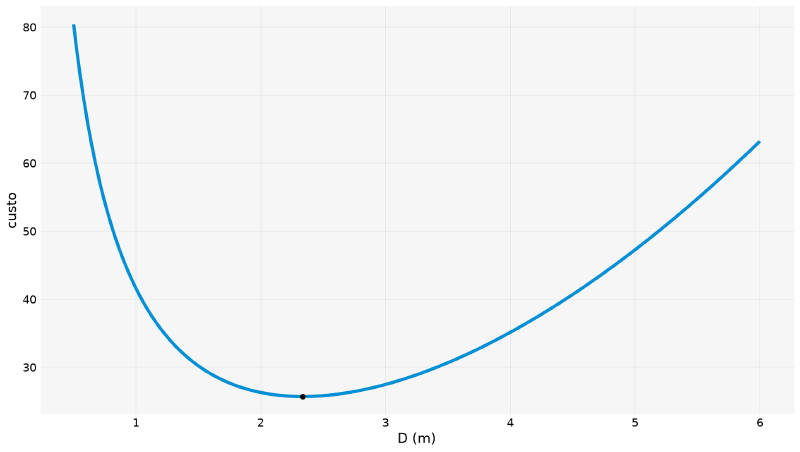
Essa parte só confirma que a via numérica concorda com a via simbólica quando as duas são possíveis. O ponto central do artigo é o próximo passo: resolver o mesmo problema sem isolar \(L\), como se essa eliminação não fosse conveniente (ou não existisse). Isso é uma otimização em duas variáveis, \((D, L)\), sujeita a uma restrição de igualdade:
import numpy as np
from scipy.optimize import minimize

V, cs, ct = 10.0, 1.0, 1.0


def custo_2var(v):
    D, L = v
    return cs * np.pi * D * L + ct * (np.pi / 2) * D**2


def restricao_volume(v):
    D, L = v
    return (np.pi / 4) * D**2 * L - V


res_2var = minimize(
    custo_2var,
    x0=[1.0, 1.0],
    method="SLSQP",
    constraints={"type": "eq", "fun": restricao_volume},
    bounds=[(1e-6, None), (1e-6, None)],
    tol=1e-12,
)
print(res_2var.x, res_2var.success)
[2.33508865 2.33508864] Truemethod="SLSQP" ("sequential least squares programming") é o método
padrão do SciPy para otimização com restrições. A restrição entra como
um dicionário: 'type': 'eq' diz que restricao_volume deve valer
exatamente zero na solução, a mesma equação de volume do artigo
original, só que sem resolver para \(L\) antes de otimizar. D e L
saem praticamente iguais, confirmando a relação \(D=L\) que o artigo
original tinha derivado simbolicamente para custos iguais.
Exemplo 2: Segunda validação: custos distintos
Enunciado: Repita o problema anterior com o custo da lateral igual ao dobro do custo do topo (\(c_s=2\), \(c_t=1\), \(V=10\) continuam).
Solução:
import numpy as np
from scipy.optimize import minimize

V, cs, ct = 10.0, 1.0, 1.0


def restricao_volume(v):
    D, L = v
    return (np.pi / 4) * D**2 * L - V


cs_dist = 2.0
res_dist = minimize(
    lambda v: cs_dist * np.pi * v[0] * v[1] + ct * (np.pi / 2) * v[0] ** 2,
    x0=[2.0, 2.0],
    method="SLSQP",
    constraints={"type": "eq", "fun": restricao_volume},
    bounds=[(1e-6, None), (1e-6, None)],
    tol=1e-14,
)
print(res_dist.x)
[2.94202732 1.47101369]O valor publicado no artigo original foi \(D=2{,}94202734335627\); bate até a 7ª casa decimal.
Bounds: Limites Que a Física Exige #
O exemplo do tanque já usou bounds=[(1e-6, None), (1e-6, None)] sem
explicar por quê. A razão é mais séria do que “evitar valores negativos
feios”: sem esse limite, o problema não tem mínimo finito. Reescrito
em função só de \(D\) (eliminando \(L\)), o custo é
\(4c_sV/D + c_t\frac{\pi}{2}D^2\), para \(D\) negativo, o primeiro
termo despenca sem limite conforme \(D \to 0^-\).
import numpy as np
from scipy.optimize import minimize

V, cs, ct = 10.0, 1.0, 1.0


def custo_2var(v):
    D, L = v
    return cs * np.pi * D * L + ct * (np.pi / 2) * D**2


def restricao_volume(v):
    D, L = v
    return (np.pi / 4) * D**2 * L - V


res_sem_bounds = minimize(
    custo_2var,
    x0=[-0.5, 40.0],
    method="SLSQP",
    constraints={"type": "eq", "fun": restricao_volume},
)
print(res_sem_bounds.x, res_sem_bounds.fun, res_sem_bounds.success, res_sem_bounds.message)
[-8.51038777e-05 1.53038608e+09] -409166.6491516873 False Iteration limit reachedbounds, o otimizador pode “encontrar” um absurdo físico
Partindo de um diâmetro negativo, o otimizador não fica só um pouco
errado: ele persegue um custo cada vez mais negativo, com L
explodindo para mais de um bilhão, e nem chega a convergir
(success=False). Refazendo com os mesmos bounds do exemplo
anterior, a partir do mesmo chute ruim:
import numpy as np
from scipy.optimize import minimize

V, cs, ct = 10.0, 1.0, 1.0


def custo_2var(v):
    D, L = v
    return cs * np.pi * D * L + ct * (np.pi / 2) * D**2


def restricao_volume(v):
    D, L = v
    return (np.pi / 4) * D**2 * L - V


res_com_bounds = minimize(
    custo_2var,
    x0=[-0.5, 40.0],
    method="SLSQP",
    constraints={"type": "eq", "fun": restricao_volume},
    bounds=[(1e-6, None), (1e-6, None)],
    tol=1e-12,
)
print(res_com_bounds.x, res_com_bounds.success)
[2.33508866 2.33508863] TrueMesmo chute, resultado completamente diferente, só por causa dos
bounds. Dimensões físicas (diâmetros, comprimentos, concentrações,
temperaturas absolutas) quase sempre pedem um limite inferior de zero
explícito.
Otimização Multivariável Sem Restrições: Rosenbrock #
Para problemas sem restrição nenhuma, scipy.optimize.minimize aceita
vários métodos. O benchmark clássico para comparar todos eles é a função
de Rosenbrock (a “banana function”), \(f(x,y) = (1-x)^2 +
100(y-x^2)^2\), com mínimo conhecido em \((1,1)\), \(f=0\): um
vale estreito e curvo, desenhado propositalmente para ser difícil.
import numpy as np


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


x_ros = np.linspace(-2, 2, 300)
y_ros = np.linspace(-1, 3, 300)
X_ros, Y_ros = np.meshgrid(x_ros, y_ros)
Z_ros = rosenbrock([X_ros, Y_ros])
Como \(f\) tem duas variáveis de entrada e uma de saída, ela é literalmente uma superfície no espaço 3D: cada ponto \((x,y)\) tem uma “altura” \(f(x,y)\). Vale plotar essa superfície de verdade primeiro:
import matplotlib.pyplot as plt
import numpy as np


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


x_ros = np.linspace(-2, 2, 300)
y_ros = np.linspace(-1, 3, 300)
X_ros, Y_ros = np.meshgrid(x_ros, y_ros)
Z_ros = rosenbrock([X_ros, Y_ros])

fig = plt.figure()
ax = fig.add_subplot(projection="3d")
ax.plot_surface(X_ros, Y_ros, Z_ros, cmap="viridis")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_zlabel("f(x,y)")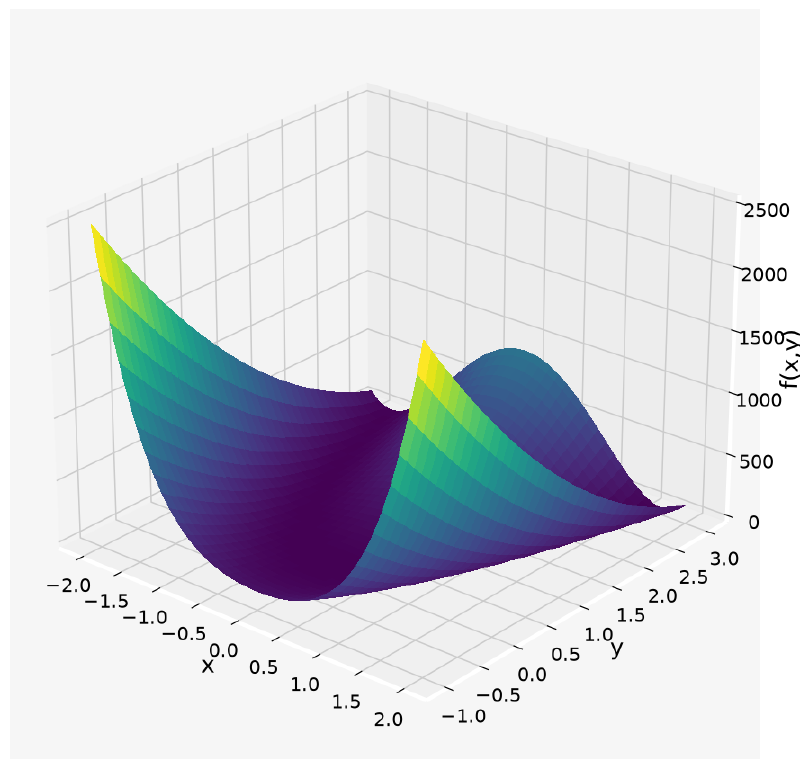
O vale está lá (é a faixa mais escura na base), mas a perspectiva 3D tem dois problemas: parte da superfície fica atrás de outra parte (oclusão), e a escala vertical, que precisa ir até \(\approx 2500\) para acomodar as encostas, comprime justamente a região que mais interessa. Um jeito melhor de enxergar o vale é achatar essa superfície e olhar de cima, com a terceira dimensão (a altura) codificada numa escala de cores em vez de posição vertical. É exatamente o que um mapa de contorno faz.
import matplotlib.pyplot as plt
import numpy as np


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


x_ros = np.linspace(-2, 2, 300)
y_ros = np.linspace(-1, 3, 300)
X_ros, Y_ros = np.meshgrid(x_ros, y_ros)
Z_ros = rosenbrock([X_ros, Y_ros])

fig, ax = plt.subplots()
ax.contourf(X_ros, Y_ros, np.log10(Z_ros + 1), levels=50, cmap="viridis")
ax.plot(-1.2, 1.0, "o", color="white", markeredgecolor="black", label="chute inicial")
ax.plot(1, 1, "*", color="red", markersize=16, markeredgecolor="black", label="mínimo (1,1)")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.legend()
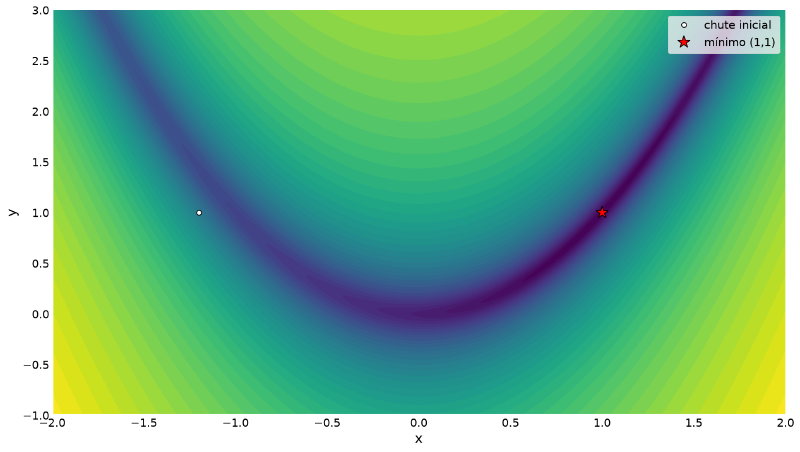
Na paleta de cores viridis, roxo escuro corresponde a valores baixos
de \(f\) (perto do mínimo) e amarelo, a valores altos (as encostas). O
código usa log10(Z+1), não \(Z\) puro, na escala de cor, pelo mesmo
motivo do 3D: perto do mínimo \(f\) é quase zero, longe dali passa de
milhares, e numa escala linear essa diferença enorme faria quase todo o
gráfico ficar de uma cor só (a das bordas), apagando o vale de novo. O
logaritmo comprime essa faixa gigante de valores para algo em que o
fundo do vale e as bordas ficam visíveis na mesma imagem (o +1 evita
log10(0), que não existe). O nome “banana function” vem exatamente
desse formato:
Um método que segue a direção de descida mais acentuada a cada passo, com um tamanho de passo fixo, tende a “ricochetear” de um lado a outro dentro desse vale estreito, em vez de andar direto até o mínimo. Isso não precisa ficar na palavra. Dá para implementar a descida mais íngreme em cinco linhas e desenhar o caminho:
import numpy as np


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


def grad_rosenbrock(v):
    x, y = v
    return np.array([-2 * (1 - x) - 400 * x * (y - x**2), 200 * (y - x**2)])


passo_fixo = 3e-3
v = np.array([-1.2, 1.0])
caminho = [v.copy()]
for _ in range(2000):
    v = v - passo_fixo * grad_rosenbrock(v)
    caminho.append(v.copy())
caminho = np.array(caminho)

lado = caminho[:, 1] - caminho[:, 0] ** 2   # de que lado do vale está
print("cruzou o vale", int((np.diff(np.sign(lado)) != 0).sum()), "vezes")
print(f"f final: {rosenbrock(caminho[-1]):.4f}")
cruzou o vale 1071 vezes
f final: 0.3268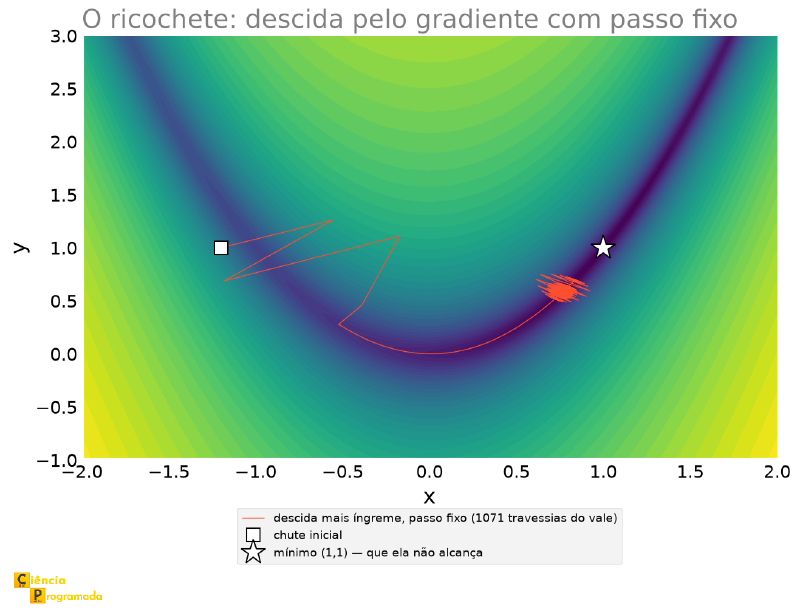
São 2000 passos para chegar a \(f = 0{,}33\), e o método nem chega ao mínimo: fica preso num emaranhado em torno de \(x = 0{,}74\), atravessando o vale de um lado ao outro mais de mil vezes. É esse o desperdício que os métodos de verdade evitam.
E evitam mesmo. O parâmetro callback do minimize é chamado a cada
iteração e permite gravar o caminho que os métodos do SciPy percorrem,
que, como se vê a seguir, não ricocheteia:
import matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize

def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


x_ros = np.linspace(-2, 2, 300)
y_ros = np.linspace(-1, 3, 300)
X_ros, Y_ros = np.meshgrid(x_ros, y_ros)
Z_ros = rosenbrock([X_ros, Y_ros])

fig, ax = plt.subplots(figsize=(9, 6.5))
ax.contourf(X_ros, Y_ros, np.log10(Z_ros + 1), levels=50, cmap="viridis")

for metodo, cor in (("Nelder-Mead", "C1"), ("BFGS", "C3"), ("Powell", "C5")):
    caminho = [np.array([-1.2, 1.0])]
    res_traj = minimize(rosenbrock, x0=[-1.2, 1.0], method=metodo,
                        callback=lambda xk, c=caminho: c.append(np.copy(xk)))
    traj = np.array(caminho)
    ax.plot(traj[:, 0], traj[:, 1], "o-", color=cor, markersize=4, linewidth=1.6,
            label=f"{metodo} ({res_traj.nit} iterações, {res_traj.nfev} avaliações)")

ax.plot(1, 1, "*", color="white", markeredgecolor="black", markersize=20)
ax.legend(loc="upper left", fontsize=9)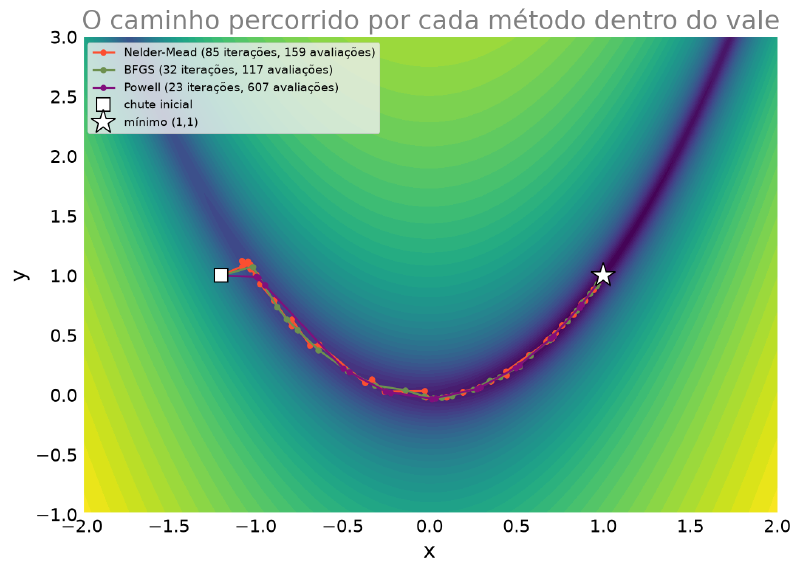
As três trajetórias ficam quase indistinguíveis, e isso é o resultado, não um defeito da figura: os três métodos resolvem o tamanho do passo antes de dar cada passo (é o que uma busca de linha faz), então cada iterada já cai perto do fundo do vale. O ricochete da figura anterior é o preço de não fazer isso.
Nenhum dos três vai em linha reta. Todos precisam contornar a curva do vale, e é exatamente aí que as iterações são gastas: o mínimo está a uma distância curta do chute inicial em linha reta, mas longe em “distância percorrida dentro do vale”.
import numpy as np
from scipy.optimize import minimize


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


for metodo in ["Nelder-Mead", "BFGS", "Powell"]:
    res = minimize(rosenbrock, x0=[-1.2, 1.0], method=metodo)
    print(f"{metodo:12s} x={np.round(res.x, 5)}  f={res.fun:.2e}  nit={res.nit}  nfev={res.nfev}")
Nelder-Mead x=[1.00002 1.00004] f=8.18e-10 nit=85 nfev=159
BFGS x=[1. 0.99999] f=2.02e-11 nit=32 nfev=117
Powell x=[1. 1.] f=1.79e-26 nit=23 nfev=607Os três chegam perto de \((1,1)\), mas com custos bem diferentes,
resumidos em duas contagens que todo resultado de minimize traz:
nit × nfev
nit (number of iterations) conta quantas vezes o algoritmo repetiu
seu laço principal; cada iteração tipicamente atualiza a estimativa
do ponto ótimo uma vez. nfev (number of function evaluations)
conta quantas vezes \(f\) foi de fato chamada no total, incluindo
todas as sub-chamadas internas de cada iteração (buscas de linha,
estimativa numérica de gradiente, etc.).
Quando \(f\) é cara de calcular (uma simulação, uma chamada de rede,
um modelo pesado), nfev costuma ser a métrica que importa de verdade,
porque mede o custo computacional real. nit baixo não garante barato:
aqui, Powell tem o menor nit (\(23\)) mas o maior nfev
(\(607\)), porque cada iteração dele faz uma busca de linha completa ao
longo de várias direções, então “poucas iterações” não significa
“pouco trabalho”.
Nelder-Mead é derivative-free (não usa gradiente, só avalia a função
em pontos e compara), simples e robusto, mas precisa de mais iterações
no vale curvo (\(\approx1{,}9\) avaliações por iteração). BFGS usa
uma aproximação numérica do gradiente internamente, por isso converge em
menos iterações (\(32\)), mas cada uma já embute o custo de estimar
esse gradiente (\(\approx3{,}7\) avaliações por iteração). Powell,
também derivative-free, faz uma busca de linha minuciosa a cada
iteração: poucas iterações, muitas avaliações, e aqui isso compensou
com uma precisão excelente (\(f \approx 10^{-26}\)).
A sigla (Broyden, Fletcher, Goldfarb e Shanno) não diz nada sobre o método, e vale saber o que ele faz de diferente.
A descida de gradiente pura anda sempre na direção de maior declive. Num vale estreito e torto como o de Rosenbrock, essa direção aponta para a parede do vale, não para o fundo dele, daí o ricocheteio. O que resolveria isso é conhecer a curvatura, que mora na matriz hessiana (as segundas derivadas); com ela, o método de Newton daria passos que, numa quadrática, levariam direto ao mínimo.
O problema é que a hessiana de um problema com \(n\) variáveis tem \(n^2\) entradas, e calculá-la costuma ser proibitivo. A sacada do BFGS é não calcular: ele começa com um chute grosseiro para a hessiana (a identidade) e vai corrigindo essa estimativa a cada passo, usando as diferenças entre gradientes e entre posições consecutivas, informação que ele já tem de graça. Por isso o nome da família: métodos quase-Newton.
Na maioria dos casos, isso dá quase a velocidade de Newton, sem o custo
de montar a hessiana. E é a razão de o BFGS ser o
padrão do minimize quando não há restrições.
Fornecendo o Gradiente com jac
#
O artigo de derivadas numéricas
prometeu que essa conta voltaria: quando o gradiente analítico não está
disponível, o otimizador o estima por diferenças finitas, e paga uma
avaliação extra da função por variável, a cada iteração. É de onde vêm as
\(117\) avaliações do BFGS acima, para apenas \(32\) iterações.
Quando dá para escrever o gradiente à mão, o parâmetro jac evita esse
custo inteiro. Para Rosenbrock ele sai em duas linhas:
import numpy as np
from scipy.optimize import minimize


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


def jac_rosenbrock(v):
    x, y = v
    return np.array([-2 * (1 - x) - 400 * x * (y - x**2),
                     200 * (y - x**2)])

for rotulo, jac in (("sem jac (diferenças finitas)", None),
                    ("com jac analítico", jac_rosenbrock)):
    r = minimize(rosenbrock, x0=[-1.2, 1.0], method="BFGS", jac=jac)
    print(f"{rotulo:>30}: nit={r.nit:>3}  nfev={r.nfev:>4}  njev={r.njev:>3}  f={r.fun:.2e}")
sem jac (diferenças finitas): nit= 32 nfev= 117 njev= 39 f=2.02e-11
com jac analítico: nit= 32 nfev= 39 njev= 39 f=2.54e-15Dois ganhos de uma vez, e o segundo é o mais interessante:
- Três vezes menos avaliações da função (117 → 39), com o mesmo número de iterações. As avaliações que sumiram eram exatamente as gastas estimando o gradiente.
- Precisão dez mil vezes melhor (\(2\times10^{-11}\) → \(2{,}5\times10^{-15}\)). O gradiente estimado por diferenças finitas carrega o mesmo erro em \(U\) do artigo de derivadas numéricas, e esse erro se propaga para a solução. O gradiente analítico é exato.
3×
menos avaliações
10.000×
mais precisão
Quando \(f\) é cara (uma simulação, uma EDO resolvida a cada chamada, como no próximo artigo), o primeiro ganho é o que importa. Quando se precisa de muitos dígitos, o segundo.
| Método | Nome por trás da sigla | Usa gradiente? | Quando usar |
|---|---|---|---|
Nelder-Mead |
Método do simplex de Nelder e Mead | Não | Função não suave ou ruidosa; poucas variáveis; robustez acima de velocidade |
Powell |
Método de Powell (buscas de linha em direções conjugadas) | Não | Sem gradiente disponível, mas função suave o bastante para buscas de linha valerem a pena; boa precisão final |
BFGS |
Broyden-Fletcher-Goldfarb-Shanno | Sim (aproximado numericamente se não fornecido) | Função suave e diferenciável; escolha padrão quando não há restrições |
L-BFGS-B |
Limited-memory BFGS com Bounds | Sim (aproximado) | Como BFGS, mas com bounds, versão econômica em memória, melhor para muitas variáveis |
SLSQP |
Sequential Least Squares Programming | Sim (aproximado) | Quando há constraints de igualdade/desigualdade (visto na seção do tanque) |
Não existe “melhor método” único: a escolha troca robustez, velocidade e precisão final dependendo do que se está otimizando, e do que realmente custa caro no problema.
Mínimos Locais × Globais #
Toda essa seção até aqui tem um pressuposto silencioso: que o método converge para o mínimo certo. Isso só é garantido quando existe um único mínimo. Assim que a função tem mais de um, o resultado passa a depender de onde a busca começa.
Exemplo 3: Himmelblau: o resultado depende do chute inicial
Enunciado: A função de Himmelblau, \(f(x,y) = (x^2+y-11)^2 + (x+y^2-7)^2\), tem quatro mínimos globais conhecidos, todos com \(f=0\). Minimize a partir de 5 chutes iniciais espalhados e compare os resultados.
Solução:
import numpy as np
from scipy.optimize import minimize


def himmelblau(v):
    x, y = v
    return (x**2 + y - 11) ** 2 + (x + y**2 - 7) ** 2


chutes = [(0, 0), (-4, 4), (4, -4), (-4, -4), (5, 5)]
for c in chutes:
    res = minimize(himmelblau, x0=c, method="BFGS")
    print(f"chute={str(c):<8}  ->  x={str(np.round(res.x, 4)):<17} f={res.fun:.2e}")
chute=(0, 0) -> x=[3. 2.] f=1.38e-13
chute=(-4, 4) -> x=[-2.8051 3.1313] f=1.02e-13
chute=(4, -4) -> x=[ 3.5844 -1.8481] f=6.51e-16
chute=(-4, -4) -> x=[-3.7793 -3.2832] f=1.92e-14
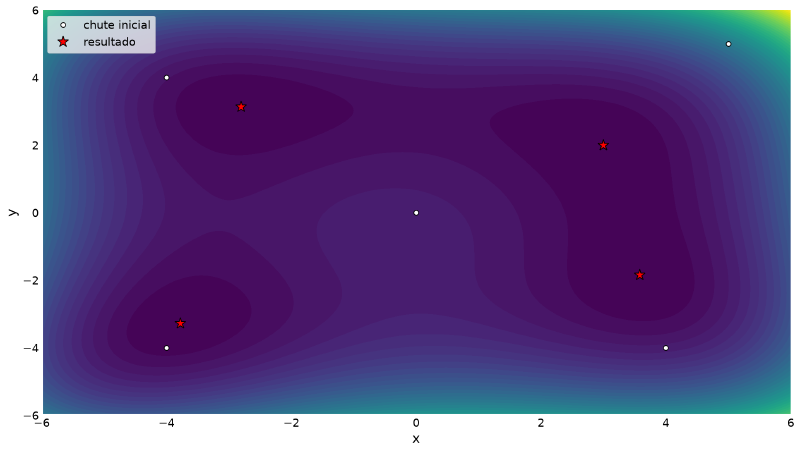
chute=(5, 5) -> x=[3. 2.] f=1.20e-12Cinco chutes, quatro resultados diferentes (dois deles caem no mesmo
mínimo, \((3,2)\)), todos igualmente corretos, no sentido de que
todos são mínimos globais de fato. Não existe isso no mundo do SymPy:
solve na derivada devolveria os quatro de uma vez, sem depender de
chute nenhum.
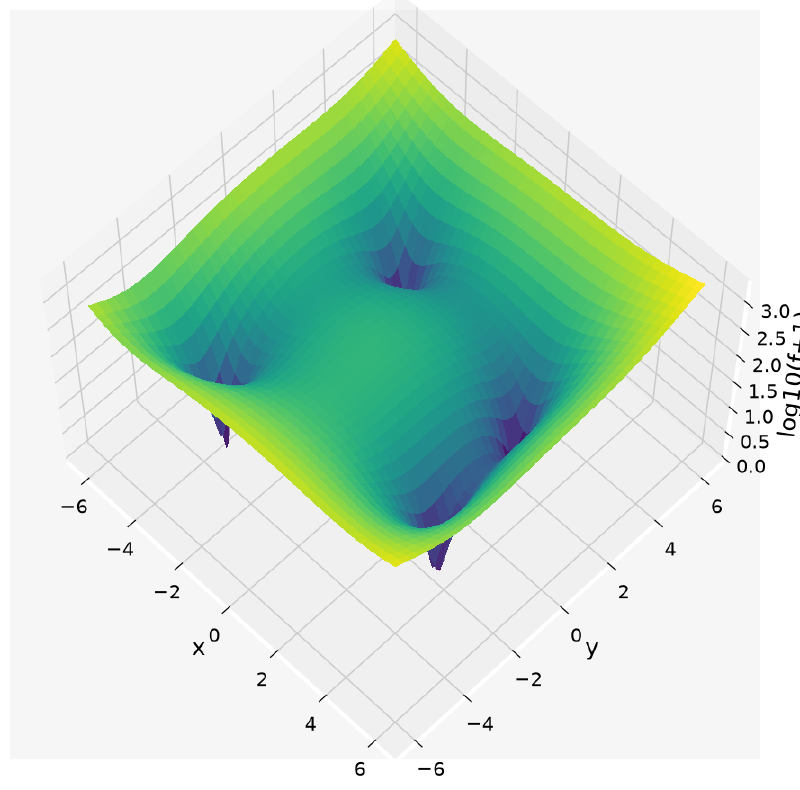
Assim como no caso de Rosenbrock, vale ver a superfície inteira antes de achatar:
import matplotlib.pyplot as plt
import numpy as np


def himmelblau(v):
    x, y = v
    return (x**2 + y - 11) ** 2 + (x + y**2 - 7) ** 2


x_grid = np.linspace(-6, 6, 300)
y_grid = np.linspace(-6, 6, 300)
X, Y = np.meshgrid(x_grid, y_grid)
Z = himmelblau([X, Y])

fig = plt.figure()
ax = fig.add_subplot(projection="3d")
ax.plot_surface(X, Y, np.log10(Z + 1), cmap="viridis")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_zlabel("log10(f+1)")
ax.view_init(elev=60, azim=-45)
De novo em escala logarítmica, pelo mesmo motivo de antes. Os quatro mínimos aparecem como quatro furos afiados na superfície, um em cada “canto” do relevo:
Achatando essa mesma superfície num mapa de contorno (agora sem
necessidade de log, porque a escala de cor do viridis já distingue bem o
fundo de cada bacia mesmo em valores lineares):
import matplotlib.pyplot as plt
import numpy as np
from scipy.optimize import minimize


def himmelblau(v):
    x, y = v
    return (x**2 + y - 11) ** 2 + (x + y**2 - 7) ** 2


x_grid = np.linspace(-6, 6, 300)
y_grid = np.linspace(-6, 6, 300)
X, Y = np.meshgrid(x_grid, y_grid)
Z = himmelblau([X, Y])

chutes = [(0, 0), (-4, 4), (4, -4), (-4, -4), (5, 5)]
resultados_himmelblau = [minimize(himmelblau, x0=c, method="BFGS").x for c in chutes]

fig, ax = plt.subplots()
ax.contourf(X, Y, Z, levels=50, cmap="viridis")
ax.plot([], [], "o", color="white", markeredgecolor="black", label="chute inicial")
ax.plot([], [], "*", color="red", markersize=14, markeredgecolor="black", label="resultado")
for c, xr in zip(chutes, resultados_himmelblau):
    ax.plot(*c, "o", color="white", markeredgecolor="black")
    ax.plot(*xr, "*", color="red", markersize=14, markeredgecolor="black")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.legend()
O mapa de calor a seguir mostra as quatro bacias de atração (regiões escuras) e como cada chute (círculo branco) cai num dos quatro mínimos (estrela vermelha):
Cinco chutes viram um retrato pontual. Dá para transformá-los num mapa:
colorir cada ponto do plano pela cor do mínimo para onde o BFGS converge
partindo dali. São as bacias de atração.
import numpy as np
from scipy.optimize import minimize


def himmelblau(v):
    x, y = v
    return (x**2 + y - 11) ** 2 + (x + y**2 - 7) ** 2


minimos = np.array([[3.0, 2.0], [-2.805118, 3.131312],
                    [-3.779310, -3.283186], [3.584428, -1.848126]])

n_grade = 130
xs_b = ys_b = np.linspace(-6, 6, n_grade)
bacia = np.full((n_grade, n_grade), -1, dtype=int)
for i, yv in enumerate(ys_b):
    for j, xv in enumerate(xs_b):
        r = minimize(himmelblau, x0=[xv, yv], method="BFGS")
        d = np.linalg.norm(minimos - r.x, axis=1)
        if d.min() < 1e-3:
            bacia[i, j] = int(np.argmin(d))

for k in range(4):
    print(f"mínimo {tuple(np.round(minimos[k], 2).tolist())}: {(bacia == k).mean():.1%} do plano")
mínimo (3.0, 2.0): 24.1% do plano
mínimo (-2.81, 3.13): 26.1% do plano
mínimo (-3.78, -3.28): 24.5% do plano
mínimo (3.58, -1.85): 25.3% do plano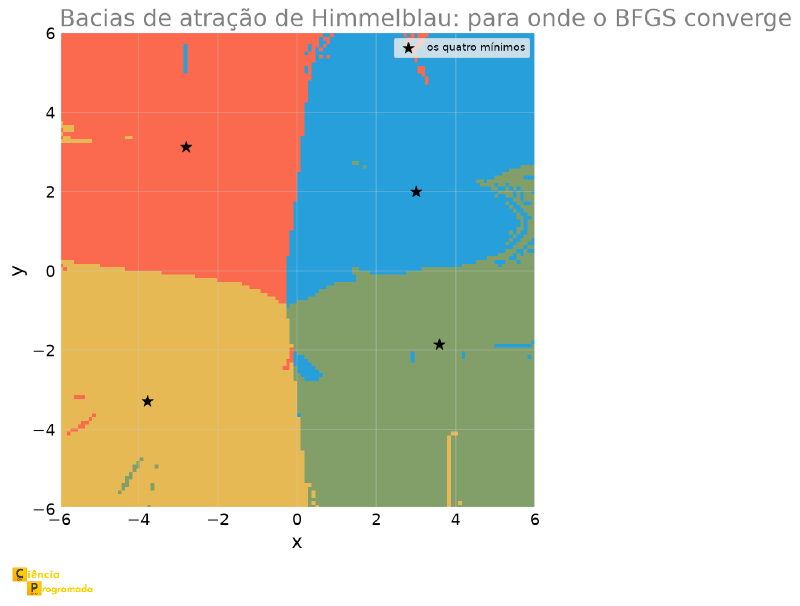
Duas leituras. A primeira é tranquilizadora: as quatro bacias ficam com um quarto do plano cada, e todo ponto testado converge para algum mínimo. A segunda, nem tanto: repare nas fronteiras. Elas não são retas nem suaves: são irregulares, e há ilhas isoladas de uma cor bem no meio do território de outra. Perto delas, dois chutes iniciais quase idênticos terminam em mínimos diferentes.
É a mesma estrutura que apareceu nas bacias de Newton do primeiro artigo desta série, e pela mesma razão: métodos iterativos que seguem a geometria local não têm como garantir continuidade no destino final.
Himmelblau tem uma particularidade: os quatro mínimos são igualmente
bons (todos com \(f=0\)). O problema mais comum na prática é outro:
mínimos locais que são genuinamente piores que o mínimo global.
Nesse caso, todo método visto até aqui (Nelder-Mead, BFGS,
Powell, SLSQP) tem a mesma limitação: parte de um único chute e só
enxerga a vizinhança dele.
scipy.optimize.differential_evolution ataca o problema de outro jeito.
Em vez de refinar uma única estimativa passo a passo, ele mantém uma
população inteira de candidatos espalhados pelo domínio e os faz
evoluir por gerações (combinando pares, aplicando mutações aleatórias,
descartando os piores), um algoritmo evolutivo, no mesmo espírito dos
algoritmos genéticos. Por vasculhar o domínio inteiro, em vez de refinar
a partir de um ponto só, não precisa de chute inicial nenhum, só dos
bounds da busca. O custo é o número de avaliações da função, bem maior
que o de um método local.
Exemplo 4: Um mínimo pior que o outro
Enunciado: \(f(x) = x^2 + 10\sin(x)\) tem só dois mínimos locais
no intervalo \([-10, 10]\) (a derivada, \(f^{\prime}(x)=2x+10\cos x\), só
zera para \(|x| \lesssim 5\)). Encontre os dois e compare com o que
differential_evolution devolve, sem chute inicial nenhum.
Solução:
import numpy as np
from scipy.optimize import differential_evolution, minimize


def f_dois_minimos(x):
    return x**2 + 10 * np.sin(x)


for c in [-8, -5, -2, 0, 2, 5, 8]:
    res = minimize(f_dois_minimos, x0=[c], method="BFGS")
    print(f"chute={c:5.1f}  ->  x={res.x[0]:.4f}  f={res.fun:.4f}")

res_de = differential_evolution(lambda v: f_dois_minimos(v[0]), bounds=[(-10, 10)], seed=1)
print("differential_evolution:", res_de.x, res_de.fun)
chute= -8.0 -> x=-1.3064 f=-7.9458
chute= -5.0 -> x=-1.3064 f=-7.9458
chute= -2.0 -> x=-1.3064 f=-7.9458
chute= 0.0 -> x=-1.3064 f=-7.9458
chute= 2.0 -> x=3.8375 f=8.3156
chute= 5.0 -> x=3.8375 f=8.3156
chute= 8.0 -> x=3.8375 f=8.3156
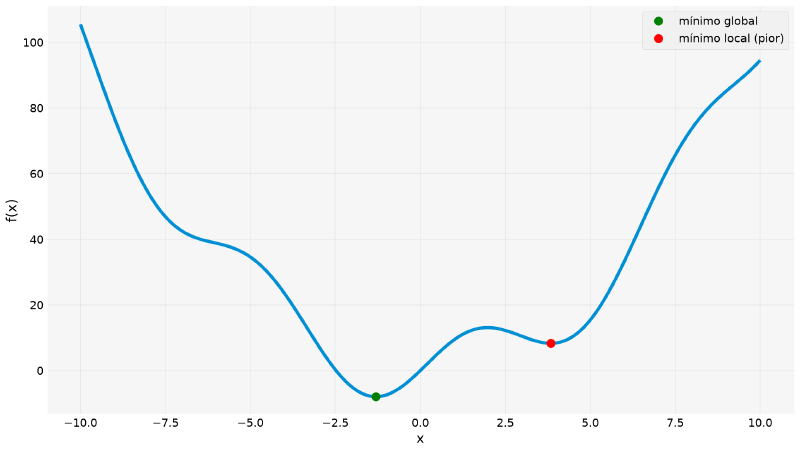
differential_evolution: [-1.30644002] -7.945823375615283Chutes negativos ou zero caem no mínimo global (\(f\approx-7{,}95\));
chutes positivos ficam presos no mínimo local pior (\(f\approx
8{,}32\): nem chega a ser negativo!). differential_evolution acha o
mínimo global de primeira, sem que nenhum chute tenha sido fornecido.
import matplotlib.pyplot as plt
import numpy as np


def f_dois_minimos(x):
    return x**2 + 10 * np.sin(x)


xs_plot = np.linspace(-10, 10, 400)
fig, ax = plt.subplots()
ax.plot(xs_plot, f_dois_minimos(xs_plot))
ax.plot(-1.3064, f_dois_minimos(-1.3064), "o", color="green", markersize=10, label="mínimo global")
ax.plot(3.8375, f_dois_minimos(3.8375), "o", color="red", markersize=10, label="mínimo local (pior)")
ax.set_xlabel("x")
ax.set_ylabel("f(x)")
ax.legend()
O gráfico a seguir mostra os dois mínimos, lado a lado:
Rastrigin: Onde a Busca Global Deixa de Ser Luxo #
Com apenas dois mínimos, differential_evolution parece exagero: um
minimize a partir de dois ou três chutes resolveria. O caso em que ele se
torna indispensável é outro: quando os mínimos locais são dezenas.
A função de Rastrigin é o benchmark canônico para isso. É um paraboloide simples com uma ondulação cossenoidal superposta, o que cria uma grade regular de buracos:
$$ f(\mathbf{x}) = 10n + \sum_{i=1}^{n}\left[x_i^2 - 10\cos(2\pi x_i)\right] $$O mínimo global é trivialmente conhecido, a origem, com \(f = 0\), o que a torna perfeita para testar se um método o encontra.
import numpy as np
from scipy.optimize import differential_evolution, minimize


def rastrigin(v):
    return 20 + sum(x**2 - 10 * np.cos(2 * np.pi * x) for x in v)

for c in [(-4, -4), (-2, 3), (1, 1), (3, -2), (4.5, 4.5)]:
    r = minimize(rastrigin, x0=c, method="BFGS")
    print(f"chute {str(c):>11} -> x={np.round(r.x, 3)}  f={r.fun:.4f}")

res_rast = differential_evolution(rastrigin, bounds=[(-5.12, 5.12)] * 2, seed=1)
print(f"differential_evolution -> x={np.round(res_rast.x, 4)}  f={res_rast.fun:.2e}")
chute (-4, -4) -> x=[-3.98 -3.98] f=31.8385
chute (-2, 3) -> x=[-1.99 2.985] f=12.9344
chute (1, 1) -> x=[0.995 0.995] f=1.9899
chute (3, -2) -> x=[ 2.985 -1.99 ] f=12.9344
chute (4.5, 4.5) -> x=[3.98 3.98] f=31.8385
differential_evolution -> x=[-0. -0.] f=0.00e+00Cinco chutes, cinco mínimos locais diferentes, e nenhum deles é o
global. O melhor resultado do BFGS foi \(f = 1{,}99\); o global é
\(0\). Repare no padrão. O método sempre para no buraco mais próximo do
chute: \((-3{,}98;\ -3{,}98)\), \((0{,}995;\ 0{,}995)\) e assim por
diante, todos perto de inteiros, que é onde os buracos de Rastrigin ficam.
A figura a seguir mostra o relevo e onde cada busca foi parar:
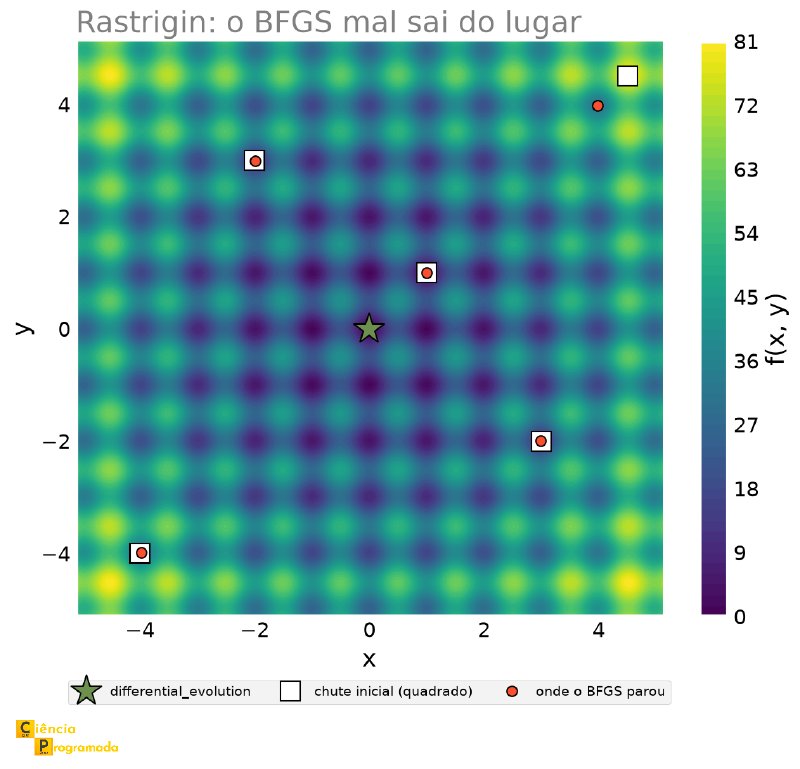
Repare no que a figura não mostra: nenhum caminho. Em quatro dos cinco
chutes o círculo do resultado está desenhado dentro do quadrado de partida,
porque o deslocamento total foi de \(0{,}007\) a \(0{,}029\) unidade,
num gráfico com \(10\) unidades de largura, menos de \(0{,}3\%\) da
figura. Não há linha a desenhar: o BFGS já nasce dentro do buraco em que
vai morrer.
A exceção é o chute \((4{,}5;\ 4{,}5)\), no canto superior direito, o único que cai entre dois buracos em vez de dentro de um. Esse anda \(0{,}736\), o suficiente para o olho ver, e mesmo assim só rola para o buraco vizinho, em \((3{,}98;\ 3{,}98)\), tão longe do global quanto os outros.
O differential_evolution acerta o global exatamente, ao custo de
\(2163\) avaliações da função, contra as poucas dezenas de cada BFGS.
É essa a troca: busca local é barata e mente; busca global é cara e não mente. Com uma função barata de avaliar, pague a busca global. Com uma função cara, use busca local a partir de vários chutes (multistart) e saiba que você pode estar num buraco qualquer.
Pontos de Atenção #
result.success
minimize pode devolver um resultado sem ter convergido de fato.
Limitando artificialmente o número de iterações do exemplo de
Rosenbrock:
import numpy as np
from scipy.optimize import minimize


def rosenbrock(v):
    x, y = v
    return (1 - x) ** 2 + 100 * (y - x**2) ** 2


res_falha = minimize(rosenbrock, x0=[-1.2, 1.0], method="Nelder-Mead", options={"maxiter": 5})
print(res_falha.success, res_falha.message, res_falha.x, res_falha.fun)
False Maximum number of iterations has been exceeded. [-1.065 1.1 ] 4.381360062499992O resultado, \((-1{,}065,\ 1{,}1)\) com \(f\approx4{,}38\), parece
um número qualquer: nada nele avisa visualmente que está longe do
verdadeiro mínimo, \((1,1)\) com \(f=0\). Só result.success (e
result.message) denunciam o problema.
Escala das Variáveis: o Número de Condição #
Um último ponto de atenção, e é o mais fácil de ignorar: a escala das variáveis afeta o quanto o otimizador trabalha. A causa tem nome, e é o mesmo conceito que apareceu no artigo de polinômios: mal-condicionamento.
Considere \(f(x,y) = x^2 + 10^6 y^2\). É um paraboloide perfeitamente comum, com mínimo em \((0,0)\), mas extremamente alongado: a curvatura na direção \(y\) é um milhão de vezes maior que na direção \(x\). As curvas de nível não são círculos, são elipses finíssimas, e um otimizador que caminha “morro abaixo” fica ricocheteando entre as paredes do vale, como no Rosenbrock, só que por outro motivo.
import numpy as np
from scipy.optimize import minimize

mal_condicionada = lambda v: v[0] ** 2 + 1e6 * v[1] ** 2
bem_condicionada = lambda v: v[0] ** 2 + v[1] ** 2   # depois de reescalar y

for metodo in ("Nelder-Mead", "BFGS"):
    r_mal = minimize(mal_condicionada, x0=[1.0, 1.0], method=metodo)
    r_bem = minimize(bem_condicionada, x0=[1.0, 1.0], method=metodo)
    print(f"{metodo:12s} mal condicionado: nfev={r_mal.nfev:4d} | "
          f"reescalado: nfev={r_bem.nfev:3d}")
Nelder-Mead mal condicionado: nfev= 134 | reescalado: nfev= 69
BFGS mal condicionado: nfev= 21 | reescalado: nfev= 9Os dois métodos gastam cerca do dobro de avaliações no problema alongado, e é literalmente o mesmo problema, a menos de uma troca de variável \(y^{\prime} = 1000y\). Nada foi ganho em precisão; só se pagou mais por ela.
O número de condição da hessiana mede exatamente esse alongamento: é a razão entre a maior e a menor curvatura. Aqui vale \(10^6\); no problema reescalado, vale \(1\). A regra prática que se tira disso:
Se suas variáveis têm ordens de grandeza muito diferentes (uma temperatura em kelvin (\(\sim 10^2\)) ao lado de uma concentração em mol/L (\(\sim 10^{-3}\)), por exemplo), reescale todas para algo em torno de 1 antes de chamar o otimizador, e desfaça a escala no fim. É barato, e costuma ser a diferença entre convergir rápido e não convergir.
SLSQP espera que uma restrição 'ineq' retorne um valor
\(\geq 0\) quando satisfeita. Inverter esse sinal por engano não gera
exceção, só otimiza a região errada, silenciosamente:
from scipy.optimize import minimize


def objetivo_simples(v):
    x, y = v
    return x**2 + y**2


res_certo = minimize(
    objetivo_simples, x0=[0, 0], method="SLSQP",
    constraints={"type": "ineq", "fun": lambda v: v[0] + v[1] - 1},  # x+y >= 1
)
res_errado = minimize(
    objetivo_simples, x0=[0, 0], method="SLSQP",
    constraints={"type": "ineq", "fun": lambda v: 1 - (v[0] + v[1])},  # vira x+y <= 1
)
print("correto:", res_certo.x, res_certo.success)
print("sinal invertido:", res_errado.x, res_errado.success)
correto: [0.5 0.5] True
sinal invertido: [0. 0.] TrueAs duas chamadas devolvem success=True: a segunda simplesmente
resolveu \(x+y\leq1\) em vez de \(x+y\geq1\), e o mínimo de
\(x^2+y^2\) sujeito a essa restrição trocada é trivialmente
\((0,0)\), a origem, que satisfaz a restrição invertida sem
problema nenhum. Nada no retorno avisa que a restrição pretendida era
outra.
Tabela-Resumo #
| Ferramenta / conceito | Uso | Observação |
|---|---|---|
minimize_scalar |
Minimização em 1 variável | Só busca mínimo, nunca devolve um máximo local |
minimize(..., method=) |
Minimização multivariável | 'Nelder-Mead'/'Powell' (sem gradiente), 'BFGS' (com gradiente aproximado) |
constraints={'type': 'eq'/'ineq', 'fun': ...} |
Restrições de igualdade/desigualdade (SLSQP) |
'ineq' exige fun(x) >= 0, sinal trocado erra a região silenciosamente |
bounds=[(min, max), ...] |
Limites de caixa por variável | Sem eles, o otimizador pode buscar num domínio fisicamente absurdo, ou nem convergir |
nit × nfev |
Iterações do algoritmo × chamadas totais da função | nfev é a métrica de custo real quando f é cara de calcular |
| Superfície 3D → mapa de contorno | Visualizar f(x,y) achatando a terceira dimensão em cor |
log10(Z+1) na escala de cor evita que valores extremos apaguem o relevo perto do mínimo |
| Mínimo local × global | Resultado depende do chute inicial quando há mais de um mínimo | solve do SymPy acha todos de uma vez; minimize só o mais próximo do chute |
differential_evolution |
Busca global, não precisa de chute inicial | Mais cara computacionalmente; útil quando há múltiplos mínimos de qualidades diferentes |
result.success / result.message |
Confirmação explícita de convergência | Nunca assumir que um minimize convergiu sem checar |
| Escala das variáveis | Afeta o número de avaliações até convergir | Normalizar para ordens de grandeza comparáveis acelera a busca |
Próximos Passos #
Este artigo cobriu os fundamentos de scipy.optimize com um único
problema real de verdade, o tanque cilíndrico, generalizando o que o
artigo de otimização do SymPy resolveu de forma simbólica. Mas
otimização real raramente para
numa restrição de igualdade só, em duas variáveis: química, física e
engenharia trazem problemas com restrições de desigualdade, funções de
custo mais elaboradas, e situações em que a própria equação diferencial
de um sistema faz parte do que se quer otimizar. No
próximo artigo,
essas aplicações reais entram em cena, incluindo uma que reaproveita
diretamente o solve_ivp do artigo de equações diferenciais desta série.