Um relatório de laboratório que diz “a energia de ativação é \(50.361\) J/mol” está incompleto, e de um jeito que importa. Não porque o número esteja errado, mas porque ele não vem acompanhado da única informação que permite usá-lo: quanto ele pode variar. Se a incerteza for de \(200\) J/mol, o valor distingue dois mecanismos de reação. Se for de \(8.000\), não distingue nada.
Todos os ajustes que esta série fez até aqui produziram números sem incerteza. O artigo de ajuste de curvas ajustou retas de calibração e módulos de elasticidade a dados explicitamente descritos como ruidosos, e reportou coeficientes secos. Não foi descuido: era o assunto errado na hora errada, e a hora certa é agora.
Este artigo fecha duas contas de uma vez. A primeira é essa: como extrair incertezas de um ajuste. A segunda é uma promessa feita literalmente na abertura do artigo de otimização, a de que ajustar uma curva é um problema de otimização disfarçado. Está na hora de mostrar que é mesmo, rodando os dois caminhos e comparando.
Por Que Ajuste Não-Linear e Incertezas Importam? #
- Toda medição tem erro: um parâmetro extraído de dados experimentais sem barra de erro não é um resultado científico, e sim um palpite bem formatado. Revistas costumam exigir a incerteza, e com razão.
- Química e cinética: energia de ativação, constantes de velocidade, \(K_m\) e \(V_{max}\) de enzimas, constantes de equilíbrio. Praticamente todo parâmetro cinético ou termodinâmico vem de um ajuste não-linear a dados.
- Decisão de engenharia: dimensionar com base num parâmetro ajustado exige saber a incerteza dele para escolher o coeficiente de segurança. Sem ela, ou se superdimensiona por medo, ou se subdimensiona por ignorância.
- Modelos concorrentes: decidir se um modelo é melhor que outro passa por comparar parâmetros com suas incertezas. Dois valores que diferem por menos que a soma das barras de erro não diferem de fato.
Ajustar É Minimizar #
O artigo de otimização abre afirmando que ajustar uma curva é otimizar. A afirmação é literal, e a demonstração é curta.
Dado um modelo \(f(x; \theta)\) com parâmetros \(\theta\) e um conjunto de medidas \((x_i, y_i)\), o melhor ajuste é o vetor de parâmetros que minimiza a soma dos quadrados dos resíduos:
$$S(\theta) = \sum_{i=1}^{N} \left[y_i - f(x_i; \theta)\right]^2$$“Ajustar uma curva” é, por definição, resolver um problema de
minimização em \(\theta\), exatamente o tipo de problema que o
scipy.optimize.minimize resolve.
O método é de Gauss, que o usou em 1801 para recalcular a órbita do asteroide Ceres a partir de umas poucas observações antes de ele se perder atrás do Sol, e acertou onde reaparecia. Ele só publicou o método em 1809, e nesse meio-tempo Legendre publicou o mesmo resultado, em 1805, gerando uma das disputas de prioridade mais conhecidas da matemática. A estatística nasceu, em boa parte, de astronomia.
Rodando os dois caminhos sobre o mesmo problema, um decaimento exponencial \(y = A e^{-kt}\) medido com ruído:
import numpy as np
from scipy.optimize import curve_fit, minimize


def modelo_exp(t, A, k):
    return A * np.exp(-k * t)


rng = np.random.default_rng(42)
t_dados = np.linspace(0, 5, 25)
y_dados = modelo_exp(t_dados, 2.5, 0.8) + rng.normal(0, 0.08, t_dados.size)


# caminho 1: escrever a soma dos quadrados na mão e minimizar
def soma_quadrados(params):
    A, k = params
    return np.sum((y_dados - modelo_exp(t_dados, A, k)) ** 2)


res_min = minimize(soma_quadrados, x0=[1.0, 1.0], method="Nelder-Mead",
                   options={"xatol": 1e-12, "fatol": 1e-12})

# caminho 2: curve_fit
popt, pcov = curve_fit(modelo_exp, t_dados, y_dados, p0=[1.0, 1.0])

print(f"minimize  : A = {res_min.x[0]:.10f}, k = {res_min.x[1]:.10f}")
print(f"curve_fit : A = {popt[0]:.10f}, k = {popt[1]:.10f}")
print(f"diferença : {np.abs(res_min.x - popt).max():.2e}")
minimize : A = 2.4830688457, k = 0.8022242483
curve_fit : A = 2.4830688231, k = 0.8022242292
diferença : 2.26e-08Oito casas decimais de concordância: é o mesmo problema. O curve_fit
não faz nada de conceitualmente diferente do minimize: ele apenas sabe
que o objetivo é uma soma de quadrados e usa isso a seu favor, com um
algoritmo especializado (por padrão Levenberg-Marquardt, ou Trust Region
Reflective quando há bounds) que explora essa estrutura.
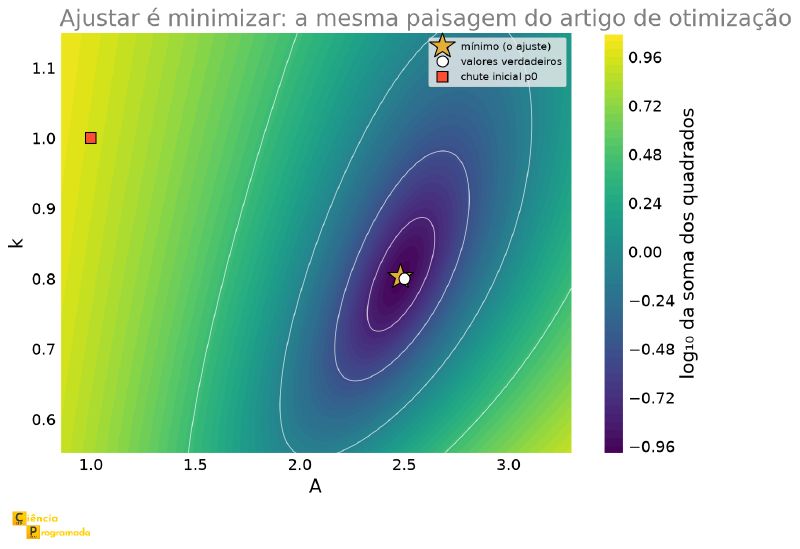
E como é o mesmo problema, ele tem a mesma paisagem. A superfície da soma dos quadrados no plano \((A, k)\) é exatamente o tipo de mapa de contorno que o artigo de otimização usou:
minimize em vez de curve_fit?
Use curve_fit sempre que o problema for “tenho \((x_i, y_i)\) e um
modelo \(f(x; \theta)\)”. É mais curto, mais rápido, e devolve a
matriz de covariância, que o minimize não devolve.
Recorra ao minimize quando o objetivo não for uma soma de quadrados
simples: quando houver restrições nos parâmetros que bounds não
expresse, quando o critério for outro (máxima verossimilhança com uma
distribuição não-gaussiana, mínimos desvios absolutos, regularização), ou
quando os resíduos não puderem ser escritos como y - f(x).
O Que o curve_fit Dá a Mais: pcov
#
Aquele segundo valor de retorno que todo mundo ignora é a razão de existir deste artigo.
O curve_fit devolve (popt, pcov). A pcov é a matriz de
covariância estimada dos parâmetros ajustados:
- A diagonal contém as variâncias. A raiz quadrada de cada elemento
diagonal é o desvio padrão (a “barra de erro”) do parâmetro
correspondente:
np.sqrt(np.diag(pcov)). - Os elementos fora da diagonal são as covariâncias entre pares de parâmetros. Divididos pelo produto dos desvios padrão, dão a correlação entre eles.
Ela sai de graça: o algoritmo precisa da matriz jacobiana para caminhar até o mínimo, e a covariância é essencialmente o inverso de \(J^T J\), reescalado pela variância residual. O trabalho já foi feito.
import numpy as np
from scipy.optimize import curve_fit


def modelo_exp(t, A, k):
    return A * np.exp(-k * t)


rng = np.random.default_rng(42)
t_dados = np.linspace(0, 5, 25)
y_dados = modelo_exp(t_dados, 2.5, 0.8) + rng.normal(0, 0.08, t_dados.size)
popt, pcov = curve_fit(modelo_exp, t_dados, y_dados, p0=[1.0, 1.0])

incertezas = np.sqrt(np.diag(pcov))
for nome, val, inc, verdade in zip(("A", "k"), popt, incertezas, (2.5, 0.8)):
    print(f"{nome} = {val:.4f} ± {inc:.4f}   (verdadeiro: {verdade})")

corr = pcov[0, 1] / np.sqrt(pcov[0, 0] * pcov[1, 1])
print(f"\ncorrelação entre A e k: {corr:+.4f}")
A = 2.4831 ± 0.0473 (verdadeiro: 2.5)
k = 0.8022 ± 0.0236 (verdadeiro: 0.8)
correlação entre A e k: +0.6482Os dois valores verdadeiros caem dentro de uma barra de erro do ajustado, que é exatamente o que se espera quando tudo está funcionando.
E a correlação de \(+0{,}65\) não é ruído: ela é visível na figura anterior. O vale da soma dos quadrados é alongado na diagonal, e isso tem significado físico direto. Se o ajuste superestimar \(A\), ele precisa superestimar \(k\) também: uma amplitude inicial maior tem de decair mais rápido para passar pelos mesmos pontos no meio da curva. Os dois erros andam juntos.
Uma correlação próxima de \(\pm 1\) significa que os parâmetros são quase indistinguíveis a partir desses dados: existe uma direção no espaço de parâmetros ao longo da qual a soma dos quadrados quase não muda. O ajuste “converge”, mas os valores individuais são pouco confiáveis mesmo que o modelo descreva bem os dados.
A solução normalmente não é numérica, é experimental: medir numa faixa mais ampla. Aqui, medir tempos mais longos separaria melhor \(A\) de \(k\), porque a cauda depende quase só de \(k\).
Com a incerteza em mãos, o ajuste deixa de ser uma curva e passa a ser uma faixa, e os resíduos passam a ser interpretáveis contra o ruído esperado:
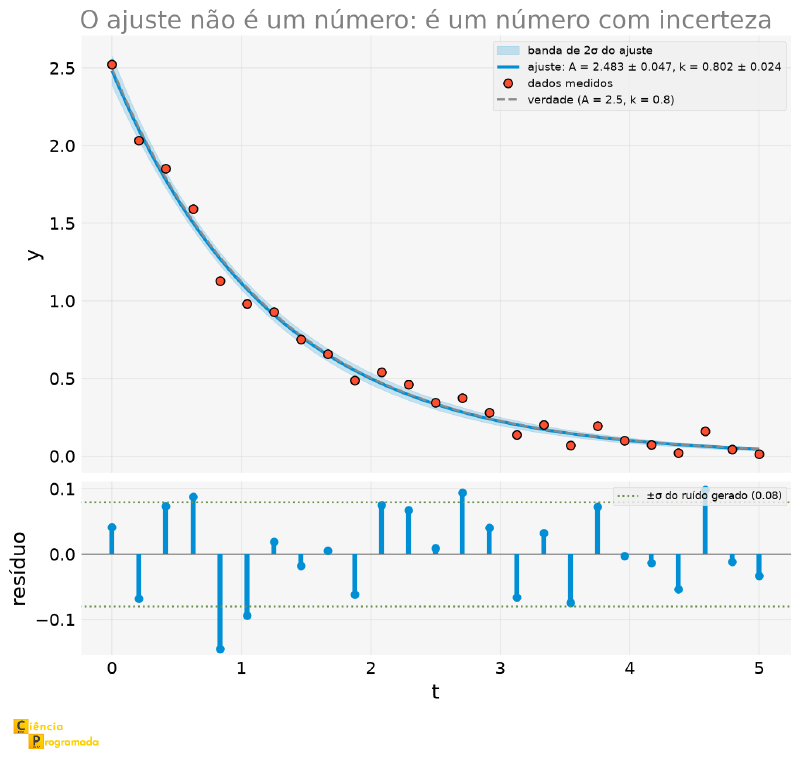
Vale a checagem de consistência: o desvio padrão dos resíduos dá \(0{,}0675\), contra o \(\sigma = 0{,}08\) que foi usado para gerar o ruído. Próximos, como devem ser. Um desvio residual muito menor que o ruído conhecido seria sinal de superajuste; muito maior, sinal de modelo errado.
Três Coisas Que Dão Errado #
1. O Chute Inicial Importa, e Falha em Silêncio #
O p0 do curve_fit é o mesmo chute inicial que o
artigo de raízes
e o de otimização discutiram: o ponto de onde a busca parte. E como a soma
dos quadrados de um modelo não-linear pode ter vários mínimos locais, o
chute decide para qual deles se converge.
Exemplo 1: Duas gaussianas e um chute infeliz
Enunciado: Um espectro tem dois picos, em \(x = 3\) e \(x = 7\). Ajuste a soma de duas gaussianas partindo de dois chutes iniciais diferentes.
Solução:
import numpy as np
from scipy.optimize import curve_fit

rng = np.random.default_rng(42)
rng.normal(0, 0.08, 25)  # os 25 ruídos de y_dados, sorteados antes com a mesma semente


def modelo_dois_picos(x, A1, c1, A2, c2):
    return A1 * np.exp(-((x - c1) ** 2) / 0.2) + A2 * np.exp(-((x - c2) ** 2) / 0.2)


x_picos = np.linspace(0, 10, 120)
y_picos = modelo_dois_picos(x_picos, 3.0, 3.0, 1.5, 7.0) + rng.normal(0, 0.05, x_picos.size)

for p0, rotulo in (([1, 2.5, 1, 7.5], "p0 razoável"),
                   ([1, 5.0, 1, 5.0], "p0 ruim (os dois picos no mesmo lugar)")):
    pp, _ = curve_fit(modelo_dois_picos, x_picos, y_picos, p0=p0, maxfev=20000)
    sq = np.sum((y_picos - modelo_dois_picos(x_picos, *pp)) ** 2)
    print(f"{rotulo:>40}: centros = {pp[1]:8.3f}, {pp[3]:8.3f}   SQ = {sq:.4f}")
p0 razoável: centros = 3.002, 6.999 SQ = 0.2239
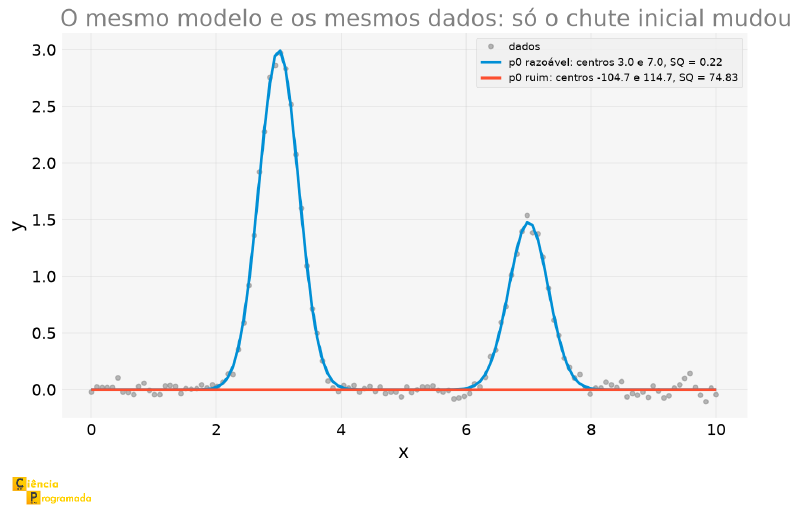
p0 ruim (os dois picos no mesmo lugar): centros = -104.687, 114.691 SQ = 74.8265O segundo ajuste colocou os centros em \(-104\) e \(+114\), muito fora
do intervalo onde existem dados. E o mais importante: não levantou
exceção nenhuma. O curve_fit retornou normalmente, com uma pcov
normal, e um usuário distraído seguiria em frente.
As duas curvas ajustadas, sobre os mesmos pontos:
A defesa é dupla: sempre passe um p0 informado (estimado a olho do
gráfico, ou de um caso-limite conhecido), e sempre confira a soma dos
quadrados final. Um valor muito maior que o esperado é o sinal de que a
busca parou num vale errado, e ele custa uma linha.
2. Nem Todo Ponto Vale o Mesmo: sigma
#
Por padrão, o curve_fit supõe que todos os pontos têm a mesma incerteza.
Isso é comum, mas está longe de universal: em muitas medições, o sinal
fraco no fim da curva é bem mais ruidoso que o forte no começo.
Quando as incertezas individuais são conhecidas, informá-las muda o resultado:
import numpy as np
from scipy.optimize import curve_fit


def modelo_exp(t, A, k):
    return A * np.exp(-k * t)


rng = np.random.default_rng(42)
t_dados = np.linspace(0, 5, 25)
y_dados = modelo_exp(t_dados, 2.5, 0.8) + rng.normal(0, 0.08, t_dados.size)
rng.normal(0, 0.05, 120)  # os 120 ruídos do espectro de dois picos (Exemplo 1)

sigmas_pt = np.linspace(0.02, 0.30, t_dados.size)   # ruído cresce ao longo da curva
y_heter = modelo_exp(t_dados, 2.5, 0.8) + rng.normal(0, sigmas_pt)

p_sem, c_sem = curve_fit(modelo_exp, t_dados, y_heter, p0=[1.0, 1.0])
p_com, c_com = curve_fit(modelo_exp, t_dados, y_heter, p0=[1.0, 1.0],
                         sigma=sigmas_pt, absolute_sigma=True)

print(f"sem sigma : A = {p_sem[0]:.4f} ± {np.sqrt(c_sem[0,0]):.4f}")
print(f"com sigma : A = {p_com[0]:.4f} ± {np.sqrt(c_com[0,0]):.4f}")
sem sigma : A = 2.4908 ± 0.1187
com sigma : A = 2.4918 ± 0.0183A estimativa central mal se mexe, mas a incerteza cai por um fator de seis e meio: ao dizer ao algoritmo quais pontos são confiáveis, ele para de diluir a informação boa com a ruim. A barra de erro menor é a barra de erro honesta: a de \(0{,}1187\) era pessimista, porque supunha que os pontos precisos eram tão ruins quanto os imprecisos.
absolute_sigma muda o significado da resposta
absolute_sigma=True: os valores emsigmasão incertezas absolutas, na unidade dos dados. Apcovsai na escala real. Use quando você conhece a incerteza da sua medição: de uma calibração, da especificação do instrumento, de réplicas.absolute_sigma=False(o padrão): os valores emsigmasão tratados como pesos relativos. Apcové reescalada pelo qui-quadrado reduzido, o que equivale a estimar a magnitude do ruído a partir da dispersão dos próprios resíduos.
A diferença é conceitual e importa na hora de reportar. Com o padrão,
você está dizendo “não sei quanto vale meu ruído, estimei dos dados”,
perfeitamente legítimo, e o que fizemos no primeiro exemplo. Com
True, você está dizendo “eu sei quanto vale, e é isto”. Se você passar
incertezas absolutas e esquecer absolute_sigma=True, o número
reportado deixa de ser o que você acha que é.
3. Modelos Superparametrizados #
O terceiro modo de falha é o mais silencioso, porque o ajuste “funciona”:
Exemplo 2: Dois parâmetros para uma única informação
Enunciado: Ajuste \(y = A \cdot B \cdot e^{-kt}\) aos mesmos dados do decaimento. O que acontece?
Solução:
import numpy as np
from scipy.optimize import curve_fit


def modelo_exp(t, A, k):
    return A * np.exp(-k * t)


rng = np.random.default_rng(42)
t_dados = np.linspace(0, 5, 25)
y_dados = modelo_exp(t_dados, 2.5, 0.8) + rng.normal(0, 0.08, t_dados.size)


def modelo_redundante(t, A, B, k):
    return A * B * np.exp(-k * t)


p_red, c_red = curve_fit(modelo_redundante, t_dados, y_dados, p0=[1.0, 1.0, 1.0])
print("parâmetros:", np.round(p_red, 4))
print("produto A·B =", round(p_red[0] * p_red[1], 4))
print("\nvariância de A:", f"{c_red[0, 0]:.3e}")
print("variância de k:", f"{c_red[2, 2]:.3e}")
parâmetros: [3.5267 0.7041 0.8022]
produto A·B = 2.4831
variância de A: 1.861e+28
variância de k: 8.195e-04Repare no contraste. O produto \(A \cdot B = 2{,}4831\) é exatamente o mesmo \(A\) do primeiro ajuste, e \(k\) saiu igual com uma variância minúscula. Esses dois são perfeitamente determinados.
Mas a variância de \(A\) sozinho é \(1{,}9 \times 10^{28}\), um desvio padrão da ordem de \(10^{14}\). O algoritmo está dizendo, com todas as letras: este parâmetro não é determinável a partir destes dados. E não é mesmo: qualquer par \((A, B)\) com o produto certo ajusta igualmente bem. Não há informação nos dados que separe os dois.
pcov antes de reportar qualquer parâmetro
Variâncias absurdamente grandes ou inf na diagonal costumam indicar um
problema mal condicionado, como um modelo superparametrizado para os
dados disponíveis: parâmetros que não são identificáveis separadamente, ou
dados insuficientes para separá-los.
A saída certa não é numérica. É reparametrizar o modelo (aqui,
trocar \(A \cdot B\) por um único parâmetro) ou medir mais, numa
faixa que separe o que hoje está confundido. Aumentar maxfev ou trocar
de algoritmo não resolve: o problema não é de convergência, é de falta
de informação.
Aplicação: Energia de Ativação, e uma Surpresa #
A equação de Arrhenius apareceu no artigo de otimização aplicada com \(E_a\) e \(A_0\) dados. No laboratório é o contrário: mede-se \(k\) em várias temperaturas, e os parâmetros são o que se quer descobrir.
$$ k(T) = A_0 e^{-E_a/(RT)} $$Há duas rotas óbvias, e o folclore diz que uma é melhor. A rota clássica, anterior aos computadores, é linearizar: tomando o logaritmo,
$$ \ln k = \ln A_0 - \frac{E_a}{R}\cdot\frac{1}{T} $$que é uma reta em \(1/T\), ajustável com régua e papel milimetrado. A rota moderna é ajustar o modelo não-linear direto, sem transformar nada.
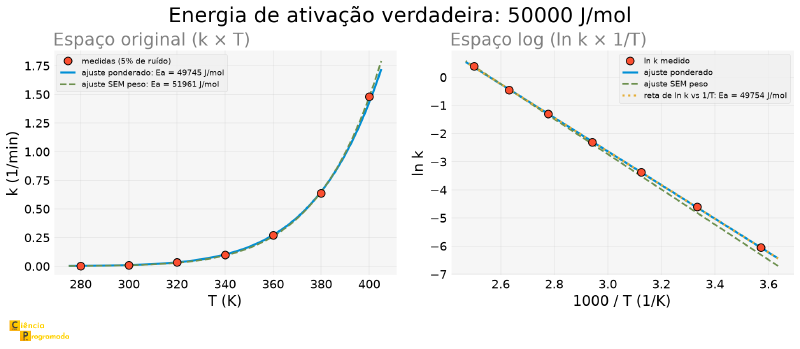
Montei este exemplo esperando mostrar que a linearização é pior. A medição mostrou o contrário, e a explicação é mais interessante que a tese que eu queria defender:
import numpy as np
from scipy.optimize import curve_fit

R_GAS = 8.314
T_medidas = np.array([280.0, 300.0, 320.0, 340.0, 360.0, 380.0, 400.0])
k_limpo = 5e6 * np.exp(-50000.0 / (R_GAS * T_medidas))
rng_arr = np.random.default_rng(7)
k_medido = k_limpo * (1 + rng_arr.normal(0, 0.05, T_medidas.size))   # ruído de 5%


def arrhenius(T, A0, Ea):
    return A0 * np.exp(-Ea / (R_GAS * T))


p_sp, c_sp = curve_fit(arrhenius, T_medidas, k_medido, p0=[1e6, 4e4], maxfev=20000)
p_cp, c_cp = curve_fit(arrhenius, T_medidas, k_medido, p0=[1e6, 4e4],
                       sigma=0.05 * k_medido, absolute_sigma=True, maxfev=20000)
coef_lin, cov_lin = np.polyfit(1 / T_medidas, np.log(k_medido), 1, cov=True)

rotas = (
    ("não-linear SEM peso", p_sp[1], np.sqrt(c_sp[1, 1])),
    ("não-linear COM sigma = 5% de k", p_cp[1], np.sqrt(c_cp[1, 1])),
    ("linearizado (ln k vs 1/T)", -coef_lin[0] * R_GAS, np.sqrt(cov_lin[0, 0]) * R_GAS),
)
print("Energia de ativação (verdadeira: 50000 J/mol), 7 medidas com 5% de ruído:")
print(f"{'rota':>36} {'Ea (J/mol)':>12} {'erro':>7} {'incerteza':>11}")
for rota, Ea, inc in rotas:
    print(f"{rota:>36} {Ea:>12.0f} {abs(Ea - 50000) / 50000 * 100:>6.2f}% {inc:>11.0f}")
Energia de ativação (verdadeira: 50000 J/mol), 7 medidas com 5% de ruído:
rota Ea (J/mol) erro incerteza
não-linear SEM peso 51961 3.92% 637
não-linear COM sigma = 5% de k 49745 0.51% 444
linearizado (ln k vs 1/T) 49754 0.49% 213O ajuste não-linear sem peso é o pior dos três, errando por \(3{,}9\%\). O linearizado, supostamente ultrapassado, erra \(0{,}49\%\). E o não-linear ponderado erra \(0{,}51\%\), empatando com ele.
O que decide qual rota é correta é como o erro se distribui, e não a rota.
Aqui o ruído é multiplicativo: \(5\%\) do valor de \(k\). Como \(k\) varia por três ordens de grandeza ao longo da faixa de temperatura, o erro absoluto dos pontos de \(T\) alta é enorme comparado ao dos de \(T\) baixa. O ajuste não-linear sem peso minimiza resíduos absolutos, e portanto deixa os poucos pontos de \(T\) alta ditarem quase tudo.
E o logaritmo? Ruído multiplicativo vira ruído aditivo e de variância constante depois do \(\ln\), que é exatamente a hipótese sob a qual mínimos quadrados sem peso é o estimador correto. Linearizar aqui não é um atalho histórico: é a ponderação certa, obtida de graça.
A regra prática, então:
- Erro absoluto constante (a balança erra \(0{,}1\) mg, não importa a massa) → ajuste o modelo direto, sem transformar.
- Erro relativo constante (o instrumento erra \(5\%\) da leitura)
→ ou ajuste em escala log, ou passe
sigmaproporcional aos valores.
Os dois caminhos da segunda linha dão o mesmo resultado, como a tabela mostra. O que não dá certo é ignorar a questão.
Os dois espaços lado a lado tornam o mecanismo visível:
Aplicação: Michaelis-Menten, e Quando Linearizar É Desastre #
O exemplo anterior poderia sugerir que linearizar é sempre seguro. Não é, e o contraexemplo é o mais famoso da bioquímica.
A cinética enzimática de Michaelis-Menten relaciona a velocidade de reação \(v\) à concentração de substrato \([S]\):
$$ v = \frac{V_{max}[S]}{K_m + [S]} $$A linearização clássica é a de Lineweaver-Burk, de 1934, que inverte os dois lados:
$$ \frac{1}{v} = \frac{K_m}{V_{max}}\cdot\frac{1}{[S]} + \frac{1}{V_{max}} $$Uma reta em \(1/[S]\), cujo coeficiente linear dá \(1/V_{max}\) e cuja inclinação dá \(K_m/V_{max}\). Gerações de bioquímicos extraíram parâmetros assim, e o gráfico de duplo-recíproco continua em todo livro-texto.
Vamos comparar as duas rotas. Primeiro, com uma única simulação de ensaio:
import numpy as np
from scipy.optimize import curve_fit

S_medido = np.array([0.05, 0.08, 0.12, 0.20, 0.35, 0.60, 1.00, 1.80, 3.00, 5.00])  # mmol/L


def michaelis_menten(S, Vmax, Km):
    return Vmax * S / (Km + S)


def lineweaver_burk(S, v):
    """Ajusta 1/v contra 1/S por mínimos quadrados e desfaz a transformação."""
    coef = np.polyfit(1 / S, 1 / v, 1)
    Vmax = 1 / coef[1]
    return Vmax, coef[0] * Vmax


rng_mm = np.random.default_rng(42)
v_medido = michaelis_menten(S_medido, 2.0, 0.5) + rng_mm.normal(0, 0.04, S_medido.size)

p_mm, c_mm = curve_fit(michaelis_menten, S_medido, v_medido, p0=[1.0, 1.0])
inc_mm = np.sqrt(np.diag(c_mm))
Vmax_lb, Km_lb = lineweaver_burk(S_medido, v_medido)

print("UMA realização (semente 42):")
print(f"  verdade          : Vmax = {2.0:.4f}   Km = {0.5:.4f}")
print(f"  não-linear direto: Vmax = {p_mm[0]:.4f} ± {inc_mm[0]:.4f}"
      f"   Km = {p_mm[1]:.4f} ± {inc_mm[1]:.4f}")
print(f"  Lineweaver-Burk  : Vmax = {Vmax_lb:.4f}   Km = {Km_lb:.4f}")
UMA realização (semente 42):
verdade : Vmax = 2.0000 Km = 0.5000
não-linear direto: Vmax = 1.9868 ± 0.0369 Km = 0.5139 ± 0.0308
Lineweaver-Burk : Vmax = 1.8538 Km = 0.4562Lineweaver-Burk erra mais, mas não escandalosamente: \(7\%\) em \(V_{max}\). Alguém poderia concluir que a crítica é exagerada.
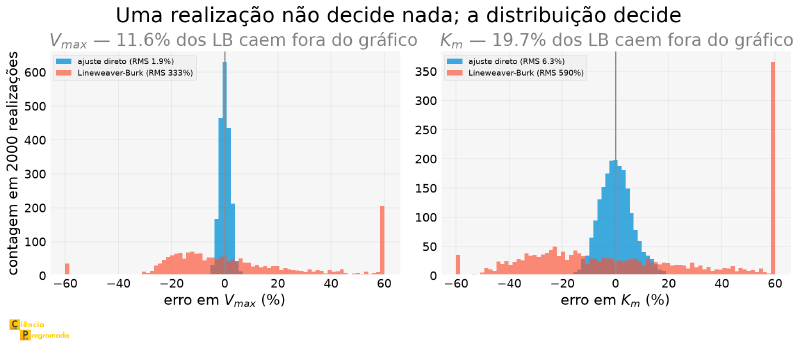
Não conclua nada daqui, porque uma realização não decide nada. Esse é um sorteio entre infinitos possíveis, e o que interessa é como o método se comporta em média. A pergunta certa é: se eu repetisse este ensaio duas mil vezes, como ficariam os erros?
import numpy as np
from scipy.optimize import curve_fit

S_medido = np.array([0.05, 0.08, 0.12, 0.20, 0.35, 0.60, 1.00, 1.80, 3.00, 5.00])  # mmol/L


def michaelis_menten(S, Vmax, Km):
    return Vmax * S / (Km + S)


def lineweaver_burk(S, v):
    """Ajusta 1/v contra 1/S por mínimos quadrados e desfaz a transformação."""
    coef = np.polyfit(1 / S, 1 / v, 1)
    Vmax = 1 / coef[1]
    return Vmax, coef[0] * Vmax


N_REPLICAS = 2000
rng_mc = np.random.default_rng(0)
res_nl, res_lb = [], []
for _ in range(N_REPLICAS):
    v = michaelis_menten(S_medido, 2.0, 0.5) + rng_mc.normal(0, 0.04, S_medido.size)
    if np.any(v <= 0.02):        # 1/v explodiria; descartado dos DOIS métodos
        continue
    pp, _ = curve_fit(michaelis_menten, S_medido, v, p0=[1.0, 1.0], maxfev=20000)
    res_nl.append(pp)
    res_lb.append(lineweaver_burk(S_medido, v))
res_nl, res_lb = np.array(res_nl), np.array(res_lb)

print(f"{len(res_nl)} realizações do mesmo ensaio:")
print(f"{'parâmetro':>10} {'rota':>18} {'RMS do erro':>13} {'viés médio':>12}")
for i, (nome, verd) in enumerate((("Vmax", 2.0), ("Km", 0.5))):
    for rot, arr in (("não-linear", res_nl), ("Lineweaver-Burk", res_lb)):
        rms = np.sqrt(np.mean((arr[:, i] - verd) ** 2)) / verd * 100
        print(f"{nome:>10} {rot:>18} {rms:>12.2f}% {np.mean(arr[:, i]) - verd:>+12.4f}")
2000 realizações do mesmo ensaio:
parâmetro rota RMS do erro viés médio
Vmax não-linear 1.90% +0.0019
Vmax Lineweaver-Burk 333.13% +0.1687
Km não-linear 6.27% +0.0016
Km Lineweaver-Burk 589.92% +0.0810Agora sim. O erro quadrático médio de Lineweaver-Burk é de 333% em \(V_{max}\) e 590% em \(K_m\), contra \(1{,}9\%\) e \(6{,}3\%\) do ajuste direto. E há viés: o ajuste direto é praticamente não-viesado (\(+0{,}002\) num valor de \(2{,}0\)), enquanto Lineweaver-Burk superestima \(V_{max}\) sistematicamente em \(+0{,}17\).
A distribuição dos erros mostra de onde vêm esses números:
Por Que a Inversão Estraga #
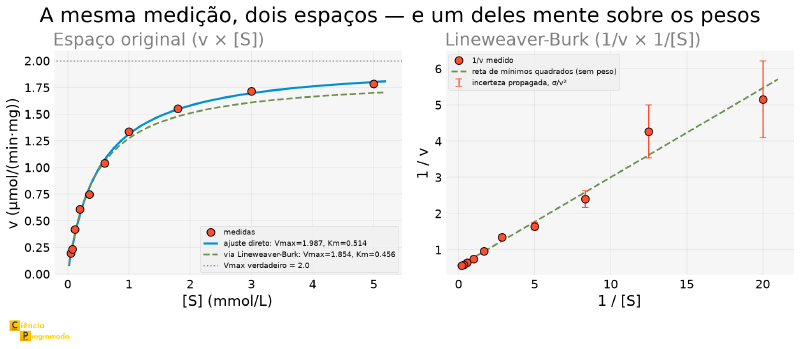
A causa é mecânica, e a tabela de pesos a expõe. O ruído do ensaio é absoluto: \(\sigma_v = 0{,}04\) em qualquer ponto. Mas propagando esse erro pela transformação \(1/v\):
$$ \sigma_{1/v} \approx \frac{\sigma_v}{v^2} $$O erro de cada ponto transformado é inversamente proporcional ao quadrado de \(v\). E os pontos de \([S]\) baixo, que têm \(v\) pequeno, são justamente os que ganham o maior \(1/[S]\), ou seja, os que mais alavancam a inclinação da reta:
| \([S]\) | \(v\) | \(1/[S]\) | \(\sigma_{1/v}\) | Peso relativo correto |
|---|---|---|---|---|
| 0,05 | 0,194 | 20,00 | 1,063 | 0,0001 |
| 0,12 | 0,417 | 8,33 | 0,230 | 0,0030 |
| 0,60 | 1,039 | 1,67 | 0,037 | 0,1150 |
| 1,80 | 1,553 | 0,56 | 0,017 | 0,5735 |
| 5,00 | 1,784 | 0,20 | 0,013 | 1,0000 |
A incerteza em \(1/v\) varia por um fator de 85 entre o melhor e o pior ponto. O ponto de \([S]=0{,}05\) deveria contar cerca de dez mil vezes menos que o de \([S]=5\). E o ajuste de reta sem peso trata os dois como igualmente confiáveis.
Pior: no espaço original, esse ponto ruim é apenas um ponto ruim. No espaço recíproco, ele é o ponto mais distante da origem, o de maior alavancagem sobre a inclinação. A transformação pegou o dado menos confiável e o promoveu a mais influente.
É o que a figura a seguir mostra, com as barras de erro propagadas:
O gráfico de Lineweaver-Burk continua útil como ferramenta de diagnóstico visual, porque é nele que os padrões de inibição enzimática (competitiva, não-competitiva, incompetitiva) se distinguem de relance pelo que muda: inclinação, intercepto, ou ambos.
O que não se deve mais fazer é extrair os parâmetros dele. A linearização foi uma necessidade histórica, de quando ajustar um modelo não-linear exigia iteração manual. Hoje custa uma linha, e a alternativa introduz erros de centenas de por cento.
A regra geral: transformar os dados transforma também os erros. Antes de ajustar em qualquer espaço que não seja o da medição, pergunte o que aconteceu com a incerteza de cada ponto naquela transformação. Se ela deixou de ser uniforme, ou você pondera, ou ajusta no espaço original.
Tabela-Resumo #
| Ferramenta | Uso | Observação |
|---|---|---|
curve_fit(f, x, y, p0=...) |
Ajuste não-linear por mínimos quadrados | Devolve (popt, pcov); é minimize sobre a soma dos quadrados |
np.sqrt(np.diag(pcov)) |
Incerteza (1σ) de cada parâmetro | Sem isso, o resultado não é um resultado científico |
pcov[i, j] |
Correlação entre parâmetros | Correlação alta = parâmetros pouco distinguíveis nesses dados |
sigma= |
Incertezas individuais conhecidas | Pode reduzir a barra de erro por um fator grande |
absolute_sigma=True |
sigma é incerteza absoluta |
O padrão (False) trata sigma como peso relativo e reescala a pcov |
bounds= |
Restringe a busca | Útil quando o parâmetro tem significado físico (concentração > 0) |
p0= |
Chute inicial | Falha em silêncio quando ruim: confira sempre a soma dos quadrados final |
| Conceito | Observação |
|---|---|
| Ajustar é minimizar | curve_fit e minimize sobre \(\sum(y - f)^2\) dão o mesmo resultado |
Variância enorme na pcov |
Modelo superparametrizado: o parâmetro não é identificável nesses dados |
| Modelo de ruído | Erro absoluto → ajuste direto; erro relativo → escala log ou sigma proporcional |
| Linearizar | Transforma os dados e os erros. Ótimo para ver; ruim para ajustar |
| Uma realização não decide | Comparar métodos de ajuste exige repetir o experimento e olhar a distribuição |
| Resíduos | Devem ficar da ordem do ruído conhecido, e sem padrão |
Próximos Passos #
Este artigo fecha o bloco de otimização da série: dos fundamentos do
minimize, passando pelas aplicações com restrições, até o caso particular
mais comum de todos, o de ajustar um modelo a dados medidos, com incerteza.
O que vem a seguir muda de eixo. Todos os métodos vistos até aqui, do cálculo de raízes ao ajuste, trabalham no espaço em que a medida foi feita: concentração contra tempo, velocidade contra temperatura, \(y\) contra \(x\). O próximo artigo faz uma pergunta diferente: e se o espaço mais natural para olhar esse sinal não for o do tempo, mas o das frequências que o compõem? A resposta é a transformada de Fourier, e ela reorganiza tudo o que se sabe sobre um sinal medido.