Em 1959, o matemático inglês James H. Wilkinson investigava por que algoritmos de busca de raízes, considerados corretos no papel, se comportavam mal nos primeiros computadores digitais. Para testar uma hipótese, ele construiu um polinômio propositalmente inofensivo, hoje conhecido como polinômio de Wilkinson:
$$ (x-1)(x-2)(x-3)\cdots(x-20) $$Grau 20, vinte raízes inteiras, de 1 a 20, todas bem separadas umas das outras. Não existe polinômio mais “educado” que esse, ou assim parecia. Wilkinson expandiu o produto em seus 21 coeficientes e alimentou um algoritmo numérico com eles.
E esses coeficientes são monstruosos. O termo independente é \(20!\), um
inteiro de 19 dígitos; o maior de todos, o coeficiente de \(x^2\), passa
de \(1{,}38 \times 10^{19}\). Guarde esse número: o maior inteiro que um
float64 representa sem erro nenhum é \(2^{53} \approx 9 \times
10^{15}\), umas mil vezes menor. Ou seja, boa parte desses coeficientes
sequer cabe exatamente num float: o estrago começa antes de qualquer
algoritmo rodar.
O resultado deixou Wilkinson perplexo o suficiente para, décadas depois, descrever aquele momento como “a experiência mais traumática da minha carreira como analista numérico”.
O que aconteceu? Isso é o que vamos reconstruir neste artigo, com código de verdade, depois de aprender a manipular polinômios como objetos no NumPy.
Por Que Polinômios como Objetos Importam? #
- Análise numérica e computação científica: qualquer método que aproxima uma função por um polinômio (interpolação, quadratura, solvers de equações diferenciais) depende de saber que polinômios de grau alto podem amplificar erros pequenos de forma dramática, o próprio problema que Wilkinson descobriu.
- Engenharia de controle: a estabilidade de um sistema linear (elétrico, mecânico) costuma se resumir a onde estão as raízes de um polinômio característico. Saber que essas raízes podem ser sensíveis a erros de medição dos coeficientes é uma preocupação prática.
- Computação gráfica: curvas de Bézier e splines, usadas na maioria dos editores vetoriais e motores de jogos, são polinômios manipulados numericamente: avaliados, derivados, ajustados milhares de vezes por segundo.
- Processamento de sinais: filtros digitais são descritos por uma razão de polinômios (a função de transferência); a localização das raízes do polinômio do denominador (os polos) determina se o filtro é estável.
Polinômios do SymPy, Revisitados no NumPy #
No artigo Polinômios com SymPy
vimos a classe Poly, que trata um polinômio como objeto (com métodos
para coeficientes, grau, raízes, derivada e integral) em vez de uma mera
expressão simbólica. O NumPy tem seu equivalente: numpy.polynomial.Polynomial.
A diferença essencial é que aqui os coeficientes não são símbolos exatos, e
sim números de ponto flutuante (float64), o que parece um detalhe
irrelevante e, como veremos no fim deste artigo, não é.
Exemplo 1: Recriando um polinômio do artigo de SymPy
Enunciado: O artigo de SymPy usou \(Q(x) = x^2 - 25\) como exemplo
recorrente. Construa o mesmo polinômio com numpy.polynomial.Polynomial
e compare os coeficientes com os do SymPy.
Solução: Polynomial recebe os coeficientes em ordem crescente
de grau, ou seja, o primeiro elemento é o termo independente, não o de maior
grau (mais sobre isso já na próxima seção):
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
Q_sym = sympy.Poly(x**2 - 25, x)
Q_np = Polynomial([-25, 0, 1])  # -25 + 0x + 1x^2

print("SymPy all_coeffs (decrescente):", Q_sym.all_coeffs())
print("NumPy .coef (crescente):", Q_np.coef)
SymPy all_coeffs (decrescente): [1, 0, -25]
NumPy .coef (crescente): [-25. 0. 1.]Mesmo polinômio, duas ordens opostas de armazenar os coeficientes.
A Armadilha Nº 1: Ordem dos Coeficientes #
O NumPy tem, na verdade, duas formas de representar um polinômio, e nenhuma delas concorda com o SymPy:
| Representação | Ordem dos coeficientes | Exemplo para \(Q(x)=x^2-25\) |
|---|---|---|
numpy.poly1d (legado) |
Decrescente | [1, 0, -25] |
numpy.polynomial.Polynomial (moderna) |
Crescente | [-25, 0, 1] |
sympy.Poly.all_coeffs() |
Decrescente | [1, 0, -25] |
poly1d é a API antiga do NumPy: ainda funciona, mas é considerada
legado; a documentação recomenda Polynomial para código novo. O
risco está em misturá-las sem perceber, já que nenhuma convenção é a “certa”:
passar a lista de coeficientes do jeito errado para a classe errada não
gera erro nenhum e devolve um polinômio diferente, silenciosamente.
Como conferência, os dois construtores do NumPy chegam às mesmas raízes para o mesmo \(Q(x)\), apesar da ordem oposta dos coeficientes:
import numpy as np
from numpy.polynomial import Polynomial

Q_np = Polynomial([-25, 0, 1])  # -25 + 0x + 1x^2
p_legado = np.poly1d([1, 0, -25])  # decrescente
print("poly1d.roots:", p_legado.roots)
print("Polynomial.roots():", Q_np.roots())
poly1d.roots: [-5. 5.]
Polynomial.roots(): [-5. 5.]Raízes, Inclusive as Complexas #
Exemplo 2: Raízes de um polinômio de grau 3
Enunciado: O artigo de SymPy também usou \(A(x) = x^3 + 2x + 3\),
que tem uma raiz real e duas complexas. Encontre as raízes com
Polynomial.roots().
Solução:
from numpy.polynomial import Polynomial

A_np = Polynomial([3, 2, 0, 1])  # 3 + 2x + 0x^2 + 1x^3
print(A_np.roots())
[-1. +0.j 0.5-1.6583124j 0.5+1.6583124j]O SymPy precisou de dois métodos separados para isso (all_roots() para
todas as raízes, real_roots() só para as reais), porque, para o SymPy,
raiz real e raiz complexa são objetos matematicamente distintos.
Polynomial.roots() não faz essa distinção e devolve um único array numérico, real quando todas as raízes são reais e
complexo (com parte imaginária zero nas raízes reais) quando há alguma raiz
complexa, porque para o
NumPy um polinômio é, antes de tudo, um array de coeficientes numéricos,
a mesma filosofia de numpy.roots já usada em
Resolvendo Equações Numericamente com SciPy,
agora aplicada a polinômios como objetos.
Derivada, Integral e Divisão #
Exemplo 3: Derivada, integral e divisão de polinômios
Enunciado: Calcule a derivada de \(Q(x)=x^2-25\) em \(x=2\), a integral de \(Q(x)\) em \(x=1\) (constante de integração zero), e o quociente e resto da divisão de \(A(x)=x^3+2x+3\) por \(Q(x)\).
Solução:
from numpy.polynomial import Polynomial

Q_np = Polynomial([-25, 0, 1])   # -25 + x^2
A_np = Polynomial([3, 2, 0, 1])  # 3 + 2x + x^3

print("Q'(2):", Q_np.deriv()(2))
print("integral de Q até 1:", Q_np.integ()(1))

quociente, resto = divmod(A_np, Q_np)
print("quociente:", quociente)
print("resto:", resto)
Q'(2): 4.0
integral de Q até 1: -24.666666666666668
quociente: 0.0 + 1.0·x
resto: 3.0 + 27.0·xOs mesmos resultados do artigo de SymPy: \(Q^{\prime}(2)=4\), \(\int_0^1 Q dx = -\frac{74}{3} \approx -24{,}667\), e a divisão de \(A\) por \(Q\) dá quociente \(x\) e resto \(27x+3\). Como sempre em uma divisão, \(Q \cdot \text{quociente} + \text{resto} = A\).
divmod aqui é o divmod embutido do Python
divmod(A_np, Q_np) não é uma função própria do NumPy: é o divmod()
embutido da linguagem. Funciona porque Polynomial implementa o método
especial __divmod__ (junto com +, -, *, //, %, **, ==),
devolvendo dois novos objetos Polynomial (quociente e resto). A
documentação do NumPy sobre as classes de conveniência de
polinômio
lista explicitamente esses operadores sobrecarregados.
Onde Foi Parar a Exatidão do SymPy? #
No artigo de introdução ao SymPy,
os coeficientes inteiros de um polinômio eram exatos: sympy.Integer,
sem nenhum arredondamento. Aqui, Q_np.coef já é numpy.float64 desde a
construção. Para um polinômio de grau baixo como \(Q\) ou \(A\), isso
não muda nada visível. Mas, à medida que o grau cresce, a diferença entre
“exato” e “ponto flutuante” deixa de ser cosmética; é hora de voltar ao
polinômio que abriu este artigo.
De Volta ao Polinômio de Wilkinson #
O que Wilkinson descobriu tem nome, e vale defini-lo antes de reproduzir o experimento:
Um problema numérico é mal-condicionado quando uma variação minúscula nos dados de entrada produz uma variação desproporcionalmente grande na resposta, mesmo usando um algoritmo perfeitamente correto. Não é bug de código; é uma propriedade do problema em si.
Chegou a hora de reproduzir o experimento de Wilkinson, passo a passo.
Passo 1: os coeficientes exatos, com SymPy #
Primeiro, expandimos \((x-1)(x-2)\cdots(x-20)\) simbolicamente (a mesma ferramenta usada nos artigos anteriores da série) para obter os 21 coeficientes sem nenhum erro de arredondamento:
import sympy

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
poly_wilkinson_sym = sympy.Poly(expr_wilkinson, x)

coefs_dec = poly_wilkinson_sym.all_coeffs()  # decrescente, inteiros exatos
print("coeficiente de x^19:", coefs_dec[1])
print("termo constante (20!):", coefs_dec[-1])
coeficiente de x^19: -210
termo constante (20!): 2432902008176640000Repare no tamanho desses números: o termo constante já é \(20!\), um inteiro de 19 dígitos. Todos os 21 coeficientes, neste ponto, ainda são exatos.
A figura a seguir mostra a magnitude de todos eles, em escala logarítmica,
com a linha do maior inteiro que um float64 guarda sem erro nenhum:
import matplotlib.pyplot as plt
import numpy as np
import sympy

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
modulos = [abs(int(c)) for c in reversed(coefs_dec)]     # crescente, ainda exatos

graus = np.arange(21)
fig, ax = plt.subplots(figsize=(8, 5))
ax.bar(graus, [float(m) for m in modulos], color="C0")
ax.axhline(2.0**53, color="C1", linestyle="--", linewidth=2,
           label=r"$2^{53}$: maior inteiro exato em float64")
ax.set_yscale("log")
ax.set_xlabel("grau do termo")
ax.set_ylabel(r"$|$coeficiente$|$")
ax.legend()

print(f"{sum(m > 2**53 for m in modulos)} dos 21 coeficientes passam de 2^53")
10 dos 21 coeficientes passam de 2^53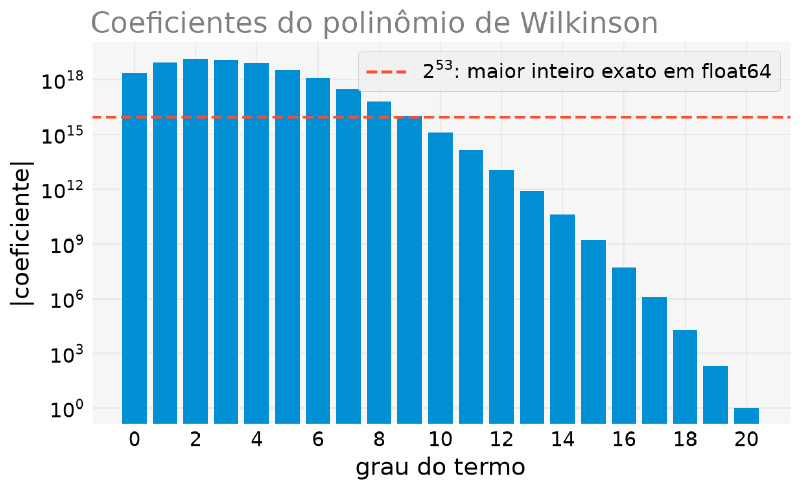
Dez dos vinte e um coeficientes estão acima da linha. Cada um deles já
chega ao float64 com erro, não por culpa de nenhum algoritmo, mas porque
o formato não comporta o número.
Passo 2: convertendo para float64, e já aparece erro
#
Agora vem a parte que qualquer Polynomial do NumPy exige: converter
esses inteiros exatos para float64. Isso, sozinho, já é uma perturbação:
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos

coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)
Com o polinômio construído, calculamos as raízes e comparamos com os valores esperados (os inteiros de 1 a 20):
import numpy as np
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

raizes = W.roots()
erro_max = np.max(np.abs(np.sort(raizes.real) - np.arange(1, 21)))
print(f"erro máximo, sem nenhuma perturbação deliberada: {erro_max:.4f}")
print("raízes calculadas para os valores esperados 14 e 15:")
print(np.sort_complex(raizes)[13:15])
erro máximo, sem nenhuma perturbação deliberada: 0.5185
raízes calculadas para os valores esperados 14 e 15:
[14.518475-0.20853241j 14.518475+0.20853241j]Vale reler essa saída com atenção, porque ela é mais dramática do que parece: as raízes deixaram de ser reais. Onde deveriam estar dois números inteiros, \(14\) e \(15\), está um par de complexos conjugados, \(14{,}518 \pm 0{,}209i\).
E nada disso foi perturbado de propósito. O único “insulto” ao polinômio
foi converter seus coeficientes inteiros exatos para float64, o que é
inevitável, já que é o que qualquer Polynomial do NumPy exige.
.roots().real
É tentador escrever W.roots().real para “limpar” o resultado. Mas .real
descarta silenciosamente a parte imaginária: o par conjugado acima
vira dois valores idênticos, \(14{,}518\) e \(14{,}518\), e o leitor
conclui que as raízes apenas “colidiram”. A informação mais importante,
que elas saíram do eixo real, some sem aviso.
Quando quiser só as raízes reais de verdade, filtre em vez de truncar:
raizes[np.abs(raizes.imag) < tol].real.
Para medir o quão frágil isso é, vale uma experiência que não perturba nada
de propósito: construir o mesmo polinômio por dois caminhos diferentes.
Um é o que acabamos de usar (expandir com SymPy, converter para float64);
o outro é o Polynomial.fromroots, que multiplica os fatores diretamente em
ponto flutuante.
import numpy as np
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

W_via_sympy = W
W_via_fromroots = Polynomial.fromroots(np.arange(1, 21))

print("os coeficientes são iguais?", np.allclose(W_via_sympy.coef, W_via_fromroots.coef))
print("maior diferença relativa:",
      np.max(np.abs(W_via_sympy.coef - W_via_fromroots.coef) /
             np.maximum(np.abs(W_via_sympy.coef), 1)))
print()
print("raízes 14/15, via SymPy    :", np.sort_complex(W_via_sympy.roots())[13:15])
print("raízes 14/15, via fromroots:", np.sort_complex(W_via_fromroots.roots())[13:15])
os coeficientes são iguais? True
maior diferença relativa: 1.5911824568028567e-16
raízes 14/15, via SymPy : [14.518475-0.20853241j 14.518475+0.20853241j]
raízes 14/15, via fromroots: [14.51819694-0.20459637j 14.51819694+0.20459637j]Leia esses números com calma. Os coeficientes dos dois polinômios diferem, no máximo, em
\(1{,}6\times10^{-16}\) relativo, ou seja, em um único bit do
último dígito do float64. É a menor diferença que existe entre dois
números diferentes nessa representação; menos que isso, seriam idênticos.
E as raízes diferem na quarta casa decimal: a parte imaginária vai de \(0{,}2085\) para \(0{,}2046\), quase \(2\%\).
Nenhum dos dois caminhos está errado, e nenhum algoritmo falhou. Simplesmente
não existe, em float64, uma resposta “a” para a pergunta “quais são as
raízes desse polinômio”: a pergunta é sensível demais para o formato em que
ela foi feita. É esse fenômeno que tem nome, e é o que vamos perturbar de
propósito a seguir para medir.
Passo 3: a perturbação clássica de Wilkinson #
Agora, deliberadamente, diminuímos um único coeficiente, o de \(x^{19}\), que vale exatamente \(-210\), em apenas \(2^{-23} \approx 1{,}19\times10^{-7}\). Esse expoente é o épsilon de máquina da precisão simples, o formato de 32 bits com 23 bits de mantissa que detalhamos no artigo sobre IEEE 754. É um erro menor que o de qualquer medição experimental razoável.
import numpy as np
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

coefs_perturbados = np.array(coefs_wilkinson, dtype=float)
coefs_perturbados[19] -= 2**-23
W_perturbado = Polynomial(coefs_perturbados)
Passo 4: o que aconteceu com as raízes #
Com o polinômio perturbado construído, recalculamos as raízes e comparamos com as originais:
import numpy as np
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

coefs_perturbados = np.array(coefs_wilkinson, dtype=float)
coefs_perturbados[19] -= 2**-23
W_perturbado = Polynomial(coefs_perturbados)

raizes_perturbadas = W_perturbado.roots()
max_parte_imaginaria = np.max(np.abs(raizes_perturbadas.imag))
raizes_reais = raizes_perturbadas[np.abs(raizes_perturbadas.imag) < 1e-6].real
raiz_que_era_20 = raizes_reais[np.argmin(np.abs(raizes_reais - 20))]

print(f"maior parte imaginária surgida: {max_parte_imaginaria:.4f}")
print(f"raiz que era 20 virou: {raiz_que_era_20:.4f}")
maior parte imaginária surgida: 2.8127
raiz que era 20 virou: 20.8469Dez das vinte raízes deixam de ser reais. A raiz que era exatamente 20 sobe para \(\approx 20{,}85\), um desvio de \(4{,}2\%\) causado por uma perturbação de \(10^{-7}\) em um único coeficiente, entre vinte.
Passo 5: visualizando a dispersão das raízes #
O gráfico a seguir coloca lado a lado as raízes originais, todas reais (círculos, alinhadas no eixo x), e as raízes perturbadas, espalhadas pelo plano complexo (x):
import matplotlib.pyplot as plt
import numpy as np
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

coefs_perturbados = np.array(coefs_wilkinson, dtype=float)
coefs_perturbados[19] -= 2**-23
raizes_perturbadas = Polynomial(coefs_perturbados).roots()

fig, ax = plt.subplots(figsize=(8, 7))
ax.scatter(
    np.arange(1, 21), np.zeros(20),
    label="raízes teóricas (inteiros 1 a 20)", zorder=3, s=60,
)
ax.scatter(
    raizes_perturbadas.real, raizes_perturbadas.imag,
    marker="x", label="raízes após perturbar 1 coeficiente em $2^{-23}$",
    zorder=3, s=60,
)
ax.axhline(0, color="black", linewidth=0.8, zorder=1)
ax.set_xlabel("Parte real")
ax.set_ylabel("Parte imaginária")
ax.set_title("Sensibilidade das raízes do polinômio de Wilkinson", pad=12)
ax.legend(loc="upper center", bbox_to_anchor=(0.5, -0.12), ncol=1)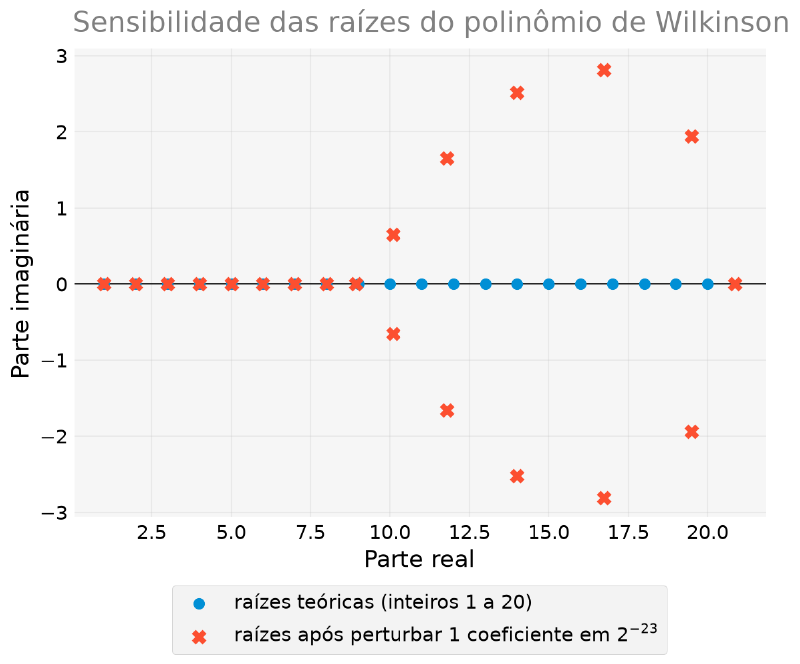
Isso é o que Wilkinson viu em 1959, e o motivo de sua reação não ter sido exagero.
Por Que Isso Acontece #
Até aqui o artigo mostrou que acontece. Falta o porquê, e ele cabe numa fórmula.
Perturbe o coeficiente \(a_k\) de uma quantidade pequena \(\delta\). Cada raiz \(x_j\) se desloca, em primeira ordem, de:
$$ \frac{\partial x_j}{\partial a_k} = -\frac{x_j^{k}}{p'(x_j)} $$A dedução é curta: se \(p(x_j) = 0\) e perturbamos \(a_k\), a nova raiz satisfaz \(p(x_j + \Delta) + \delta (x_j+\Delta)^k = 0\). Expandindo em Taylor e ficando na primeira ordem, \(p^{\prime}(x_j)\Delta + \delta x_j^k \approx 0\), de onde sai a razão acima.
Essa fração explica tudo, porque seus dois pedaços puxam em direções opostas conforme \(j\) cresce:
- O numerador \(x_j^{19}\) explode. Para \(x_1 = 1\) vale 1; para \(x_{20} = 20\) vale \(5{,}2 \times 10^{24}\).
- O denominador \(p^{\prime}(x_j)\) despenca no meio. Como \(p^{\prime}(x_j) = \prod_{i \neq j}(x_j - x_i)\), ele é o produto das 19 distâncias de \(x_j\) às outras raízes. Nas pontas (\(j=1\) ou \(j=20\)) esse produto é \(19! \approx 10^{17}\), enorme. No meio (\(j \approx 10\)), metade das diferenças é pequena e o produto cai para \(10^{12}\).
import sympy
from numpy.polynomial import Polynomial

x = sympy.Symbol("x")
expr_wilkinson = sympy.prod([x - k for k in range(1, 21)])
coefs_dec = sympy.Poly(expr_wilkinson, x).all_coeffs()  # decrescente, inteiros exatos
coefs_wilkinson = [float(c) for c in reversed(coefs_dec)]
W = Polynomial(coefs_wilkinson)

dW = W.deriv()
print(f"{'j':>3} {'|p_linha(x_j)|':>15} {'x_j^19':>12} {'sensibilidade':>15}")
for j in (1, 2, 5, 10, 16, 20):
    xj = float(j)
    print(f"{j:>3} {abs(dW(xj)):>15.2e} {xj**19:>12.2e} {abs(xj**19 / dW(xj)):>15.2e}")
j |p_linha(x_j)| x_j^19 sensibilidade
1 1.22e+17 1.00e+00 8.22e-18
2 6.40e+15 5.24e+05 8.19e-11
5 3.14e+13 1.91e+13 6.08e-01
10 1.32e+12 1.00e+19 7.60e+06
16 3.14e+13 7.56e+22 2.41e+09
20 1.22e+17 5.24e+24 4.31e+07A última coluna varia 27 ordens de grandeza. A raiz \(x_1 = 1\) é essencialmente imune (\(8{,}2 \times 10^{-18}\)); a raiz \(x_{16}\) é \(2{,}4 \times 10^{9}\) vezes mais sensível que a perturbação aplicada.
A figura a seguir mostra essa coluna inteira, uma barra por raiz:
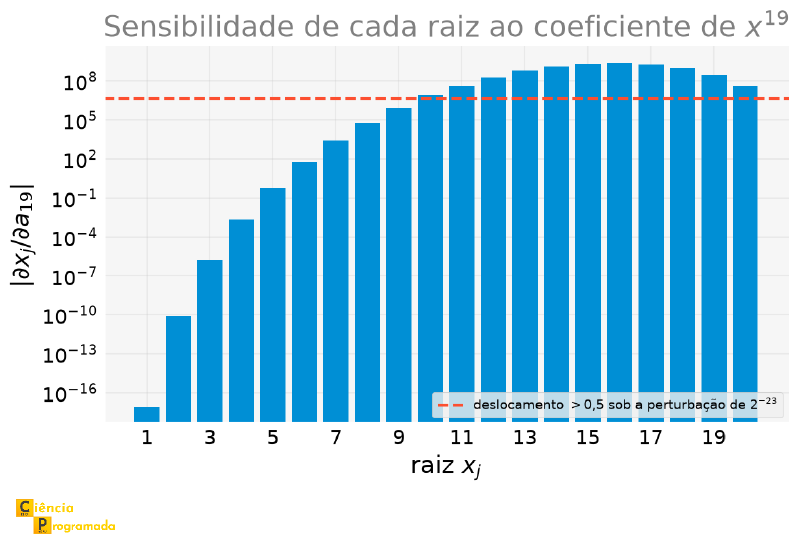
Compare essa figura com o resultado do experimento: as raízes que
sobreviveram inteiras são as pequenas, e as que viraram pares complexos são
as do meio-para-cima. A figura previu quais quebrariam, antes de rodar o
roots().
A distinção é a moral do artigo. O
numpy.roots calcula os autovalores da matriz companheira com um
algoritmo estável em sentido de norma (backward stable): o resultado que
ele devolve é a resposta exata de um problema muito próximo do que você
passou. Ele não erra: ele responde com precisão a uma pergunta ligeiramente
diferente da sua.
Em problemas bem-condicionados, isso basta: resposta exata de um problema próximo é uma resposta próxima. No polinômio de Wilkinson, não basta, porque “próximo nos coeficientes” e “próximo nas raízes” deixam de ser a mesma coisa. Trocar de algoritmo não ajudaria; o problema está na pergunta, não em quem responde.
Não é Só Proximidade: Multiplicidade Também #
Poderia parecer que o problema é ter raízes “próximas demais”. O extremo oposto mostra que não:
import numpy as np
from numpy.polynomial import Polynomial

P_mult = Polynomial.fromroots(np.ones(20))   # (x-1)^20
raizes_mult = P_mult.roots()
print(f"raio do espalhamento em torno de 1: {np.max(np.abs(raizes_mult - 1)):.4f}")
print("quantas deixaram de ser reais:", int((np.abs(raizes_mult.imag) > 1e-8).sum()))
raio do espalhamento em torno de 1: 0.4352
quantas deixaram de ser reais: 18\((x-1)^{20}\) tem uma raiz, repetida 20 vezes. O roots() devolve 20
valores espalhados num círculo de raio \(0{,}44\) em torno de 1, e 18 deles
nem são reais. Faz sentido pela mesma fórmula: numa raiz múltipla,
\(p^{\prime}(x_j) = 0\) exatamente, e a sensibilidade é infinita.
A Lição Prática #
Raízes de grau alto parecem impossíveis de domar, mas a fórmula sugere o contrário. Ela aponta o culpado, e o culpado é evitável:
A perda acontece no momento em que os fatores \((x-1)(x-2)\cdots\) viram uma lista de coeficientes. Antes disso, as raízes estavam escritas na cara. Regras práticas:
- Mantenha a forma fatorada sempre que ela existir.
Polynomial.fromrootseroots()são operações inversas, mas o caminho de ida perde informação. - Prefira outra base. A base de potências \(1, x, x^2, \ldots\) é péssima em intervalos longe da origem. O próximo artigo mostra que o mesmo polinômio, escrito na base de Chebyshev com o domínio mapeado para \([1, 20]\), fica milhões de vezes menos sensível.
- Se o problema vier de uma matriz (autovalores, estabilidade de sistemas), resolva a matriz diretamente em vez de montar e resolver o polinômio característico. O caminho pelo polinômio destrói condicionamento de graça.
Ou seja: o mal-condicionamento de Wilkinson não é uma propriedade do conjunto de raízes \(\{1, \ldots, 20\}\). É uma propriedade de representá-lo como lista de coeficientes na base de potências.
Tabela-Resumo #
| Operação | Sintaxe | Observação |
|---|---|---|
| Construção | Polynomial([c0, c1, ..., cn]) |
Ordem crescente de grau |
| Construção (legado) | numpy.poly1d([cn, ..., c1, c0]) |
Ordem decrescente, evitar em código novo |
| Raízes | .roots() |
Array real se todas as raízes são reais; complexo se houver alguma complexa |
| Derivada | .deriv() |
Retorna outro Polynomial |
| Integral | .integ() |
Constante de integração zero por padrão |
| Divisão | divmod(A, B) |
Retorna (quociente, resto) |
| Coeficientes exatos | Não existe | Todo coeficiente é float64; mal-condicionado em grau alto (Wilkinson) |
Próximos Passos #
Este artigo cobriu polinômios como objetos já conhecidos, construídos a
partir de coeficientes ou raízes que já tínhamos de antemão. Mas a maior
parte dos dados do mundo real não vem com um polinômio anexado: vem como
uma nuvem de pontos experimentais, com ruído, e cabe a nós encontrar
o polinômio que melhor descreve esses pontos. O SymPy não faz isso: não
existe regressão simbólica. No próximo artigo,
usamos Polynomial.fit() para ajustar curvas a dados reais de química,
física e engenharia, e vemos por que grau alto nem sempre é ajuste
melhor: o fenômeno de Runge, uma espécie de primo do mal-condicionamento
de Wilkinson, mas para interpolação em vez de raízes.