Uma química calibrando um espectrofotômetro faz o procedimento de sempre: prepara soluções de concentração conhecida, mede a absorbância de cada uma, anota os pares (concentração, absorbância). Ao final, tem uma sequência de pontos espalhados num gráfico, não uma fórmula. A Lei de Beer-Lambert promete uma relação linear entre concentração e absorbância, mas nenhum ponto medido cai exatamente sobre reta nenhuma: há ruído de instrumento, impurezas, variação de temperatura. A pergunta prática é sempre a mesma: qual reta (ou curva) melhor descreve esses pontos, e o quanto posso confiar nela?
Isso não é um problema de encontrar uma raiz, nem de manipular um polinômio que já se conhece. É o problema oposto: dados os pontos, encontrar o polinômio. O SymPy, com toda sua força simbólica, não tem resposta para isso: não existe regressão simbólica. É aqui que o NumPy entra.
Por Que Ajustar Curvas Importa? #
- Instrumentação científica: todo instrumento de medição (de espectrofotômetros a balanças de precisão) precisa de uma curva de calibração, obtida ajustando um modelo a pontos conhecidos.
- Engenharia de materiais e estruturas: propriedades mecânicas como módulo de elasticidade, dureza ou resistência à fadiga vêm de ajustar curvas a dados de ensaios físicos, quase sempre ruidosos.
- Física experimental: recuperar uma grandeza (aceleração, constante de decaimento, frequência) a partir de medições diretas é, quase sempre, um problema de ajuste de curva.
- Ciência de dados e aprendizado de máquina: regressão polinomial é o exemplo mais simples de um princípio central em todo machine learning, o de ajustar um modelo a dados observados e avaliar o quanto ele generaliza, em vez de apenas memorizar os pontos.
Ajustando um Polinômio a Dados #
No artigo anterior
vimos numpy.polynomial.Polynomial como objeto: construção, raízes,
derivada, integral, divisão, sempre a partir de coeficientes que já
tínhamos. Agora vamos na direção oposta: partir de pontos experimentais e
encontrar o polinômio.
Exemplo 1: Calibrando um espectrofotômetro
Enunciado: Uma química mede a absorbância de 8 soluções de concentração conhecida, entre 0 e 5 mmol/L. Ajuste uma reta (absorbância em função da concentração) aos dados medidos.
Solução:
import numpy as np
from numpy.polynomial import Polynomial

c_calibracao = np.linspace(0, 5, 8)   # 8 soluções entre 0 e 5 mmol/L
A_calibracao = np.array([0.0012, 0.1377, 0.2847, 0.4233, 0.5478,
                         0.6844, 0.8224, 0.9511])

p_calibracao = Polynomial.fit(c_calibracao, A_calibracao, deg=1)
print(p_calibracao)
print("domínio:", p_calibracao.domain)
0.481575 + 0.47485·(-1.0 + 0.4x)
domínio: [0. 5.]Repare que p_calibracao não imprime coeficientes reconhecíveis à
primeira vista. Polynomial.fit() reescala x internamente, por padrão, para o
intervalo \([-1, 1]\), o atributo .domain guarda o intervalo
original (aqui, \([0, 5]\), a faixa dos dados). É a origem mais comum
de confusão de quem tenta comparar esses coeficientes com um cálculo
manual: eles não estão na escala de \(c\) em mmol/L, estão na escala
reescalada. Para obter os coeficientes na base natural, use .convert():
import numpy as np
from numpy.polynomial import Polynomial

c_calibracao = np.linspace(0, 5, 8)   # 8 soluções entre 0 e 5 mmol/L
A_calibracao = np.array([0.0012, 0.1377, 0.2847, 0.4233, 0.5478,
                         0.6844, 0.8224, 0.9511])

p_calibracao = Polynomial.fit(c_calibracao, A_calibracao, deg=1)

coefs_naturais = p_calibracao.convert().coef
print("[intercepto, inclinação]:", coefs_naturais)
[intercepto, inclinação]: [0.006725 0.18994 ]A inclinação ajustada, \(0{,}190\), está próxima do valor usado para gerar os dados, \(0{,}20\); a diferença vem do ruído de medição.
Um detalhe de nomenclatura que costuma passar batido: a Lei de Beer-Lambert é \(A = \varepsilon \ell c\), então a inclinação da reta não é a absortividade molar \(\varepsilon\) sozinha, e sim o produto \(\varepsilon \ell\), a absortividade vezes o caminho óptico da cubeta. Aqui os dois coincidem numericamente porque \(\ell = 1\) cm, o padrão de laboratório; com uma cubeta de outro tamanho, deixariam de coincidir.
Os resíduos (a diferença entre cada ponto medido e o valor previsto pela reta) mostram o quão bem o ajuste descreve os dados:
import numpy as np
from numpy.polynomial import Polynomial

c_calibracao = np.linspace(0, 5, 8)   # 8 soluções entre 0 e 5 mmol/L
A_calibracao = np.array([0.0012, 0.1377, 0.2847, 0.4233, 0.5478,
                         0.6844, 0.8224, 0.9511])

p_calibracao = Polynomial.fit(c_calibracao, A_calibracao, deg=1)

residuos = A_calibracao - p_calibracao(c_calibracao)
print("resíduo máximo:", np.max(np.abs(residuos)))
resíduo máximo: 0.009560714285714145Um resíduo máximo de \(0{,}0096\) numa escala de absorbância que vai até \(\approx 1\) é um ajuste razoável para dados com ruído.
Mas o número sozinho diz pouco. O que um analista de verdade olha é o gráfico desses resíduos, a ferramenta de diagnóstico mais barata que existe em ajuste de curvas:
import matplotlib.pyplot as plt
import numpy as np
from numpy.polynomial import Polynomial

c_calibracao = np.linspace(0, 5, 8)   # 8 soluções entre 0 e 5 mmol/L
A_calibracao = np.array([0.0012, 0.1377, 0.2847, 0.4233, 0.5478,
                         0.6844, 0.8224, 0.9511])

p_calibracao = Polynomial.fit(c_calibracao, A_calibracao, deg=1)

residuos = A_calibracao - p_calibracao(c_calibracao)

fig, ax = plt.subplots(figsize=(8, 4.2))
ax.axhline(0, color="gray", linewidth=1.2, zorder=1)
ax.stem(c_calibracao, residuos, basefmt=" ")
ax.set_xlabel("concentração (mmol/L)")
ax.set_ylabel("resíduo (medido − ajustado)")

print("sinais:", "".join("+" if r > 0 else "-" for r in residuos))
sinais: --++--+-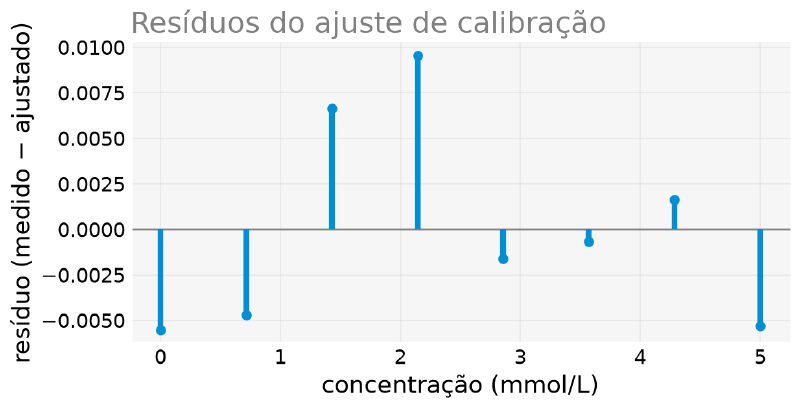
A pergunta não é “os resíduos são pequenos?”, e sim “eles têm estrutura?”.
- Sem padrão, alternando de sinal ao acaso, como aqui
(
--++--+-): o modelo capturou a forma dos dados, e o que sobrou é ruído. É o que se quer ver. - Padrão em U ou em arco (todos negativos nas pontas e positivos no meio, ou o contrário): o modelo tem a forma errada, porque falta curvatura. É o sinal clássico de que um grau 1 deveria ser grau 2.
- Leque abrindo: a incerteza da medição cresce com \(x\), e o ajuste deveria ser ponderado.
Aqui não há estrutura, e é isso que torna o exemplo interessante: a curvatura existe (a relação real satura), mas dentro de 0 a 5 mmol/L ela é menor que o ruído do instrumento. Nenhum diagnóstico estatístico conseguiria detectá-la com esses dados, e é exatamente por isso que o desastre da extrapolação, na próxima seção, é invisível a partir da calibração. O ajuste não tem como avisar sobre um regime que ele nunca viu.
Polynomial.fit() tem uma versão legada, como poly1d
Assim como numpy.poly1d é a construção legada de
numpy.polynomial.Polynomial (visto no
artigo anterior),
numpy.polyfit é a versão legada de Polynomial.fit(): recebe os
mesmos dados, mas devolve só um array de coeficientes em ordem
decrescente, não um objeto Polynomial com .domain embutido. Prefira
Polynomial.fit() em código novo, pelo mesmo motivo do artigo
anterior.
Por Que Extrapolar é Perigoso #
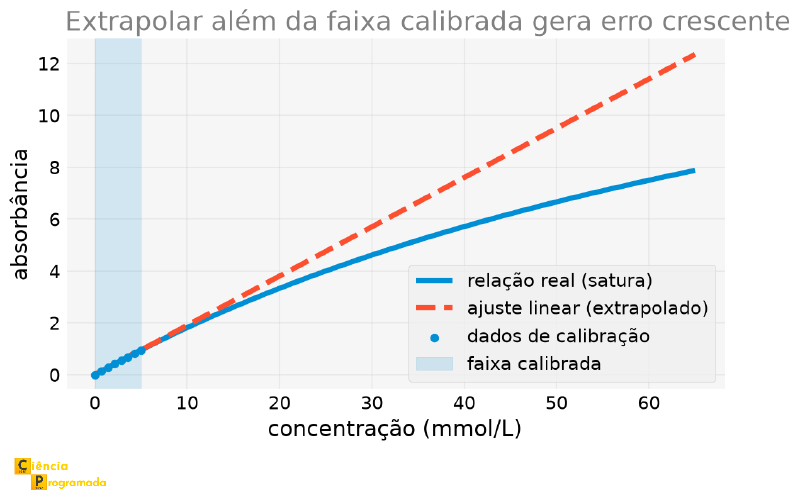
A química calibrou o instrumento entre 0 e 5 mmol/L. O que acontece se usarmos essa mesma reta para prever a absorbância de uma solução bem mais concentrada? Para responder, preciso “trapacear”: como os dados acima foram simulados, conheço a relação real por trás deles, algo que, com dados de verdade, jamais saberíamos de antemão. Uso essa relação real só para medir o erro da extrapolação, não para o ajuste em si:
import numpy as np
from numpy.polynomial import Polynomial

c_calibracao = np.linspace(0, 5, 8)   # 8 soluções entre 0 e 5 mmol/L
A_calibracao = np.array([0.0012, 0.1377, 0.2847, 0.4233, 0.5478,
                         0.6844, 0.8224, 0.9511])

p_calibracao = Polynomial.fit(c_calibracao, A_calibracao, deg=1)


def absorbancia_real(c):
    return 0.20 * c / (1 + 0.01 * c)  # relação "verdadeira" (desconhecida na prática)


for c_fora in [10, 30, 60]:
    previsto = p_calibracao(c_fora)
    real = absorbancia_real(c_fora)
    erro_pct = 100 * (previsto - real) / real
    print(f"c={c_fora} mmol/L: previsto={previsto:.3f}, real={real:.3f}, erro={erro_pct:.1f}%")
c=10 mmol/L: previsto=1.906, real=1.818, erro=4.8%
c=30 mmol/L: previsto=5.705, real=4.615, erro=23.6%
c=60 mmol/L: previsto=11.403, real=7.500, erro=52.0%Espectrofotômetros reais deixam de responder linearmente em concentrações altas, por vários motivos ao mesmo tempo: luz espúria no detector, associação entre moléculas do analito, largura de banda finita do monocromador. A curva de saturação usada aqui, \(A = \varepsilon c/(1 + \alpha c)\), é um substituto genérico para esse conjunto de efeitos, não o modelo exato de nenhum deles. O que importa para o argumento é só a forma: a resposta real satura, e a reta ajustada não tem como saber disso, porque só “viu” dados até 5 mmol/L. A 10 mmol/L (o dobro da faixa calibrada), o erro já é \(4{,}8\%\); a 60 mmol/L, chega a \(52\%\). Um ajuste é uma afirmação sobre os dados observados, não uma lei universal: vale só dentro da faixa medida.
O gráfico a seguir mostra a reta ajustada (linha tracejada), a relação real com saturação (linha cheia) e os pontos de calibração, com a faixa calibrada destacada:
Quando Grau Alto é um Problema: O Fenômeno de Runge #
Uma tentação natural é achar que, se um polinômio de grau 1 ajusta bem, um de grau mais alto ajusta melhor ainda, afinal, tem mais parâmetros livres para se adaptar aos dados. Para expor por que essa intuição falha, vamos usar a função clássica que o matemático alemão Carl Runge usou para demonstrar o problema, em 1901: \(f(x) = 1/(1+25x^2)\).
O artigo sobre o recorde de Usain Bolt já mencionou esse fenômeno de passagem, ao escolher splines (polinômios de baixo grau, um por trecho) em vez de um único polinômio de grau alto para interpolar a posição do atleta ao longo do tempo. Aqui, reproduzimos o fenômeno de propósito.
import numpy as np
from numpy.polynomial import Polynomial

def f_runge(x):
    return 1 / (1 + 25 * x**2)


n_pontos = 15
x_nos = np.linspace(-1, 1, n_pontos)
y_nos = f_runge(x_nos)
p_interp = Polynomial.fit(x_nos, y_nos, deg=n_pontos - 1)
Com 15 pontos igualmente espaçados, o polinômio interpolador tem grau 14: passa exatamente por cada ponto. Vamos comparar com a função real numa malha bem mais fina:
import numpy as np
from numpy.polynomial import Polynomial

def f_runge(x):
    return 1 / (1 + 25 * x**2)


x_fino = np.linspace(-1, 1, 2000)
y_real = f_runge(x_fino)

n_pontos = 15
x_nos = np.linspace(-1, 1, n_pontos)
p_interp = Polynomial.fit(x_nos, f_runge(x_nos), deg=n_pontos - 1)

erro_interp = np.abs(p_interp(x_fino) - y_real)
idx_pior = np.argmax(erro_interp)
print(f"maior erro da interpolação de grau {n_pontos - 1}: {erro_interp[idx_pior]:.4f}")
maior erro da interpolação de grau 14: 7.1949Um erro máximo de \(7{,}19\), numa função que varia só entre 0 e 1! O polinômio passa exatamente pelos 15 pontos usados para construí-lo, mas entre eles, perto das bordas do intervalo, ele oscila e diverge. Agora comparamos com uma regressão de grau bem mais baixo, usando muito mais pontos (mas sem exigir que o polinômio passe exatamente por cada um):
import numpy as np
from numpy.polynomial import Polynomial

def f_runge(x):
    return 1 / (1 + 25 * x**2)


x_fino = np.linspace(-1, 1, 2000)
y_real = f_runge(x_fino)

x_muitos = np.linspace(-1, 1, 200)
y_muitos = f_runge(x_muitos)
p_regressao = Polynomial.fit(x_muitos, y_muitos, deg=6)

erro_regressao = np.abs(p_regressao(x_fino) - y_real)
print(f"maior erro da regressão de grau 6: {np.max(erro_regressao):.4f}")
maior erro da regressão de grau 6: 0.2240Erro máximo de \(0{,}22\), mais de 30 vezes menor, com um polinômio de grau menor.
A conclusão parece óbvia: grau alto é o vilão. Mas é a conclusão errada, e o contraexemplo cabe no mesmo gráfico.
O Culpado é Onde os Nós Ficam #
Repare que a comparação acima mudou três coisas ao mesmo tempo: o grau (14 → 6), o método (interpolação exata → mínimos quadrados) e a quantidade de pontos (15 → 200). Com três variáveis mudando juntas, não dá para saber qual delas produziu a melhora.
Vamos isolar. Mantendo o grau em exatamente 14, o método em interpolação exata e a quantidade em exatamente 15 pontos, mudando só onde esses 15 pontos ficam. Em vez de igualmente espaçados, usamos os nós de Chebyshev.
Os \(n\) nós de Chebyshev no intervalo \([-1, 1]\) são
$$x_k = \cos\left(\frac{2k+1}{2n}\pi\right), \qquad k = 0, 1, \ldots, n-1$$ou, num intervalo \([a,b]\) qualquer, deslocando e reescalando:
$$x_k = \frac{a+b}{2} + \frac{b-a}{2}\cos\left(\frac{2k+1}{2n}\pi\right)$$São exatamente as raízes do polinômio de Chebyshev de grau \(n\), a mesma família que aparece mais adiante neste artigo, agora do outro lado: lá como base de representação, aqui como posições de amostragem.
A fórmula fica muito mais clara na sua construção geométrica: distribua \(n\) pontos igualmente espaçados por ângulo sobre um semicírculo e projete cada um verticalmente sobre o diâmetro. O cosseno na fórmula é literalmente essa projeção.
O efeito dessa projeção é o que interessa. Perto do topo do arco, a curva é quase horizontal: andar um passo angular move bastante a projeção. Perto das pontas, a curva é quase vertical: o mesmo passo angular move a projeção bem mais devagar ao longo do eixo, e os pontos se acumulam ali. A figura a seguir mostra a construção, com os nós igualmente espaçados desenhados embaixo para comparação:
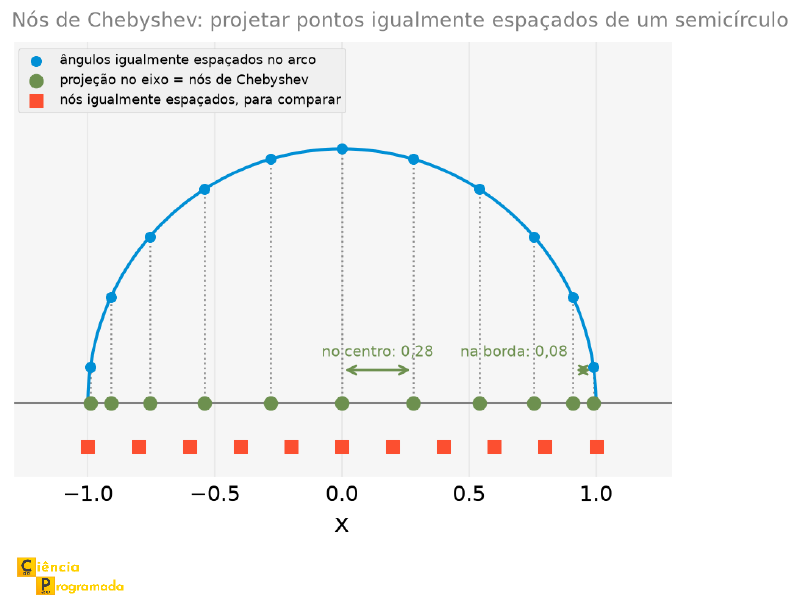
Com \(11\) nós, a distância entre vizinhos cai de \(0{,}28\) no centro para \(0{,}08\) na borda: um adensamento de \(3{,}5\) vezes exatamente onde a interpolação equiespaçada fracassava. Em código:
import numpy as np
from numpy.polynomial import Polynomial

def f_runge(x):
    return 1 / (1 + 25 * x**2)


x_fino = np.linspace(-1, 1, 2000)
y_real = f_runge(x_fino)


def nos_chebyshev(n, a=-1.0, b=1.0):
    """Os n nós de Chebyshev em [a, b] — adensam-se perto das bordas."""
    k = np.arange(n)
    return 0.5 * (a + b) + 0.5 * (b - a) * np.cos((2 * k + 1) * np.pi / (2 * n))


n_pontos = 15
x_cheb = nos_chebyshev(n_pontos)
p_cheb_nos = Polynomial.fit(x_cheb, f_runge(x_cheb), deg=n_pontos - 1)
print(f"mesmo grau 14, nós de Chebyshev: {np.max(np.abs(p_cheb_nos(x_fino) - y_real)):.4f}")
mesmo grau 14, nós de Chebyshev: 0.0466De \(7{,}19\) para \(0{,}047\), 150 vezes menor, sem baixar o grau em nada. É até 5 vezes melhor que a regressão de grau 6 que acabamos de elogiar. E, se aumentarmos o grau, fica ainda melhor:
import numpy as np
from numpy.polynomial import Polynomial

def f_runge(x):
    return 1 / (1 + 25 * x**2)


x_fino = np.linspace(-1, 1, 2000)
y_real = f_runge(x_fino)


def nos_chebyshev(n, a=-1.0, b=1.0):
    """Os n nós de Chebyshev em [a, b] — adensam-se perto das bordas."""
    k = np.arange(n)
    return 0.5 * (a + b) + 0.5 * (b - a) * np.cos((2 * k + 1) * np.pi / (2 * n))


for n in (15, 21, 31):
    xe, xc = np.linspace(-1, 1, n), nos_chebyshev(n)
    ee = np.max(np.abs(Polynomial.fit(xe, f_runge(xe), deg=n - 1)(x_fino) - y_real))
    ec = np.max(np.abs(Polynomial.fit(xc, f_runge(xc), deg=n - 1)(x_fino) - y_real))
    print(f"n={n:3d} (grau {n-1:3d}): equiespaçado={ee:10.4f}   Chebyshev={ec:9.5f}")
n= 15 (grau 14): equiespaçado= 7.1949 Chebyshev= 0.04660
n= 21 (grau 20): equiespaçado= 59.8223 Chebyshev= 0.01533
n= 31 (grau 30): equiespaçado= 2388.2632 Chebyshev= 0.00206Duas colunas, dois comportamentos opostos. Com nós igualmente espaçados, subir o grau é catastrófico: o erro explode de 7 para 2388. Com nós de Chebyshev, nesta função, subir o grau melhora monotonicamente, e o grau 30 chega a um erro de \(0{,}002\). O gráfico a seguir mostra os três casos lado a lado:
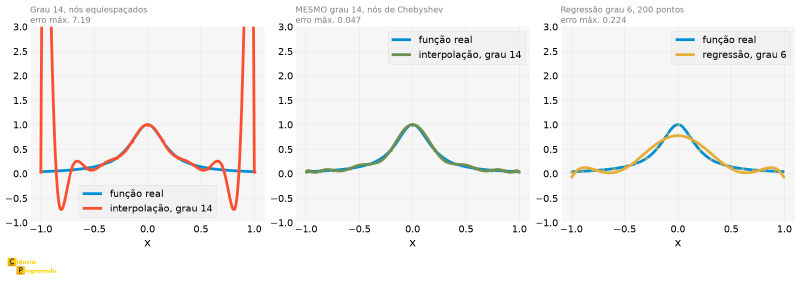
É comum ouvir “polinômio de grau alto oscila” como se fosse uma propriedade inevitável. O fenômeno de Runge é o que acontece quando se interpola em pontos igualmente espaçados: nas bordas do intervalo, os polinômios da base ficam grandes demais, e, para a função de Runge, o erro cresce exponencialmente com o grau.
Os nós de Chebyshev, que são as projeções de pontos igualmente espaçados num semicírculo, e por isso se acumulam nas pontas, minimizam esse efeito. É por isso que eles aparecem em quadraturas e métodos espectrais.
Fica, então, uma lição em duas partes:
- Se você escolhe onde amostrar (uma simulação, uma função que dá para avaliar em qualquer ponto), não tenha medo do grau alto: só não amostre em pontos igualmente espaçados.
- Se os pontos vêm dados (medições de laboratório, quase sempre igualmente espaçadas e com ruído), aí sim prefira um polinômio de grau baixo por mínimos quadrados. Não porque grau alto oscile por natureza, mas porque interpolar exatamente pontos ruidosos em malha uniforme junta os dois problemas de uma vez.
A figura a seguir fecha o argumento varrendo o grau de 4 a 30, com as duas escolhas de nós:
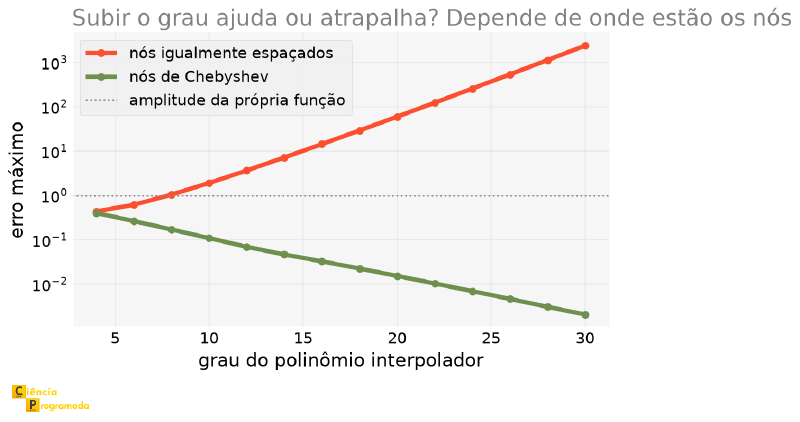
Duas curvas, direções opostas, mesma função e mesmo grau em cada ponto. A linha pontilhada marca a amplitude da própria função: acima dela, o “interpolador” já não guarda relação nenhuma com o que deveria aproximar.
Se você estender essa varredura, vai encontrar um RankWarning do NumPy e
números que param de fazer sentido: no grau 40, o erro equiespaçado
aparece menor que no grau 30. Não é melhora: é o próprio ajuste por
mínimos quadrados que ficou mal-condicionado, pelo mesmo motivo do
polinômio de Wilkinson do
artigo anterior. A
matriz de Vandermonde com potências até \(x^{40}\) tem colunas quase
paralelas, e a solução deixa de ser confiável. Por isso o gráfico para em 30.
E Quando Não Dá Para Escolher os Nós? #
A saída de Chebyshev pressupõe que você escolhe onde amostrar, o que é verdade numa simulação, e falso num laboratório. Dados experimentais vêm na malha que o instrumento produziu, quase sempre uniforme.
Nesse caso a saída não é mudar os nós; é mudar a família de interpoladores. Em vez de um polinômio único de grau alto, vários polinômios de grau baixo (um por trecho) colados com continuidade: uma spline.
import numpy as np
from numpy.polynomial import Polynomial

from scipy.interpolate import CubicSpline, PchipInterpolator


def f_runge(x):
    return 1 / (1 + 25 * x**2)


x_fino = np.linspace(-1, 1, 2000)
y_real = f_runge(x_fino)

x_nos = np.linspace(-1, 1, 15)
y_nos = f_runge(x_nos)
p_interp = Polynomial.fit(x_nos, y_nos, deg=14)

spline_cubica = CubicSpline(x_nos, y_nos)      # os MESMOS 15 nós equiespaçados
spline_pchip = PchipInterpolator(x_nos, y_nos)

for nome, interp in (("polinômio de grau 14", p_interp),
                     ("CubicSpline", spline_cubica),
                     ("PchipInterpolator", spline_pchip)):
    print(f"{nome:>22}: erro máximo = {np.max(np.abs(interp(x_fino) - y_real)):.4f}")
polinômio de grau 14: erro máximo = 7.1949
CubicSpline: erro máximo = 0.0025
PchipInterpolator: erro máximo = 0.0170Os mesmos 15 pontos, a mesma malha uniforme, e o erro cai de \(7{,}19\) para \(0{,}0025\). É quase três mil vezes melhor, e ainda melhor que os nós de Chebyshev do mesmo tamanho (\(0{,}047\)).
A figura a seguir sobrepõe as duas interpolações à função real:
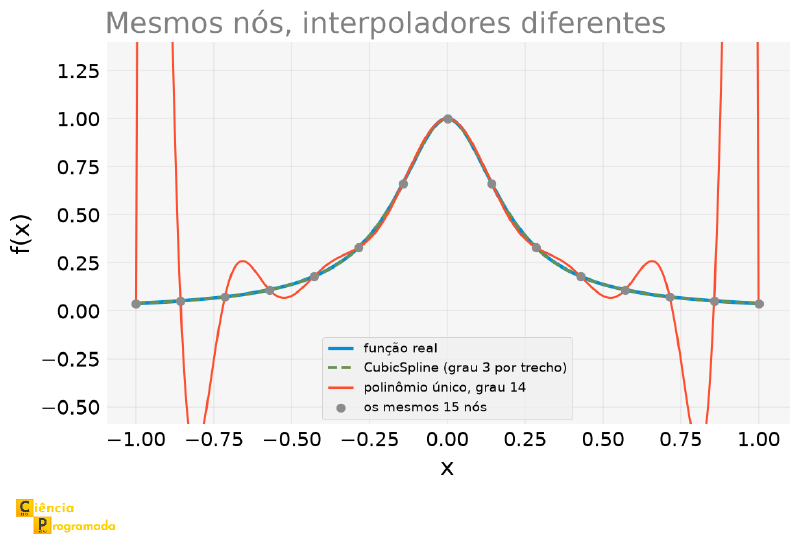
A razão é simples: cada pedaço da spline é um polinômio de grau 3, e grau 3
não tem margem para oscilar. O preço é que a spline não é uma fórmula única,
é uma tabela de pedaços, e sua derivada de ordem alta não é contínua. A
PchipInterpolator paga um pouco mais de erro em troca de uma garantia
extra: ela preserva monotonicidade, ou seja, não inventa vales e picos
onde os dados não têm. Em dados de calibração, isso costuma valer mais que
os dígitos a mais.
O artigo sobre o recorde de Usain Bolt
usou exatamente CubicSpline para interpolar a posição do atleta entre as
marcas de 10 m, e derivá-la para obter a velocidade. Agora dá para dizer
por quê: os splits vêm em malha fixa de 10 em 10 metros, sem opção de
escolher os nós, e um polinômio único de grau 10 sobre eles produziria
exatamente o desastre da figura acima.
Fica, então, uma lição em três partes:
- Se você escolhe onde amostrar, não tenha medo do grau alto: só não amostre em pontos igualmente espaçados.
- Se os nós vêm dados e você quer passar por todos, use splines.
- Se os dados têm ruído, não passe por todos: ajuste um polinômio de grau baixo por mínimos quadrados. Interpolar exatamente pontos ruidosos é interpolar o ruído.
É o terceiro caso que domina o resto deste artigo, já que estamos falando de dados experimentais.
Física: Recuperando a Aceleração da Gravidade #
Exemplo 2: Queda livre
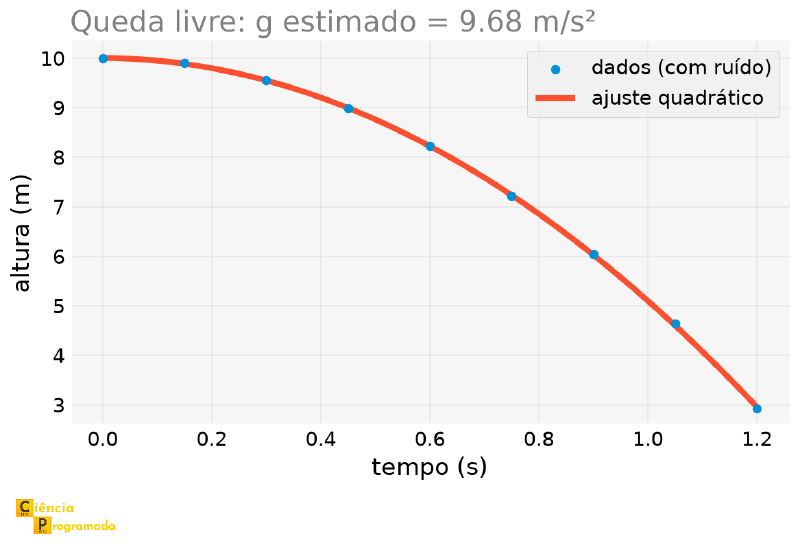
Enunciado: Um objeto é solto de \(10\) m de altura. Sua posição é medida em 9 instantes entre \(0\) e \(1{,}2\) s, com ruído de medição. Ajuste um polinômio de grau 2 e recupere a aceleração da gravidade.
Solução: A posição em queda livre segue \(y(t) = y_0 + v_0 t - \frac{1}{2}g t^2\), um polinômio de grau 2 em \(t\). O coeficiente do termo quadrático é \(-g/2\):
import numpy as np
from numpy.polynomial import Polynomial

t_dados = np.array([0., 0.15, 0.3, 0.45, 0.6, 0.75, 0.9, 1.05, 1.2])
y_dados = np.array([10.0, 9.8987, 9.5508, 8.9810, 8.2224,
                    7.2140, 6.0328, 4.6380, 2.9292])  # metros, com ruído

p_queda = Polynomial.fit(t_dados, y_dados, deg=2)
coefs_queda = p_queda.convert().coef
g_estimado = -2 * coefs_queda[2]
print(f"g estimado: {g_estimado:.3f} m/s²")
g estimado: 9.683 m/s²O valor real usado para gerar os dados foi \(9{,}8\) m/s², um erro de \(-1{,}2\%\), inteiramente explicado pelo ruído de medição.
O gráfico a seguir mostra os nove pontos medidos e a parábola ajustada passando entre eles. Repare que a curva não passa exatamente por ponto nenhum, e é justamente por isso que ela consegue estimar \(g\) melhor do que qualquer par isolado de medições conseguiria:
Engenharia: Módulo de Elasticidade e os Limites do Ajuste #
Exemplo 3: Módulo de elasticidade de um aço
Enunciado: Um ensaio de tração mede tensão em função de deformação para um corpo de prova de aço estrutural. O material tem módulo de elasticidade real \(E = 200\) GPa e, neste modelo simplificado, deixa de ser linear em \(0{,}2\%\) de deformação. Ajuste uma reta aos dados e recupere \(E\): primeiro usando só a região elástica, depois usando todos os dados do ensaio, incluindo pontos além do escoamento.
Solução:
import numpy as np
from numpy.polynomial import Polynomial

# deformação abaixo do escoamento (0.2%), tensão em MPa, com ruído
deformacao_elastica = np.array([0., 0.000286, 0.000571, 0.000857,
                                0.001143, 0.001429, 0.001714, 0.002])
tensao_elastica = np.array([7.3, 44.9, 118.0, 171.7,
                            233.9, 287.3, 350.1, 400.1])

p_elastico = Polynomial.fit(deformacao_elastica, tensao_elastica, deg=1)
E_correto = p_elastico.convert().coef[1]

# deformação até 1%, incluindo pontos além do escoamento
deformacao_completa = np.linspace(0, 0.01, 15)
tensao_completa = np.array([-2.1, 145.2, 287.4, 398.9, 400.7, 406.0,
                            407.4, 404.0, 406.0, 401.6, 417.0, 410.8,
                            418.5, 416.2, 423.8])

p_completo = Polynomial.fit(deformacao_completa, tensao_completa, deg=1)
E_errado = p_completo.convert().coef[1]

print(f"E (só região elástica): {E_correto:.0f} MPa")
print(f"E (incluindo região plástica): {E_errado:.0f} MPa")
E (só região elástica): 201902 MPa
E (incluindo região plástica): 26746 MPaUsando só a região elástica, o ajuste erra por \(1{,}0\%\) (\(201{.}902\) MPa contra os \(200{.}000\) MPa reais), um erro compatível com o ruído de \(4\) MPa das medições, e não com um defeito do método. Incluir pontos além do escoamento, onde a relação deixa de ser linear, distorce o resultado em \(-86{,}6\%\): o “módulo” ajustado, \(27\) GPa, não descreve nada físico de verdade.
A comparação entre os dois erros é o ponto: \(1\%\) é a incerteza honesta de medir \(E\) com esses dados; \(87\%\) é o resultado de ajustar o modelo errado. As duas coisas não estão na mesma escala, e nenhum refinamento estatístico salva a segunda.
O gráfico a seguir deixa o estrago visível: a reta ajustada só à região elástica acompanha o trecho inicial de perto, enquanto a ajustada a todos os pontos fica achatada e não descreve nem a região elástica, nem a plástica:
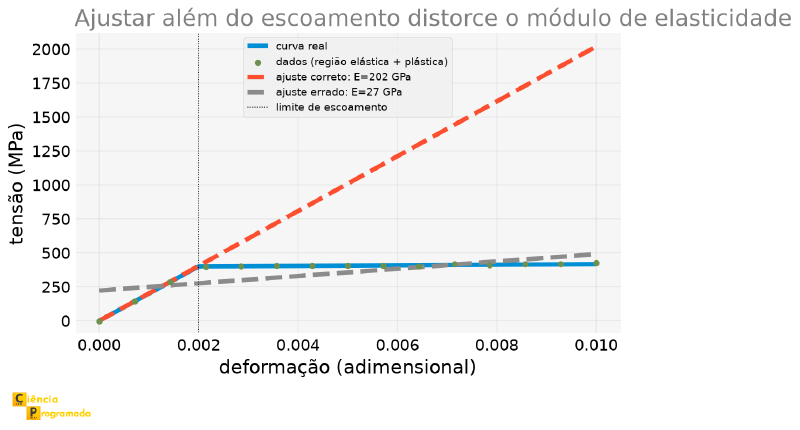
Cuidado com uma coincidência numérica: em ensaios reais, a tensão de escoamento de um aço costuma ser definida pelo método do offset de 0,2%, em que se traça uma reta paralela ao trecho elástico, deslocada de \(0{,}002\) de deformação, e o escoamento é onde ela cruza a curva medida. Isso é um procedimento de medição, não uma propriedade.
Aqui, \(0{,}002\) é outra coisa: é simplesmente a deformação em que o modelo bilinear sintético troca de inclinação. Os dois números coincidem porque ambos vêm da mesma ordem de grandeza típica do aço, mas não são o mesmo conceito.
Essa é a mesma lição da extrapolação com a Lei de Beer-Lambert, só que invertida: lá, o problema era usar o ajuste fora da faixa em que os dados foram medidos; aqui, o problema é incluir, no próprio ajuste, dados de um regime físico diferente (a região plástica) do que o modelo linear pretende descrever. Nos dois casos, a raiz é a mesma: um ajuste só é confiável dentro do regime que ele efetivamente modela.
Outras Bases: Polinômios Ortogonais #
Todos os ajustes deste artigo usaram a base “natural” de potências (\(1, x, x^2, x^3, \ldots\)), que é a que Polynomial usa por padrão.
Mas não é a única base possível, e o numpy.polynomial inclui famílias
inteiras de polinômios ortogonais prontas: Legendre, Chebyshev, Hermite,
Laguerre.
Uma família de polinômios \(P_0, P_1, P_2, \ldots\) é ortogonal num intervalo \([a, b]\) quando, para quaisquer dois polinômios diferentes da família, a integral do produto entre eles é zero: \(\int_a^b P_m(x) P_n(x) w(x) dx = 0\) para \(m \neq n\), onde \(w(x)\) é uma função peso própria de cada família (para Legendre, \(w(x) = 1\), no intervalo \([-1, 1]\)). É o mesmo conceito de vetores ortogonais em álgebra linear, só que o “produto interno” entre dois polinômios é essa integral, em vez do produto escalar usual.
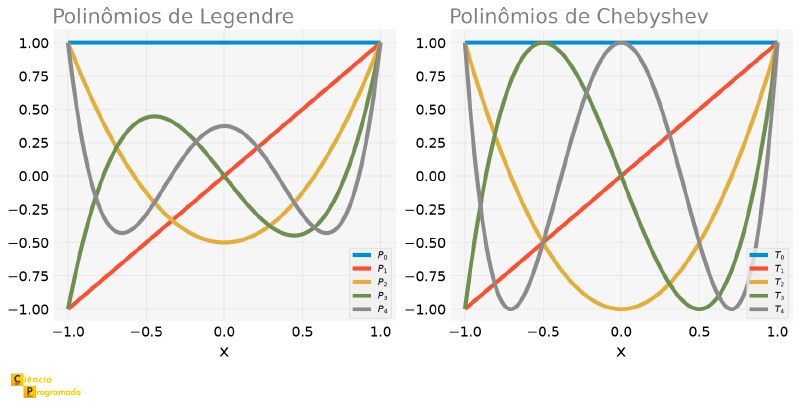
O gráfico a seguir mostra os cinco primeiros polinômios de cada família:
Podemos verificar essa propriedade numericamente, integrando dois polinômios de Legendre de grau diferente e dois do mesmo grau:
import numpy as np
from numpy.polynomial import Legendre

# np.trapezoid exige NumPy >= 2.0; em versões anteriores chamava-se np.trapz
x = np.linspace(-1, 1, 200_000)
produto_graus_diferentes = np.trapezoid(Legendre.basis(2)(x) * Legendre.basis(3)(x), x)
produto_mesmo_grau = np.trapezoid(Legendre.basis(2)(x) * Legendre.basis(2)(x), x)

print(f"integral P2*P3 (graus diferentes): {produto_graus_diferentes:.2e}")
print(f"integral P2*P2 (mesmo grau): {produto_mesmo_grau:.4f}")
integral P2*P3 (graus diferentes): 2.78e-17
integral P2*P2 (mesmo grau): 0.4000A integral entre graus diferentes é, a menos de erro de arredondamento, zero: a ortogonalidade da definição, confirmada numericamente. Entre polinômios do mesmo grau, a integral não some, e nesse caso até bate com o valor exato conhecido, \(2/5\).
Na prática, Chebyshev.fit() e Legendre.fit()
têm exatamente a mesma interface de Polynomial.fit(), e podem
substituí-lo diretamente. Refazendo o ajuste da queda livre (Exemplo 2)
com a base de Chebyshev em vez da base natural:
import numpy as np
from numpy.polynomial import Chebyshev, Polynomial

t_dados = np.array([0., 0.15, 0.3, 0.45, 0.6, 0.75, 0.9, 1.05, 1.2])
y_dados = np.array([10.0, 9.8987, 9.5508, 8.9810, 8.2224,
                    7.2140, 6.0328, 4.6380, 2.9292])  # metros, com ruído

p_cheb = Chebyshev.fit(t_dados, y_dados, deg=2)
g_via_chebyshev = -2 * p_cheb.convert(kind=Polynomial).coef[2]
print(f"g estimado (base de Chebyshev): {g_via_chebyshev:.3f} m/s²")
g estimado (base de Chebyshev): 9.683 m/s²O mesmo resultado do Exemplo 2, \(9{,}683\) m/s², como devia ser, já
que é o mesmo polinômio, só descrito numa base diferente (é por isso que
.convert(kind=Polynomial) é necessário: sem ele, os coeficientes ficam
na base de Chebyshev, não na base natural, e não têm a mesma
interpretação direta).
Resolvendo o Polinômio de Wilkinson #
A vantagem prática de bases ortogonais não é só evitar um objeto exótico. Ela ataca de frente o problema que fechou o
artigo anterior: o
polinômio de Wilkinson, \((x-1)(x-2)\cdots(x-20)\), cujas raízes
explodem com uma perturbação minúscula de \(2^{-23}\) num único
coeficiente. Reconstruindo o mesmo polinômio em base de Chebyshev, mas
agora usando o que já aprendemos sobre .domain nesta seção, mapeando o
domínio para o intervalo \([1, 20]\) das raízes, em vez do
\([-1, 1]\) padrão:
import numpy as np
from numpy.polynomial import Chebyshev, Polynomial

W_natural = Polynomial.fromroots(np.arange(1, 21))
W_cheb = Chebyshev.fromroots(np.arange(1, 21), domain=[1, 20])

print(f"maior |coeficiente|, base natural: {np.max(np.abs(W_natural.coef)):.2e}")
print(f"maior |coeficiente|, base de Chebyshev: {np.max(np.abs(W_cheb.coef)):.2e}")
maior |coeficiente|, base natural: 1.38e+19
maior |coeficiente|, base de Chebyshev: 3.12e+15A base de potências \(1, x, x^2, x^3, \ldots\) tem um defeito que
piora com o grau: seus elementos ficam cada vez mais parecidos entre
si. Em \([1, 20]\), as funções \(x^{18}\), \(x^{19}\) e
\(x^{20}\) são praticamente proporcionais: todas quase zero perto de 1
e todas astronômicas perto de 20. Uma base assim é o análogo, em espaço de
funções, de tentar descrever um plano usando dois vetores quase paralelos:
qualquer erro de arredondamento nas coordenadas produz um deslocamento
enorme no resultado. É a mesma matriz de Vandermonde mal-condicionada que
apareceu na nota sobre o RankWarning, mais acima.
Os polinômios de Chebyshev \(T_n\) são construídos para o oposto: são ortogonais entre si (com um peso apropriado) e limitados por 1 em todo o domínio, para qualquer grau. Nenhum deles se parece com outro, e nenhum domina os demais em magnitude. As coordenadas nessa base ficam, por isso, todas na mesma ordem de grandeza, e um erro relativo pequeno numa delas continua pequeno no resultado.
É a mesma ideia por trás de preferir uma base ortonormal em álgebra linear, transportada para polinômios.
Os coeficientes já nascem quase quatro ordens de grandeza menores. O teste que importa, porém, é a sensibilidade das raízes, perturbando os coeficientes de cada base pela mesma quantidade relativa:
import numpy as np
from numpy.polynomial import Chebyshev, Polynomial

W_natural = Polynomial.fromroots(np.arange(1, 21))
W_cheb = Chebyshev.fromroots(np.arange(1, 21), domain=[1, 20])

rng = np.random.default_rng(0)
perturb_rel = 1e-10

coefs_natural_pert = W_natural.coef * (1 + perturb_rel * rng.normal(size=21))
erro_natural = np.max(np.abs(
    np.sort(W_natural.roots()) - np.sort_complex(Polynomial(coefs_natural_pert).roots())
))

rng = np.random.default_rng(0)  # mesma perturbação relativa, mesma semente
coefs_cheb_pert = W_cheb.coef * (1 + perturb_rel * rng.normal(size=21))
W_cheb_pert = Chebyshev(coefs_cheb_pert, domain=W_cheb.domain, window=W_cheb.window)
erro_cheb = np.max(np.abs(np.sort(W_cheb.roots()) - np.sort_complex(W_cheb_pert.roots())))

print(f"erro máximo nas raízes, base natural: {erro_natural:.4f}")
print(f"erro máximo nas raízes, base de Chebyshev: {erro_cheb:.2e}")
erro máximo nas raízes, base natural: 4.9929
erro máximo nas raízes, base de Chebyshev: 2.32e-07Uma comparação com o artigo anterior exige cuidado, porque as duas perturbações são de naturezas diferentes. Lá, subtraímos \(2^{-23}\) de um coeficiente que vale \(-210\): uma perturbação absoluta. Aqui, multiplicamos cada coeficiente por \((1 + 10^{-10}\varepsilon)\): uma perturbação relativa. Para compará-las, é preciso pôr as duas na mesma moeda:
$$ \frac{2^{-23}}{|-210|} = 5{,}68 \times 10^{-10} $$Ou seja, em termos relativos, a perturbação de lá era apenas 5,7 vezes
maior que a daqui, não mil vezes. Ainda assim, o efeito é brutal: uma
perturbação relativa de \(10^{-10}\), da ordem do erro de arredondamento
que qualquer float64 carrega de graça, desloca as raízes em quase
\(5\) unidades na base natural.
Na base de Chebyshev, com o domínio mapeado corretamente, a mesma perturbação relativa desloca as raízes em apenas \(2{,}3 \times 10^{-7}\), um erro 21 milhões de vezes menor.
≈ 5
base natural
2,3 × 10⁻⁷
base de Chebyshev
21 milhões ×
menor
Um leitor atento pode objetar: perturbar relativamente os coeficientes das duas bases não é perturbar a mesma função. E é verdade: os coeficientes na base natural chegam a \(1{,}4\times10^{19}\), então \(10^{-10}\) relativo mexe no valor do polinômio em cerca de \(10^9\) perto de \(x=20\); na base de Chebyshev, cujos coeficientes são \(10^{15}\) e cujas funções de base são limitadas por 1 no domínio, o mesmo \(10^{-10}\) relativo mexe no valor em cerca de \(10^5\).
A comparação continua sendo a certa na prática, porque é exatamente o
erro que cada representação carrega ao ser guardada em ponto flutuante: o
float64 erra sempre um pouco em termos relativos, não absolutos. Mas a
conclusão precisa ser enunciada com cuidado: não é que o polinômio deixe
de ser sensível, e sim que a base de Chebyshev não amplifica o erro de
arredondamento do jeito que a base de potências amplifica.
Com essa ressalva: o mal-condicionamento de Wilkinson não é uma maldição do polinômio, é uma consequência de representá-lo numa base ruim para o intervalo onde as raízes vivem.
Tabela-Resumo #
| Ferramenta | Uso | Observação |
|---|---|---|
Polynomial.fit(x, y, deg) |
Ajusta um polinômio de grau deg aos dados |
Reescala x internamente; use .domain e .convert() |
numpy.polyfit |
Versão legada de Polynomial.fit() |
Devolve só coeficientes, ordem decrescente, evitar em código novo |
| Resíduos | y - p(x) |
Mede o quão bem o ajuste descreve os dados observados |
| Extrapolação | Avaliar p(x) fora da faixa de x usada no ajuste |
Sem garantia nenhuma, o ajuste só “viu” a faixa calibrada |
| Ajuste fora do regime válido | Incluir, no próprio ajuste, dados de um regime físico diferente do que o modelo descreve | Erro inverso da extrapolação: módulo de elasticidade distorcido em \(-86{,}6\%\) ao incluir a região plástica |
| Fenômeno de Runge | Interpolação exata de grau alto em pontos igualmente espaçados | Oscila perto das bordas; prefira regressão de grau baixo |
Legendre.fit(), Chebyshev.fit() |
Ajuste com bases ortogonais, mesma interface de Polynomial.fit() |
Alternativa a \(1, x, x^2, \ldots\); mesmo resultado, melhor condicionamento em grau alto |
| Polinômio de Wilkinson, resolvido | Chebyshev.fromroots() com .domain mapeado para onde as raízes vivem |
Erro nas raízes cai de \(4{,}99\) para \(2{,}3\times10^{-7}\), 21 milhões de vezes menor |
Próximos Passos #
Este artigo e o anterior
formam um par: primeiro aprendemos a manipular um polinômio já conhecido
como objeto (raízes, derivada, integral, divisão), depois aprendemos a
encontrar um polinômio a partir de dados que não vêm com fórmula
nenhuma anexada. Os dois cobrem o essencial de polinômios no NumPy, mas
deixam de fora um problema vizinho: e se o que precisamos calcular não é
um polinômio, mas a derivada de uma função que só existe como dados
discretos, sem forma fechada? No
próximo artigo,
usamos diferenças finitas e o scipy.differentiate para atacar
exatamente esse problema.