
Chegamos ao último artigo da série Por Dentro do Computador. Ao longo dos treze artigos anteriores, construímos uma compreensão completa de como um computador funciona por dentro: das portas lógicas à sua simplificação, da hierarquia de memória à cache, dos componentes da CPU ao ciclo de instrução, do pipeline aos barramentos, da representação de dados à execução de programas, e da entrada e saída que conecta tudo ao mundo externo.
Este artigo fecha o ciclo com as grandes questões arquiteturais: por que os princípios RISC venceram no projeto interno de muitos processadores modernos, por que o CISC continua relevante na interface de arquiteturas como x86, como classificar arquiteturas paralelas com a taxonomia de Flynn, e quais são os caminhos modernos para multiplicar o desempenho além dos limites de um único núcleo.
RISC: a filosofia da simplicidade #
Na década de 1970, os computadores eram dominados por arquiteturas CISC (Complex Instruction Set Computer) — processadores com centenas de instruções complexas, cada uma podendo realizar múltiplas operações em uma única chamada. A ideia era que instruções poderosas tornariam os programas mais curtos e os compiladores mais simples.
Três projetos independentes questionaram essa premissa:
| Projeto | Instituição | Arquitetura resultante |
|---|---|---|
| John Cocke | IBM (1975) | IBM 801 |
| John Hennessy | Stanford (1981) | MIPS |
| David Patterson | UC Berkeley (1982) | RISC-I e RISC-II |
O projeto de Berkeley não virou produto diretamente, mas foi a base de um: a SPARC, lançada pela Sun Microsystems em 1986–87, é descendente direta do RISC-II. É uma confusão comum atribuir a SPARC a Berkeley — a ideia veio de lá, o processador veio da Sun.
A conclusão comum era empírica: análise de compiladores reais mostrou que apenas uma fração das instruções CISC era efetivamente utilizada. A maior parte do tempo de execução envolvia operações simples (movimentação de dados, aritmética inteira básica, desvios). Instruções complexas raramente valiam o custo de implementação em hardware. Seria mais eficiente ter poucas instruções simples, executadas em um ciclo, do que muitas instruções complexas, executadas em vários ciclos.
Nascia o RISC — Reduced Instruction Set Computer.
As sete características do RISC #
- Conjunto reduzido de instruções — poucas dezenas a ~100 instruções; cada uma simples e regular.
- Formato fixo — todas as instruções têm o mesmo tamanho (32 bits no MIPS, 32 bits no ARM clássico). Isso simplifica enormemente o estágio de decodificação do pipeline.
- Arquitetura Load/Store — apenas
LOADeSTOREacessam a memória principal; todas as demais instruções operam exclusivamente sobre registradores. - Grande banco de registradores — 32 ou mais registradores de propósito geral (vs. 8–16 no x86).
- Baixo CPI nas instruções simples — a maioria das instruções é projetada para execução rápida, idealmente com CPI (ciclos por instrução) próximo de 1, favorecendo alto throughput no pipeline.
- Pipeline altamente eficiente — o formato fixo permite decodificação paralela e estágios uniformes.
- Compiladores mais complexos — a responsabilidade de otimizar código migra do hardware para o compilador; o hardware fica mais simples.
Sobre números e características do RISC
As características acima descrevem o perfil clássico das arquiteturas RISC. Em processadores reais, há variações importantes entre famílias e gerações. O ponto central não é um número exato de instruções ou um CPI rigidamente igual a 1, mas a busca por simplicidade, regularidade e eficiência de pipeline.
RISC × CISC: a comparação completa #
Comparação clássica, não dogma absoluto
A tabela a seguir resume diferenças históricas e didáticas entre RISC e CISC. Em processadores modernos, várias dessas fronteiras ficaram menos rígidas: arquiteturas CISC usam execução interna altamente regular, e arquiteturas RISC modernas também incorporam extensões complexas quando necessário.
| Característica | RISC | CISC |
|---|---|---|
| Número de instruções | Pequeno (~50–150) | Grande (200–500+) |
| Formato das instruções | Fixo (ex.: 32 bits no MIPS) | Variável (ex.: 1–15 bytes no x86) |
| Acesso à memória | Só via LOAD / STORE |
Qualquer instrução pode acessar a MP |
| Banco de registradores | Muitos (32+) | Poucos (8–16) |
| Ciclos por instrução (CPI) | ~1 | 1–10+ |
| Pipeline | Simples e eficiente | Complexo |
| Unidade de Controle | Cabeada (hardwired) | Microprogramada (em geral) |
| Compiladores | Mais complexos | Mais simples |
| Exemplos reais | MIPS, SPARC, ARM, RISC-V | Intel x86, AMD64, Motorola 68000 |
E o consumo de energia?
É comum encontrar, em tabelas como esta, uma linha dizendo que RISC consome menos energia que CISC. A associação é compreensível — o ARM domina os celulares e o x86 dominou os desktops —, mas não resiste aos dados. O estudo de referência sobre o assunto, Power Struggles: Revisiting the RISC vs. CISC Debate (Blem, Menon e Sankaralingam, HPCA 2013), mediu processadores ARM e x86 em cargas reais e concluiu que o ISA praticamente não afeta o consumo nem o desempenho. O que decide é a microarquitetura — quanto de pipeline, especulação e cache o projeto carrega — e o nó de fabricação.
Os ARM de celular consomem pouco porque foram projetados para consumir pouco, não porque são RISC. E processadores ARM de servidor, projetados para desempenho, consomem tanto quanto seus equivalentes x86.
O x86 é CISC por fora, RISC por dentro
Os processadores Intel e AMD modernos são CISC externamente — mantêm compatibilidade com décadas de código legado. Mas internamente, decompõem instruções CISC em micro-operações RISC (µops) antes de executá-las. Isso combina a compatibilidade do CISC com a eficiência do RISC — e é por isso que processadores x86 modernos são tão rápidos mesmo com um ISA que data dos anos 1970.
Arquiteturas RISC reais #
- ARM (Advanced RISC Machines): domina smartphones e sistemas embarcados, e também ganhou muito espaço em notebooks, desktops e cloud. A linha Apple Silicon é um exemplo marcante do uso de ARM em computadores pessoais.
- MIPS: amplamente usado em roteadores, consoles (PlayStation 1/2) e como base para o ensino de arquitetura de computadores.
- SPARC: usado em servidores Sun/Oracle. Implementa register windows — técnica que acelera chamadas de função sem salvar registradores na memória.
- RISC-V: arquitetura RISC aberta e livre de royalties. Cresceu fortemente em pesquisa, ensino, sistemas embarcados e vem avançando de forma acelerada também em aplicações comerciais.
- Intel x86 / AMD64: CISC clássico que domina desktops e servidores. Instruções de tamanho variável (1 a 15 bytes). Internamente usa µops RISC.
Exemplo — RISC × CISC: cinco aspectos comparados
| Aspecto | RISC | CISC |
|---|---|---|
| Quantidade de instruções | Pequena (~100), formato fixo | Grande (200–300+), formatos variáveis |
| Circuitos da UCP | Mais simples: decodificador menor, sem microprogramação | Mais complexos: decodificador grande, microprograma em ROM |
| Uso de pipeline | Muito eficiente: tamanho fixo facilita estágios uniformes; idealmente 1 instrução/ciclo | Menos eficiente: tamanho variável complica o pipeline |
| Tamanho do programa | Mais linhas de assembly (operações simples exigem mais instruções) | Menos linhas de assembly (cada instrução faz mais) |
| Acessos à MP | Apenas LOAD e STORE | Qualquer instrução pode acessar a MP |
O paradoxo do tamanho de código RISC/CISC merece atenção: CISC produz programas assembly mais curtos (menos instruções), mas cada instrução ocupa mais bits no código objeto (formato variável, campos extensos). RISC gera mais instruções, mas cada uma ocupa exatamente 32 bits. Dependendo da comparação (assembly vs. binário), cada lado pode parecer mais compacto — sem que haja contradição.
Métricas de desempenho #
Comparar processadores exige cuidado — a métrica errada pode levar a conclusões enganosas.
MIPS — Millions of Instructions Per Second #
$$ MIPS = \frac{f_{\text{clock}}}{CPI \times 10^6} $$onde \(f_{\text{clock}}\) é a frequência em Hz e \(CPI\) (Cycles Per Instruction) é o número médio de ciclos por instrução.
Exemplo — Calculando MIPS sem comparar ISAs diferentes
Considere duas CPUs hipotéticas que implementam o mesmo ISA:
- CPU A: \(f_{\text{clock}} = 2{,}0\ \text{GHz}\), \(CPI = 2\)
- CPU B: \(f_{\text{clock}} = 1{,}5\ \text{GHz}\), \(CPI = 1\)
Para a CPU A:
$$ MIPS_A = \frac{2{,}0 \times 10^9}{2 \times 10^6} = 1000\ \text{MIPS} $$Para a CPU B:
$$ MIPS_B = \frac{1{,}5 \times 10^9}{1 \times 10^6} = 1500\ \text{MIPS} $$Mesmo com frequência menor, a CPU B entrega mais instruções por segundo porque seu CPI médio é menor.
Limitação do MIPS: ele pode ser útil dentro de um mesmo contexto de comparação, mas não é uma métrica confiável para comparar arquiteturas diferentes, porque instruções distintas podem realizar quantidades muito diferentes de trabalho.
MFLOPS e SPECmark #
- MFLOPS (Millions of Floating Point Operations Per Second): usado para cálculo científico, simulações, álgebra linear, deep learning. Conta operações de ponto flutuante, não instruções.
- SPECmark (Standard Performance Evaluation Corporation): benchmark padronizado e independente que executa um conjunto representativo de programas reais e compara com um sistema de referência. Supera as limitações do MIPS ao usar cargas de trabalho reais.
A taxonomia de Flynn #
Durante décadas, a indústria entregou mais desempenho de duas formas: aumentando a frequência do relógio (megahertz para gigahertz) e otimizando o pipeline de um único núcleo. No entanto, essas abordagens bateram em um muro físico: o limite térmico. Como não é mais viável acelerar o clock de um único chip sem que ele derreta, a solução foi multiplicar o hardware.
O muro tem nome e data: o fim do escalonamento de Dennard
Em 1974, o mesmo Robert Dennard que inventou a DRAM publicou a observação que sustentou três décadas de processadores cada vez mais rápidos: ao encolher um transistor, a tensão e a corrente necessárias encolhem na mesma proporção, e a densidade de potência se mantém constante. Transistores menores podiam, portanto, chavear mais rápido sem esquentar mais por área. É o escalonamento de Dennard, e ele é o motor por trás da corrida dos megahertz.
Por volta de 2005, ele parou de valer. Abaixo de certa espessura, a corrente de fuga dos transistores deixou de encolher junto, e a tensão não pôde mais baixar sem que os transistores deixassem de funcionar de forma confiável. A densidade de potência passou a subir a cada geração. A resposta da indústria foi a que este artigo descreve: parar de acelerar um núcleo e começar a multiplicá-los. É por isso que um processador de hoje tem 8 núcleos a 3 GHz, e não 1 núcleo a 24 GHz — e o Pentium 4 de 3,8 GHz do mito do megahertz foi, essencialmente, o último da linhagem.
Para entender e classificar as diversas formas de paralelismo, costuma-se usar a taxonomia de Flynn, proposta em 1966 por Michael Flynn. Ela continua sendo uma referência útil para classificar grande parte das arquiteturas paralelas, com base em dois eixos: o fluxo de instruções e o fluxo de dados.
%%{init: {'flowchart': {'useMaxWidth': false}}}%%
graph TD
    Flynn["Taxonomia de Flynn
(Classificação de Arquiteturas Paralelas)"]

    Flynn --> SISD["SISD
Single Instruction, Single Data
─────────────────
1 instrução, 1 dado por ciclo
Von Neumann clássico
Ex.: PC de 1 núcleo"]
    Flynn --> SIMD["SIMD
Single Instruction, Multiple Data
─────────────────
1 instrução → N dados simultâneos
Processamento vetorial / GPU
Ex.: Intel SSE/AVX, CUDA"]
    Flynn --> MISD["MISD
Multiple Instruction, Single Data
─────────────────
N instruções → 1 dado
Categoria rara e controversa
Ex.: poucos casos práticos convincentes"]
    Flynn --> MIMD["MIMD
Multiple Instruction, Multiple Data
─────────────────
N instruções + N dados
Paralelismo real e geral
Ex.: SMP, clusters, multicore"]
| Tipo | Instrução | Dados | Descrição | Exemplos reais |
|---|---|---|---|---|
| SISD | Único | Único | Von Neumann tradicional | PC com 1 núcleo |
| SIMD | Único | Múltiplos | Processamento vetorial | Intel SSE/AVX, GPUs NVIDIA, ARM NEON |
| MISD | Múltiplos | Único | Categoria rara e controversa | Poucos exemplos práticos consensuais |
| MIMD | Múltiplos | Múltiplos | Paralelismo completo | SMP, clusters, processadores multicore |
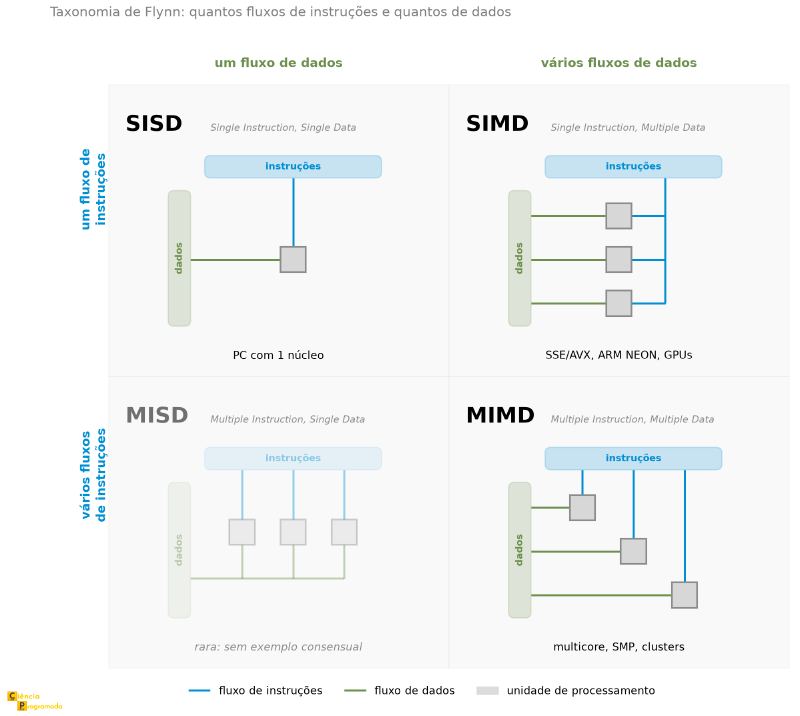
A figura abaixo organiza as quatro categorias no quadrante que dá sentido aos nomes: as linhas contam os fluxos de instruções, e as colunas, os fluxos de dados. Em cada casa, um fluxo único é uma linha só, que se ramifica até as unidades de processamento; vários fluxos são linhas separadas. A casa MISD aparece esmaecida pelo motivo da tabela: é rara e não tem exemplo consensual.
Exemplo — Classificando arquiteturas reais segundo Flynn
- PC convencional com 1 núcleo: SISD — um fluxo de instruções opera sobre um fluxo de dados.
- Instruções SSE/AVX do Intel: SIMD — uma instrução de soma vetorial opera sobre
vários pares de floats simultaneamente: 4 pares com SSE (
ADDPS, 128 bits), 8 com AVX (VADDPS, 256 bits) e 16 com AVX-512 (VADDPS, 512 bits). - GPU NVIDIA com CUDA: costuma ser descrita como SIMD/SIMT — muitos elementos executam a mesma ideia de operação sobre dados distintos, embora a organização prática use threads e grupos de execução próprios da GPU.
- Processador Intel Core i7 (multicore): MIMD — cada núcleo executa instruções independentes com dados diferentes; os núcleos podem estar executando programas completamente distintos.
- Cluster de servidores: MIMD — cada nó executa seu próprio programa com seus próprios dados, comunicando-se por passagem de mensagens (MPI).
SMP: múltiplos processadores, uma memória #
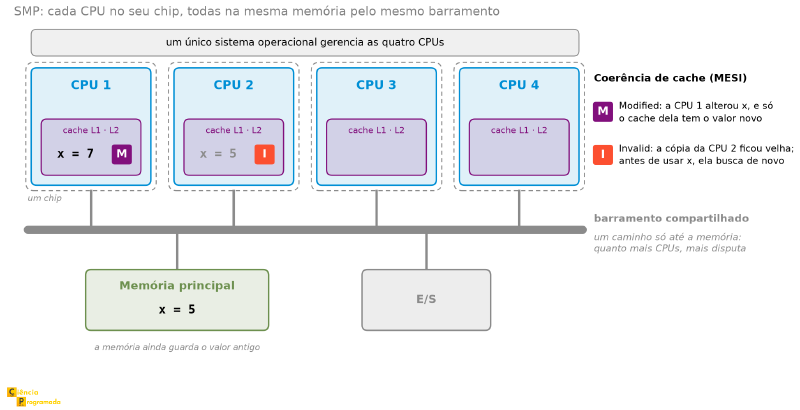
O SMP (Symmetric Multi-Processing) conecta vários processadores idênticos
à mesma memória principal e ao mesmo sistema de E/S, gerenciados por um único
sistema operacional. Na figura abaixo, cada CPU está no seu próprio chip, com o seu
cache, e todas chegam à memória e à E/S pelo mesmo barramento. Os valores de x nos
caches ilustram o problema de coerência discutido logo adiante.
Vantagens: múltiplas CPUs trabalhando em paralelo; falha de uma CPU não paralisa o sistema; crescimento incremental (adicionar CPUs conforme a demanda).
Problema crítico — Coerência de cache: cada CPU tem seus próprios caches (L1, L2). Se CPU1 modifica o valor de uma variável no seu cache, CPU2 pode estar lendo um valor desatualizado do seu cache. Protocolos de coerência como o MESI (Modified, Exclusive, Shared, Invalid) resolvem isso em hardware.
É o caso da figura acima: no cache da CPU 1, x já foi alterado para 7 e está no
estado M; a cópia da CPU 2 ainda diz 5, e o MESI a marca I, inválida. A memória principal
também guarda o valor antigo: por enquanto, a alteração existe só no cache da CPU 1.
Gargalo de escalabilidade do SMP
O barramento compartilhado — ou, de forma mais geral, a interconexão e a memória compartilhada — é o principal gargalo do SMP. À medida que o número de CPUs cresce, a contenção por acesso também cresce. Na prática, existe um limite de escalabilidade além do qual arquiteturas como NUMA ou clusters se tornam mais adequadas.
Clusters: memória distribuída, escala ilimitada #
Um cluster é um grupo de computadores independentes (nós) conectados por uma rede de alta velocidade (Ethernet, InfiniBand), trabalhando de forma coordenada como um único sistema. Cada nó tem sua própria memória; a comunicação entre nós é feita por passagem de mensagens (MPI — Message Passing Interface).
| Característica | SMP | Cluster |
|---|---|---|
| Modelo de memória | Compartilhada | Distribuída |
| Sistema Operacional | Único para todos | Um por nó |
| Comunicação | Barramento / MP | Rede (Ethernet, InfiniBand) |
| Escalabilidade | Limitada (dezenas de soquetes)¹ | Alta (até milhares de nós) |
| Custo por processador | Alto (hardware especial) | Menor (hardware padrão) |
| Coerência de cache | Problema real (protocolo MESI) | Não se aplica |
| Latência de comunicação | Nanosegundos | Microssegundos a milissegundos |
¹ O limite do SMP é contado em soquetes, isto é, em processadores físicos disputando a mesma memória — e aí ele é de fato baixo, porque o barramento compartilhado satura. Contando núcleos, o número muda de escala: um servidor atual de dois soquetes passa de 190 núcleos. É o mesmo SMP, com o paralelismo empacotado dentro de cada chip.
Exemplo — SMP ou cluster?
Dois cenários práticos:
Cenário A — serviço que precisa escalar ao longo dos anos: Cluster — permite adicionar novos nós conforme a demanda cresce (escalabilidade horizontal). Basta conectar mais máquinas à rede. SMP tem escalabilidade limitada pelo gargalo do barramento compartilhado.
Cenário B — espaço físico muito limitado com demanda estável: SMP — um único servidor ocupa menos espaço físico e é gerenciado por um único sistema operacional. Não há necessidade de infraestrutura de rede adicional. Ideal quando não há previsão de crescimento.
NUMA: o meio-termo #
O NUMA (Non-Uniform Memory Access) é uma arquitetura intermediária entre SMP e clusters:
- A memória é fisicamente distribuída entre os nós — cada processador tem RAM local.
- Logicamente, todo o espaço de endereçamento é unificado — qualquer CPU pode endereçar qualquer posição de memória.
- Acesso à RAM local: rápido.
- Acesso à RAM remota (de outro nó): mais lento — atravessa a interconexão entre nós.
Usado em servidores modernos de alto desempenho, o CC-NUMA combina memória fisicamente distribuída com um espaço de endereçamento logicamente unificado, preservando a coerência de cache por hardware.
Computação vetorial: SIMD em ação #
A computação vetorial aplica a mesma operação repetidamente sobre grandes conjuntos de dados — arrays científicos, simulações, álgebra linear, redes neurais.
Dois caminhos de implementação:
| Método | Descrição | Exemplos |
|---|---|---|
| Pipeline de UAL | UAL organizada em estágios de pipeline; elementos processados sequencialmente com sobreposição | Cray-1 (1976) |
| UALs Paralelas | Múltiplas UALs idênticas processam vários elementos simultaneamente (SIMD) | Intel SSE/AVX, GPUs CUDA |
A evolução histórica:
- Cray-1 (1976): primeiro supercomputador vetorial comercial de sucesso; 160 MFLOPS — impressionante para a época.
- Intel SSE / AVX: extensões SIMD do x86. AVX-512 processa 16 floats de 32 bits (ou 8 doubles de 64 bits) em uma única instrução.
- NVIDIA GPU: dezenas de milhares de núcleos CUDA operando em SIMD massivo — arquitetura SIMT (Single Instruction Multiple Threads).
Tendências modernas: multicore e many-core #
Multicore #
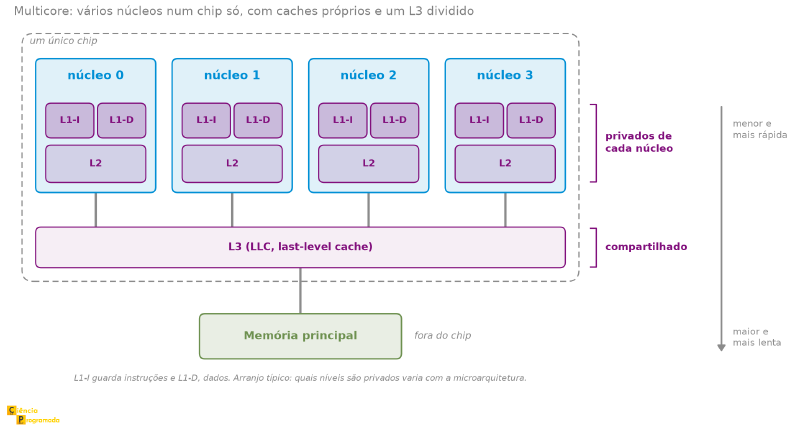
Vários núcleos de processamento completos integrados em um mesmo processador. Cada núcleo costuma ter caches L1 e L2 privados, enquanto níveis mais altos de cache podem ser compartilhados, dependendo da microarquitetura.
A figura abaixo mostra esse arranjo no mesmo vocabulário visual da figura do SMP, e a diferença salta à vista: lá havia uma fronteira de chip em volta de cada CPU; aqui há uma só, em volta dos quatro núcleos e do L3 que eles dividem.
Exemplos: processadores Intel Core e AMD Ryzen em desktops e notebooks, além da linha Apple Silicon em Macs. Classificação: MIMD.
SMT: os núcleos que o gerenciador de tarefas mostra a mais #
Abra o gerenciador de tarefas de um computador moderno e é provável que ele diga algo como “8 núcleos, 16 processadores lógicos”. A diferença é a multithreading simultânea (SMT) — que a Intel comercializa como Hyper-Threading.
A ideia parte de uma observação sobre desperdício: um núcleo passa boa parte do tempo esperando — por uma falta de cache, por um desvio mal previsto —, e durante essa espera o pipeline fica parado. Com SMT, o núcleo duplica os registradores que guardam o estado de uma thread (CI, registradores de propósito geral, flags) mas mantém uma única cópia do resto — UAL, caches, preditor de desvio. Dois fluxos de instrução passam a compartilhar o mesmo hardware de execução, e quando um espera, o outro avança.
O ganho é real mas modesto: tipicamente entre 15% e 30% em cargas que se beneficiam, e nenhum em cargas que já saturam o núcleo. Um núcleo com SMT não equivale a dois núcleos — equivale a um núcleo que desperdiça menos. É por isso que o sistema operacional, ao distribuir tarefas, prefere ocupar primeiro núcleos físicos distintos e só depois os processadores lógicos de um mesmo núcleo.
Many-core #
Arquiteturas many-core reúnem dezenas, centenas ou milhares de unidades de execução simples no mesmo chip, otimizadas para paralelismo massivo.
Exemplos típicos são as GPUs modernas da NVIDIA e AMD. Em vez de focar em poucas unidades muito complexas, essas arquiteturas priorizam alta vazão para cargas massivamente paralelas. Classificação aproximada: SIMD / SIMT.
Os modelos mudam; a classificação fica
Os exemplos de hardware deste artigo estão citados por família — Ryzen, Core, Apple Silicon, GeForce, Radeon — e não por modelo, porque os modelos são substituídos a cada ano e qualquer número específico envelhece rápido. O que não envelhece é a classificação: daqui a dez anos haverá processadores e GPUs com outros nomes, mais núcleos e mais memória, e eles continuarão sendo MIMD e SIMD pelos mesmos motivos descritos aqui.
Onde cada arquitetura se encaixa #
| Arquitetura | Taxonomia de Flynn |
|---|---|
| PC com 1 núcleo | SISD |
| Instruções SSE/AVX | SIMD |
| GPU (CUDA/OpenCL) | SIMD / SIMT |
| Processador multicore | MIMD |
| SMP | MIMD |
| Cluster / supercomputador | MIMD |
O limite de multiplicar núcleos: a Lei de Amdahl #
Se a solução para o muro térmico foi multiplicar o hardware, fica a pergunta que este artigo levantou lá atrás e ainda não respondeu: até onde isso vai? Dobrar o número de núcleos dobra o desempenho?
A resposta foi dada em 1967 por Gene Amdahl, e é a fórmula mais importante sobre paralelismo. A ideia é que quase todo programa tem uma parte que não se paraleliza — ler a entrada, inicializar estruturas, combinar os resultados parciais, qualquer trecho em que um passo depende do anterior. Chamando de \(s\) a fração do tempo gasta nessa parte serial, o ganho máximo com \(N\) núcleos é dado pela Lei de Amdahl:
$$S(N) = \frac{1}{s + \dfrac{1 - s}{N}}$$A parte paralela, \(1 - s\), é dividida por \(N\); a parte serial, \(s\), não é dividida por nada. E aí está o problema. Para um programa com apenas 10% de código serial (\(s = 0{,}1\)):
| Núcleos (\(N\)) | Ganho \(S(N)\) |
|---|---|
| 2 | 1,82× |
| 4 | 3,08× |
| 8 | 4,71× |
| 16 | 6,40× |
| 64 | 8,77× |
| 1024 | 9,91× |
| \(\infty\) | 10× |
Com 8 núcleos, o programa não fica 8 vezes mais rápido: fica 4,7. E nenhuma quantidade de núcleos o leva além de 10×, porque quando \(N\) cresce sem limite o termo \((1-s)/N\) some e sobra \(S = 1/s\). Os 10% seriais, que pareciam pouco, viram o teto.
Amdahl é pessimista de propósito
A Lei de Amdahl supõe um problema de tamanho fixo: o mesmo trabalho, distribuído entre mais núcleos. Na prática, quem ganha mais núcleos costuma usar para resolver problemas maiores — mais pixels, mais dados, simulações mais finas —, e nesses casos a parte paralela cresce enquanto a serial fica parada. Esse outro ponto de vista é a Lei de Gustafson (1988), e explica por que GPUs com milhares de núcleos valem a pena. Mas o recado de Amdahl continua de pé para qualquer tarefa com tamanho dado: o gargalo do paralelismo é a parte que não se paraleliza, e é nela que vale gastar esforço de otimização primeiro.
Conclusão #
Chegamos ao fim da série. Partimos de portas lógicas e de uma célula de memória — os arranjos mínimos de cálculo e de armazenamento — e chegamos a processadores com múltiplos níveis de cache, pipelines, DMA, barramentos hierárquicos e arquiteturas paralelas em vários níveis. Cada artigo revelou uma camada diferente da mesma máquina que responde a um comando seu em frações de segundo.
O computador que você usa é uma obra de engenharia com sessenta anos de refinamento contínuo. Agora você sabe o que há por dentro.
Fique atento para as próximas séries de artigos do site. Até a próxima!


