
No artigo anterior — Representação de Dados — vimos como o computador codifica caracteres, inteiros e números de ponto flutuante como padrões de bits. Mas um programa não é apenas dados: é uma sequência de instruções que dizem ao processador o que fazer com esses dados. Como essas instruções são codificadas? Onde o processador encontra os operandos que elas precisam?
Essas perguntas são respondidas pela ISA — Instruction Set Architecture — e pelos modos de endereçamento que ela define. A ISA é o ponto de encontro entre o hardware e o software: tudo que um programa faz deve ser expresso em termos que o processador conheça.
A ISA: o contrato entre hardware e software #
A ISA (Instruction Set Architecture) é a interface entre o hardware e o software. Ela define o conjunto de instruções que o processador entende e o modelo visível para compiladores, montadores, sistemas operacionais e programas.
A ISA especifica, entre outras coisas:
- o formato das instruções;
- os tipos de dados suportados;
- os modos de endereçamento;
- os registradores e seus papéis;
- o conjunto de operações que a CPU executa nativamente.
É útil pensar na ISA como um contrato de compatibilidade: programas traduzidos para um ISA só executam diretamente em processadores que implementam esse ISA, salvo uso de emulação, tradução binária ou máquinas virtuais.
ISA não é a mesma coisa que microarquitetura
Dois processadores podem implementar o mesmo ISA e, ainda assim, serem internamente muito diferentes. É o caso de diferentes CPUs x86-64 da Intel e AMD: o software enxerga o mesmo ISA, mas o hardware interno pode variar bastante.
Linguagens de programação e ISA
Nem toda linguagem de alto nível vira diretamente instruções do ISA da máquina.
- Em linguagens compiladas nativamente, como C e C++, o compilador geralmente gera código de máquina para o ISA-alvo.
- Em linguagens ou plataformas como Java e Python, pode haver etapas intermediárias, como bytecode, máquina virtual ou compilação JIT, antes da execução final no hardware.
Ainda assim, em última instância, a execução real sempre termina em instruções do ISA implementado pelo processador.
ISA no mercado atual
A família x86-64 continua dominante em desktops e muitos servidores. A família ARM hoje vai muito além de smartphones, aparecendo também em sistemas embarcados, notebooks, nuvem e datacenters. O RISC-V, por sua vez, ganhou relevância por ser um ISA aberto, especialmente em pesquisa, ensino e sistemas embarcados.
Uma classificação útil das instruções #
Uma forma didática de organizar as instruções de máquina é agrupá-las por função:
| # | Categoria | Exemplos de mnemônicos |
|---|---|---|
| 1 | Movimentação de dados | LOAD, STORE, MOV |
| 2 | Aritmética inteira | ADD, SUB, MPY, DIV |
| 3 | Aritmética de ponto flutuante | FADD, FMPY, FDIV |
| 4 | Lógica | AND, OR, NOT, XOR |
| 5 | Deslocamentos | SHL, SHR, SAR |
| 6 | Controle de fluxo | JMP, JZ, CALL, RET |
| 7 | Entrada/Saída | IN, OUT |
Essa classificação é útil para estudo, mas não deve ser tratada como uma taxonomia universal. ISAs reais modernas também incluem, por exemplo, instruções vetoriais, atômicas, criptográficas, de sistema e de sincronização.
Arquiteturas RISC tendem a ter poucas instruções por categoria, cada uma simples e regular. Arquiteturas CISC podem ter dezenas de variantes por categoria, incluindo operações complexas em uma única instrução.
Mas independentemente da categoria ou da complexidade, a CPU precisa saber ler essa ordem. Toda instrução precisa ser fisicamente empacotada em bits, e é nesse empacotamento que entra o design dos formatos de instrução.
Formatos de instrução: quantos operandos? #
Uma das decisões fundamentais no projeto de um ISA é quantos operandos cada instrução carrega. Há um trade-off claro: mais operandos permitem instruções mais expressivas — e portanto programas mais curtos — mas cada instrução ocupa mais espaço na memória.
Antigamente, a preocupação com o espaço era tão extrema que projetos como o SEAC (1950) utilizavam até 4 operandos: três para a operação e um quarto apenas para indicar o endereço da próxima instrução. Com a popularização do registrador CI (Contador de Instrução), que aponta automaticamente para a próxima tarefa, economizamos esses bits preciosos, permitindo formatos mais enxutos.
Para ilustrar, vamos calcular a expressão:
$$X = A \times (B + C \times D - E / F)$$em três formatos diferentes.
Formato com 3 operandos #
Forma geral: destino ← operando1 OP operando2
MPY T1, C, D        ; T1 = C × D
ADD T2, B, T1       ; T2 = B + T1  (= B + C × D)
DIV T3, E, F        ; T3 = E / F
SUB T4, T2, T3      ; T4 = T2 − T3 (= B + C×D − E/F)
MPY X,  A, T4       ; X  = A × T4  (resultado final)
Total: 5 instruções. Cada instrução é autocontida — especifica entrada, operação e destino. As instruções são mais longas (três endereços codificados em cada uma), mas o programa é compacto.
Formato com 2 operandos #
Forma geral: Op1 ← Op1 OP Op2 — o primeiro operando é também o destino.
MOV X, C
MPY X, D            ; X = C × D
ADD X, B            ; X = B + C × D
MOV T, E
DIV T, F            ; T = E / F
SUB X, T            ; X = B + C×D − E/F
MPY X, A            ; X = A × (B + C×D − E/F)
Total: 7 instruções. É necessário inserir MOVs para preservar valores
originais antes de sobrescrevê-los. Este é o formato mais comum em arquiteturas
reais — a família x86 é baseada em instruções de 2 operandos.
Formato com 1 operando (acumulador) #
Forma geral: ACC ← ACC OP Operando — todas as operações passam por um
registrador especial chamado acumulador.
LDA C               ; ACC = C
MPY D               ; ACC = C × D
ADD B               ; ACC = B + C × D
STR T               ; T   = ACC           (salva temporário)
LDA E               ; ACC = E
DIV F               ; ACC = E / F
STR T2              ; T2  = ACC
LDA T               ; ACC = T  (= B + C × D)
SUB T2              ; ACC = B + C×D − E/F
MPY A               ; ACC = A × (B + C×D − E/F)
STR X               ; X   = ACC           (resultado final)
Total: 11 instruções. Cada instrução é compacta (um único endereço), mas são necessárias mais delas e mais acessos à memória para salvar resultados intermediários. Este formato foi comum nos primeiros microprocessadores.
Comparativo #
| Formato | Nº de instruções | Espaço por instrução | Uso típico |
|---|---|---|---|
| 3 operandos | 5 | Grande (3 endereços) | Arquiteturas RISC modernas |
| 2 operandos | 7 | Médio (2 endereços) | x86, a maioria das arquiteturas |
| 1 operando (ACC) | 11 | Pequeno (1 endereço) | Primeiros microprocessadores |
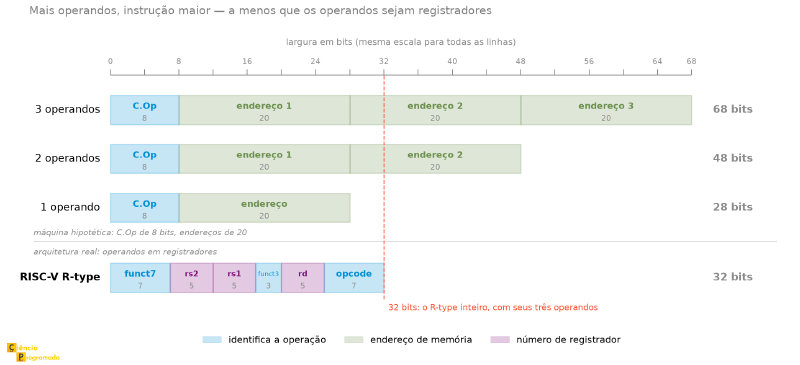
Mais do que o número de linhas, o projetista de hardware olha para o balanço entre bits e ciclos. Vale colocar números nisso. Suponha um C.Op de 8 bits e endereços de memória de 20 bits — parâmetros plausíveis para uma máquina didática. Então:
- uma instrução de 3 operandos ocupa \(8 + 3 \times 20 = 68\) bits;
- de 2 operandos, \(8 + 2 \times 20 = 48\) bits;
- de 1 operando, \(8 + 20 = 28\) bits.
A instrução de 3 operandos é mais “pesada”, mas resolve a conta com menos viagens à memória. A de 1 operando é “leve”, mas exige muito mais acessos para carregar e salvar o acumulador constantemente. É o eterno dilema entre gastar memória com o código ou gastar tempo com a execução — e, note, os dois lados da balança se medem em unidades diferentes, o que é justamente o que torna a decisão difícil.
Um formato real: o R-type do RISC-V #
Os números acima são de uma máquina de papel. Vale ver como um ISA de verdade resolve o problema, e o RISC-V é a melhor escolha para isso: além de ser aberto e documentado, ele tem a codificação mais regular em uso. Seu formato de três operandos, chamado R-type, cabe em 32 bits:
| Campo | Bits | Função |
|---|---|---|
funct7 |
7 | Completa a identificação da operação |
rs2 |
5 | Segundo registrador de origem |
rs1 |
5 | Primeiro registrador de origem |
funct3 |
3 | Completa a identificação da operação |
rd |
5 | Registrador de destino |
opcode |
7 | Identifica a classe da instrução |
Três campos de 5 bits porque a arquitetura tem \(2^5 = 32\) registradores. Como os três operandos são registradores, e não endereços de memória, juntos eles ocupam só 15 bits: a instrução inteira cabe em 32, sobram 17 para identificar a operação, e o total fica muito longe dos 68 bits do formato de três endereços de memória da conta anterior.
A figura abaixo põe os quatro formatos na mesma régua de bits, os três da máquina de papel e o R-type. O formato de três operandos do RISC-V sai mais curto que o de dois operandos da máquina hipotética, e só 4 bits mais longo que o de um operando.
É esta a diferença que a discussão RISC × CISC costuma resumir mal: não é “menos instruções”, é operandos em registradores e formato de tamanho fixo, que juntos tornam a decodificação trivial e o pipeline previsível.
Um add rd, rs1, rs2 no RISC-V tem opcode = 0110011, funct3 = 000 e funct7
= 0000000; trocar funct7 para 0100000 transforma a mesma instrução em sub. A
operação muda, o formato não — e é por isso que o decodificador de um processador RISC
cabe em muito menos silício que o de um x86, onde uma instrução pode ter de 1 a 15
bytes.
Estratégia para calcular o número de instruções
-
3 operandos: cada operação da expressão gera, em geral, uma instrução com destino explícito. Na expressão
\[ X = A \times (B + C \times D - E/F) \]há 5 operações aritméticas: uma multiplicação \(C \times D\), uma soma, uma divisão, uma subtração e a multiplicação final por \(A\). Portanto, o programa com 3 operandos usa 5 instruções, sem precisar de uma instrução extra de “atribuição”.
-
2 operandos: acrescente
MOVs quando precisar preservar um valor antes de sobrescrevê-lo. -
1 operando: acrescente
LDAeSTRsempre que for necessário carregar dados no acumulador e salvar resultados intermediários.
Instruções como SQRT, NEG ou deslocamentos imediatos podem aparecer em ISAs
reais ou hipotéticos, mas sua presença isolada não define uma arquitetura
como CISC ou RISC.
A distinção entre RISC e CISC envolve um conjunto maior de decisões de projeto:
- regularidade dos formatos de instrução;
- quantidade de modos de endereçamento;
- complexidade média das instruções;
- facilidade de pipeline e decodificação.
Portanto, o exemplo a seguir é apenas um exemplo de ISA hipotético estendido, e não como prova de uma “filosofia CISC”.
Exemplo — Calcular \(X_1 = (-B + \sqrt{B^2 - 4C}) / 2\) com 1 operando
Usando instruções de 1 operando (acumulador) com endereçamento direto e imediato,
e com a instrução especial SQRT para raiz quadrada:
A ordem das operações aqui exige cuidado. Com um acumulador só, \(B^2 - 4C\) não pode ser calculado na sequência óbvia: subtrair 4 e depois multiplicar por \(C\) produziria \((B^2 - 4) \times C\), que é outra conta. O caminho é calcular \(4C\) primeiro, guardar num temporário, e só então subtrair:
LDA C        ; ACC = C
MPY #4       ; ACC = 4C            (endereçamento imediato)
STR TEMP     ; TEMP = 4C
LDA B        ; ACC = B
MPY B        ; ACC = B²
SUB TEMP     ; ACC = B² − 4C
SQRT         ; ACC = √(B² − 4C)
STR TEMP     ; TEMP = √(B² − 4C)   (reaproveita o temporário)
LDA B        ; ACC = B
NEG          ; ACC = −B
ADD TEMP     ; ACC = −B + √(B² − 4C)
SHR #1       ; ACC = ACC / 2       (shift right = dividir por 2)
STR X1       ; X1 = ACC
Treze instruções e um endereço temporário para uma expressão que, em papel, tem cinco operações. É o custo do acumulador único: cada resultado intermediário que não pode ser consumido imediatamente precisa ser estacionado na memória.
Essa fórmula tem um problema que o assembly não resolve
A ordem escolhida aqui está aritmeticamente correta, mas a fórmula de Bhaskara escrita desse jeito é numericamente instável em ponto flutuante: quando \(B^2\) é muito maior que \(4C\), a raiz fica quase igual a \(|B|\), e a subtração de dois números próximos destrói os dígitos significativos. É o cancelamento catastrófico, discutido em detalhe no artigo sobre IEEE 754 da série irmã, junto com a forma alternativa que evita o problema. Vale a menção porque é um bom exemplo de algo que este artigo não pode ver: a instrução está certa, a codificação está certa, e o resultado ainda pode estar errado — a representação dos números é uma camada abaixo da representação das instruções.
Modos de endereçamento #
Os modos de endereçamento definem como o processador obtém o operando de uma instrução.
O ponto central é este: o endereço efetivo (EA, Effective Address) é o endereço final do operando na memória, quando a instrução realmente acessa a memória. Em alguns modos, não há EA de memória, porque o dado já está na própria instrução ou em um registrador.
flowchart TD
    A([Instrução]) --> B{Modo de
Endereçamento}
    B --> C["Imediato
operando = constante"]
    B --> D["Direto
EA = endereço"]
    B --> E["Indireto
EA = M[endereço]"]
    B --> F["Reg. Direto
operando = Rn"]
    B --> G["Reg. Indireto
EA = Rn"]
    B --> H["Indexado
EA = endereço + Ri"]
    B --> I["Base + Deslocamento
EA = RB + desl"]
Depois de calcular o EA, quando houver acesso à memória, o operando será:
$$ \text{Operando} = M[EA] $$Para o processador, existem dois caminhos para identificar qual desses modos
usar: ou o Opcode já carrega essa informação (o código 1010 significa LDA Direto
e 1011 significa LDA Indireto) ou a instrução reserva um campo de bits
específico apenas para sinalizar o modo de endereçamento ao decodificador.
Modo imediato #
O operando é a constante codificada diretamente na instrução — não é um endereço, é o próprio valor.
$$\text{Operando} = \text{constante na instrução}$$- Vantagem: rapidíssimo — nenhum acesso adicional à MP
- Desvantagem: limitado pelo tamanho do campo; serve apenas para constantes pequenas e fixas
- Exemplo:
LDA #5→ ACC = 5
Modo direto (absoluto) #
O campo da instrução contém o endereço de memória onde está o operando.
$$ EA = \text{endereço} \qquad\Rightarrow\qquad \text{Operando} = M[EA] $$- Vantagem: simples e direto; fácil de entender e depurar
- Desvantagem: o endereço é fixo no código-objeto — dificulta a recolocação do programa
- Exemplo:
LDA 100→ ACC = M[100]
Modo indireto #
O campo contém um endereço que guarda o endereço do operando — um nível extra de indireção. O campo aponta para um ponteiro.
$$ EA = M[\text{endereço}] \qquad\Rightarrow\qquad \text{Operando} = M[EA] $$- Vantagem: flexível para ponteiros e estruturas dinâmicas
- Desvantagem: exige 2 acessos à MP — um para buscar o endereço, outro para buscar o dado
- Exemplo:
LDA @100→ ACC = M[M[100]]
Modo indireto: 2 acessos à memória
O modo indireto é frequentemente confundido com o modo registrador indireto. A diferença está no número de acessos à MP:
- Indireto (memória): 2 acessos — o endereço do ponteiro está na memória, então é preciso buscar o ponteiro (1º acesso) e depois o dado (2º acesso)
- Registrador indireto: 1 acesso — o ponteiro já está num registrador (sem acesso para buscá-lo), então há apenas o acesso ao dado
Modo registrador direto #
O operando está em um registrador do processador. Aqui não existe endereço efetivo: não há nada a calcular nem a buscar na memória, porque o dado já está dentro da CPU. O campo do operando na instrução não guarda um endereço, guarda o número do registrador:
$$\text{Operando} = R_n \qquad (\text{sem } EA)$$-
Vantagem: o mais rápido possível — ler um registrador custa cerca de 1 ciclo, contra 100 a 300 ciclos de um acesso à memória principal que não esteja em cache. A diferença é de duas ordens de grandeza.
-
Desvantagem: número limitado de registradores; programas precisam gerenciar quais dados mantêm em registradores
-
Exemplo:
ADD R1, R2→ R1 = R1 + R2
Modo registrador indireto #
O registrador contém o endereço de memória onde está o operando. O registrador funciona como ponteiro.
$$ EA = R_n \qquad\Rightarrow\qquad \text{Operando} = M[EA] $$- Vantagem: muito flexível para percorrer arrays usando um registrador como ponteiro incrementável
- Exemplo:
LDA (R1)→ ACC = M[R1]
Modo indexado #
O endereço base está codificado na instrução; o registrador índice \(R_i\) é somado a ele para calcular o endereço efetivo.
$$ EA = \text{endereço} + R_i \qquad\Rightarrow\qquad \text{Operando} = M[EA] $$- Vantagem: ideal para percorrer arrays sequencialmente — basta incrementar \(R_i\) a cada iteração
- Exemplo:
LDA 100(R1)→ ACC = M[100 + R1]
Imagine a tarefa de somar 100 números em um vetor. No modo direto, você teria que escrever a mesma instrução 100 vezes, mudando apenas o endereço. Com o Modo Indexado, você escreve a instrução uma única vez apontando para a base do vetor e usa um registrador de índice para “caminhar” pelos elementos. É a diferença entre um código de 300 linhas e um loop eficiente de 5 linhas.
Modo base + deslocamento #
O registrador contém a base; a instrução traz um deslocamento fixo.
$$ EA = R_B + \text{deslocamento} \qquad\Rightarrow\qquad \text{Operando} = M[EA] $$- Exemplo conceitual: acessar um campo de estrutura ou uma variável local na pilha
- Uso típico: código relocável, pilha, ativação de funções, acesso a campos de structs
Esse modo é muito comum em arquiteturas modernas porque separa bem o endereço base dinâmico do deslocamento fixo conhecido em tempo de compilação.
Exemplos modernos de base + deslocamento
Em arquiteturas atuais, esse modo aparece o tempo todo.
-
x86-64:
mov eax, [rbp-8]Acessa uma variável local a partir do ponteiro de base da pilha. -
AArch64:
ldr x0, [x1, #16]Acessa a posição de memória cujo endereço éx1 + 16.
Isso torna o modo base + deslocamento mais fácil de reconhecer em código real do que exemplos antigos baseados em segmentação histórica.
Indexado × base + deslocamento
Nos dois casos, o endereço final é a soma de dois valores. A diferença é:
-
Indexado: base na instrução + índice no registrador Ideal para arrays e iteração.
-
Base + deslocamento: base no registrador + deslocamento na instrução Ideal para pilha, structs e código relocável.
Tabela comparativa #
| Modo | EA | Operando | Acessos à MP para obter o dado | Vantagem principal |
|---|---|---|---|---|
| Imediato | — | valor na instrução | 0 | Constantes — rapidez máxima |
| Direto | \(\text{endereço}\) | \(M[EA]\) | 1 | Simples; variáveis globais |
| Indireto | \(M[\text{endereço}]\) | \(M[EA]\) | 2 | Ponteiros em memória |
| Reg. Direto | — | \(R_n\) | 0 | Operação rápida em registradores |
| Reg. Indireto | \(R_n\) | \(M[EA]\) | 1 | Ponteiro em registrador |
| Indexado | \(\text{endereço} + R_i\) | \(M[EA]\) | 1 | Percorrer arrays |
| Base + Deslocamento | \(R_B + \text{desl}\) | \(M[EA]\) | 1 | Pilha, structs, relocação |
Exemplo — Modos de endereçamento com tabela de memória
Considere a memória:
| Endereço | Conteúdo |
|---|---|
| 1AC1 | 1AC6 |
| 1AC2 | 1AC4 |
| 1AC3 | 1AC1 |
| 1AC4 | 1AC3 |
| 1AC5 | 1AC1 |
| 1AC6 | 1AC5 |
a) Direto, operando = 1AC1
$$ EA = 1AC1 \qquad\Rightarrow\qquad ACC \leftarrow M[1AC1] = \mathbf{1AC6} $$b) Imediato, operando = 1AC5
O campo operando já contém o valor:
$$ ACC \leftarrow \mathbf{1AC5} $$c) Indireto, operando = 1AC3
Primeiro calcula-se o endereço efetivo:
$$ EA = M[1AC3] = 1AC1 $$Depois busca-se o operando:
$$ ACC \leftarrow M[EA] = M[1AC1] = \mathbf{1AC6} $$d) Se o conteúdo de 1AC1 muda para 0
- Direto: \(ACC = M[1AC1] = \mathbf{0}\)
- Imediato: \(ACC = \mathbf{1AC5}\) (inalterado)
- Indireto: \(EA = M[1AC3] = 1AC1 \Rightarrow ACC = M[1AC1] = \mathbf{0}\)
O modo imediato é o único que não depende do conteúdo atual da memória.
Bônus Python: calculando endereços efetivos #
Entender o hardware lendo diagramas e fórmulas matemáticas pode parecer muito abstrato em um primeiro momento. Mas, no fim das contas, os modos de endereçamento são apenas lógicas de cálculo de ponteiros. Para um programador, a forma mais fácil de desmistificar o que o silício faz é traduzir essa mecânica para o código. Veja como o hardware calcularia os endereços efetivos usando funções simples em Python:
# Simula os principais modos de endereçamento.
# Atenção à convenção: cada função devolve o OPERANDO (o dado que a instrução
# queria) e o número de acessos à MP que foram necessários — não o endereço
# efetivo. O EA aparece no caminho, comentado onde for relevante.

def ea_imediato(valor):
    """Modo imediato: o operando é o próprio valor."""
    return valor, 0  # (dado, acessos à MP)


def ea_direto(memoria: dict, endereco: int):
    """Modo direto: EA = endereco; operando = M[EA]."""
    return memoria[endereco], 1


def ea_indireto(memoria: dict, endereco: int):
    """Modo indireto: EA = M[endereco]; operando = M[EA]."""
    ptr = memoria[endereco]          # 1º acesso: busca o ponteiro (= EA)
    return memoria[ptr], 2           # 2º acesso: busca o dado


def ea_reg_indireto(memoria: dict, registrador: int):
    """Modo registrador indireto: EA = Rn; operando = M[EA].

    O parâmetro recebe o CONTEÚDO do registrador, que já é o endereço.
    """
    return memoria[registrador], 1


def ea_indexado(memoria: dict, base: int, indice: int):
    """Modo indexado: EA = base + Ri; operando = M[EA]."""
    return memoria[base + indice], 1


def ea_base_deslocamento(memoria: dict, rb: int, deslocamento: int):
    """Modo base + deslocamento: EA = RB + deslocamento; operando = M[EA]."""
    return memoria[rb + deslocamento], 1


# Tabela de memória do exemplo anterior
mem = {
    0x1AC1: 0x1AC6,
    0x1AC2: 0x1AC4,
    0x1AC3: 0x1AC1,
    0x1AC4: 0x1AC3,
    0x1AC5: 0x1AC1,
    0x1AC6: 0x1AC5,
}

dado, acessos = ea_direto(mem, 0x1AC1)
print(f"Direto  (1AC1): {dado:04X}  ({acessos} acesso(s) à MP)")
# Direto  (1AC1): 1AC6  (1 acesso(s) à MP)

dado, acessos = ea_imediato(0x1AC5)
print(f"Imediato(1AC5): {dado:04X}  ({acessos} acesso(s) à MP)")
# Imediato(1AC5): 1AC5  (0 acesso(s) à MP)

dado, acessos = ea_indireto(mem, 0x1AC3)
print(f"Indireto(1AC3): {dado:04X}  ({acessos} acesso(s) à MP)")
# Indireto(1AC3): 1AC6  (2 acesso(s) à MP)

# Array com modo indexado
vetor = {100: 10, 101: 20, 102: 30, 103: 40}
for i in range(4):
    val, _ = ea_indexado(vetor, 100, i)
    print(f"vetor[{i}] = {val}")
# vetor[0] = 10, vetor[1] = 20, vetor[2] = 30, vetor[3] = 40
Conclusão e próximos artigos #
A ISA define o vocabulário que o processador entende — e os formatos de instrução e os modos de endereçamento são a gramática desse vocabulário. Com três operandos por instrução e sete modos de endereçamento, um processador consegue expressar desde simples adições até acesso dinâmico a estruturas de dados complexas. A escolha entre mais operandos (CISC) e menos operandos (RISC) reflete um trade-off entre expressividade e regularidade que o hardware moderno resolve de formas sofisticadas — tema do próximo artigo.
Se você quiser ver instruções reais sendo geradas agora, o Compiler Explorer é a ferramenta certa: você escreve C, C++, Rust ou uma dúzia de outras linguagens de um lado e vê, do outro, o assembly que o compilador produz — podendo escolher a arquitetura, inclusive RISC-V, e comparar os formatos que este artigo descreveu. É a forma mais rápida de sair da tabela e chegar no bit.
No próximo artigo, vamos acompanhar o ciclo de vida de um programa: desde o código-fonte em uma linguagem de alto nível, passando pela compilação, ligação e carregamento, até se tornar as instruções de máquina que o processador executa. Veremos como o ISA é a ponte entre o código que escrevemos e o silício que o executa, e como as decisões de projeto da ISA impactam a eficiência e a flexibilidade dos programas.
Até lá!


