
No artigo anterior — Pipeline e Barramentos — vimos como a CPU executa múltiplas instruções em paralelo e como os barramentos transportam informação entre os componentes. Mas o que é essa informação? Para o hardware, tudo são bits — tensões altas e baixas, zeros e uns. A diferença entre um caractere, um inteiro negativo e um número de ponto flutuante está exclusivamente na convenção de interpretação — na forma como acordamos que um padrão de bits deve ser lido.
Essa escolha não afeta apenas o software; ela molda o design físico do chip. A quantidade de bits que escolhemos para representar um dado dita diretamente a largura do barramento de dados, a capacidade dos registradores e a complexidade da UAL. A primeira dessas convenções que precisamos entender não lida com matemática pesada, mas com a forma como o computador aprendeu a ler e escrever conosco: o texto.
Este artigo percorre essas convenções fundamentais: os padrões para representar
texto (ASCII, Unicode, UTF-8), os três métodos para inteiros com sinal (e por
que o complemento a dois dominou), os deslocamentos de bits e o padrão IEEE 754
para números reais. Entender essas representações é essencial para compreender
por que 0.1 + 0.2 ≠ 0.3 em programação e como números negativos funcionam em
hardware.
Se você já leu “Do Zero ao Float”, pode passar por cima
Boa parte deste artigo retoma o que a série Do Zero ao Float cobre com muito mais profundidade: bases numéricas, complemento a dois, overflow, deslocamentos e IEEE 754. A repetição é deliberada — esta série precisa ser autocontida, e quem chegou aqui direto não deveria ter de sair para entender o resto. Mas se você vem de lá, a leitura útil é seletiva: as seções de caracteres e de representação de instruções na memória são novas, e o resto funciona como revisão rápida.
Este artigo, então, serve como um resumo integrado desses conceitos, com foco na perspectiva da arquitetura de computadores.
Representação de caracteres #
O primeiro problema resolvido pelos computadores não foi o cálculo — foi a comunicação: como representar letras, dígitos e símbolos como bits? Para isso, o computador usa uma codificação de caracteres (character encoding): uma convenção que associa símbolos a números.
É importante separar três ideias que às vezes aparecem misturadas:
- código de caracteres: a tabela de símbolos;
- ponto de código: o número abstrato associado a um caractere;
- codificação: a forma concreta de armazenar esse ponto de código em bytes.
| Sistema | Natureza | Observação |
|---|---|---|
| ASCII | Código de caracteres de 7 bits | 128 símbolos; base histórica do texto em sistemas modernos |
| EBCDIC | Código de caracteres de 8 bits | Usado historicamente em ambientes IBM |
| Latin-1 (ISO 8859-1) | Código de caracteres de 8 bits | Extensão para línguas ocidentais |
| Unicode | Repertório universal de pontos de código | Define os caracteres; não define sozinho como armazená-los |
| UTF-8 / UTF-16 / UTF-32 | Codificações Unicode | Formas de armazenar pontos de código em bytes |
ASCII, Latin-1 e o 8º bit #
O ASCII (American Standard Code for Information Interchange) usa 7 bits e representa 128 símbolos. Ele inclui:
- caracteres de controle (
0a31); - caracteres imprimíveis (
32a127), como letras, dígitos e pontuação.
Historicamente, em muitos sistemas o 8º bit do byte podia ser usado como bit de paridade para detectar erros de transmissão. Em outros contextos, esse bit passou a ser aproveitado para extensões de 8 bits, como o Latin-1, permitindo representar caracteres acentuados e símbolos adicionais.
Vale ver a tabela funcionando em números concretos, porque é aqui que a codificação deixa de ser abstração:
| Caractere | Decimal | Hexadecimal | Binário |
|---|---|---|---|
'0' |
48 | 0x30 |
0011 0000 |
'9' |
57 | 0x39 |
0011 1001 |
'A' |
65 | 0x41 |
0100 0001 |
'Z' |
90 | 0x5A |
0101 1010 |
'a' |
97 | 0x61 |
0110 0001 |
'z' |
122 | 0x7A |
0111 1010 |
Duas coisas saltam dessa tabela. A primeira é que os dígitos começam em 0x30, o
que torna a conversão de caractere para número uma subtração: '7' - '0' = 7. A
segunda é mais bonita, e é exatamente o tema deste artigo:
Maiúscula e minúscula do mesmo caractere diferem por um único bit — o bit 5.
'A' é 0100 0001 e 'a' é 0110 0001; muda o bit de peso 32 e mais nada. É por isso
que trocar a caixa de uma letra ASCII não precisa de tabela nenhuma, só de uma
operação bit a bit: c ^ 0x20 alterna entre maiúscula e minúscula, c | 0x20
força minúscula e c & 0xDF força maiúscula. A tabela ASCII não foi ordenada por
acaso; essa regularidade foi projetada.
Unicode e codificações UTF #
O Unicode não deve ser entendido como uma codificação fixa de 16 bits, mas
como um repertório universal de pontos de código. Seu espaço de códigos vai
de U+0000 até U+10FFFF.
Para armazenar esses pontos de código em memória ou em arquivos, usamos codificações como:
| Codificação | Comprimento | Característica principal |
|---|---|---|
| UTF-8 | 1 a 4 bytes | Compatível com ASCII nos primeiros 128 códigos |
| UTF-16 | 2 ou 4 bytes | Usa 1 unidade de 16 bits no BMP e pares substitutos fora dele |
| UTF-32 | 4 bytes | Um ponto de código por unidade de 32 bits |
Assim, o correto é pensar:
- Unicode = repertório de caracteres;
- UTF-8 / UTF-16 / UTF-32 = maneiras de codificar esse repertório.
UTF-8 domina a prática moderna
O UTF-8 se tornou a codificação dominante porque preserva total compatibilidade com ASCII nos primeiros 128 códigos e usa comprimento variável apenas quando necessário. Para arquivos de texto, protocolos e páginas web, ele é hoje a escolha padrão.
Como o UTF-8 organiza os bits #
Dizer que o UTF-8 usa “1 a 4 bytes” deixa de fora a parte interessante: como o programa sabe quantos bytes ler. O esquema é uma convenção de bits iniciais, e é a mesma ideia de campo de bits que o artigo inteiro vem tratando:
| Faixa de pontos de código | Bytes | Padrão de bits |
|---|---|---|
U+0000–U+007F |
1 | 0xxxxxxx |
U+0080–U+07FF |
2 | 110xxxxx 10xxxxxx |
U+0800–U+FFFF |
3 | 1110xxxx 10xxxxxx 10xxxxxx |
U+10000–U+10FFFF |
4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
Os x são os bits do ponto de código, preenchidos da direita para a esquerda. O
resto é sinalização: um byte que começa com 0 é ASCII puro; um que começa com 110
anuncia “sou o primeiro de dois”; e todo byte de continuação começa com 10.
Daí sai a propriedade que fez o UTF-8 ganhar: ele é auto-sincronizável. Como
nenhum byte de continuação pode ser confundido com um byte inicial, um programa que
cai no meio de um texto consegue achar o começo do próximo caractere andando para
trás até encontrar um byte que não comece com 10. Nenhuma codificação de
comprimento variável anterior tinha isso.
Um exemplo com o ç, ponto de código U+00E7:
U+00E7em binário é1110 0111— 8 bits, então cai na faixa de 2 bytes;- os 11 bits do gabarito recebem
000 1110 0111; - primeiro byte:
110+00011=1100 0011=0xC3; - segundo byte:
10+100111=1010 0111=0xA7.
Ou seja, ç em UTF-8 são os bytes 0xC3 0xA7 — e é por isso que um arquivo UTF-8
lido como Latin-1 mostra ç no lugar do ç: os dois bytes aparecem como dois
caracteres separados.
Para quem quiser a história completa dessa confusão, a referência canônica é The Absolute Minimum Every Software Developer Must Know About Unicode, de Joel Spolsky.
Inteiros sem sinal #
Para inteiros sem sinal (unsigned), a representação é direta: cada bit corresponde a uma potência de 2, do LSB (bit menos significativo, \(b_0\)) ao MSB (bit mais significativo):
$$N_{10} = \sum_{i=0}^{n-1} b_i \cdot 2^i$$Exemplo: \(10110101_2\):
$$= 1\cdot2^7 + 0\cdot2^6 + 1\cdot2^5 + 1\cdot2^4 + 0\cdot2^3 + 1\cdot2^2 + 0\cdot2^1 + 1\cdot2^0 = 128 + 32 + 16 + 4 + 1 = 181_{10}$$Conversão binário ↔ hexadecimal #
O hexadecimal funciona como uma notação compacta para binário: agrupe os bits de 4 em 4, da direita para a esquerda, e converta cada grupo para seu dígito hexadecimal equivalente (0–9, A–F).
| Binário | Grupos de 4 | Hexadecimal | Decimal |
|---|---|---|---|
01011010 |
0101 + 1010 |
5A |
90 |
11110011 |
1111 + 0011 |
F3 |
243 |
Verificação: \(\text{5A}_{16} = 5 \times 16 + 10 = 80 + 10 = 90_{10}\) ✓
Inteiros com sinal #
Representar números negativos exige uma convenção adicional. Ao longo da história, três métodos foram usados:
Sinal e magnitude #
O MSB indica o sinal (0 = positivo, 1 = negativo); os demais \(n-1\) bits
representam o módulo. Intervalo: \(-(2^{n-1}-1)\) a \(+(2^{n-1}-1)\). O problema
fatal: dois zeros — \(+0 = 0000\ 0000\) e \(-0 = 1000\ 0000\) — complicam
circuitos de comparação e aritmética.
Complemento de 1 (C1) #
O negativo de um número é obtido invertendo todos os bits. O resultado de \(-5\) em 8 bits: \(+5 = 0000\ 0101 \Rightarrow -5 = 1111\ 1010\). A aritmética fica mais simples do que no sinal e magnitude, mas o problema de dois zeros permanece (\(0000\ 0000\) e \(1111\ 1111\)). O C1 raramente é usado em sistemas modernos.
Complemento de 2 (C2) — o padrão moderno #
O negativo é obtido invertendo todos os bits e somando 1 ao resultado. O C2 tem apenas um zero, e a subtração se reduz a uma adição — o hardware da UAL precisa de apenas um somador para realizar as duas operações.
$$\text{Intervalo:} \quad -2^{n-1} \leq x \leq +(2^{n-1}-1)$$| \(n\) bits | Mínimo | Máximo |
|---|---|---|
| 8 | \(-128\) | \(+127\) |
| 16 | \(-32.768\) | \(+32.767\) |
| 32 | \(-2.147.483.648\) | \(+2.147.483.647\) |
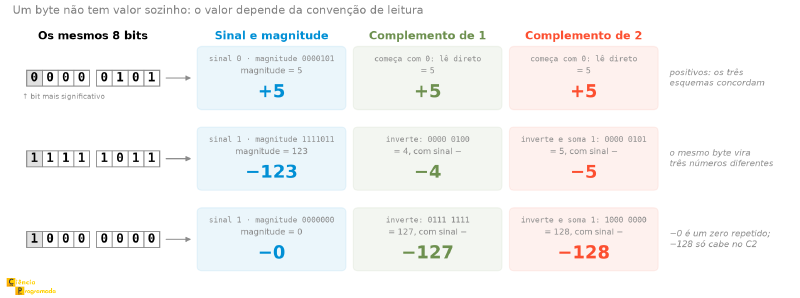
Com os três métodos definidos, vale vê-los lendo exatamente os mesmos bits. A figura
abaixo faz isso com três bytes. O primeiro, positivo, dá o mesmo valor nos três
esquemas. O segundo mostra o ponto central deste artigo: o mesmo byte vira três números
diferentes, porque o valor não está nos bits, está na convenção usada para lê-los. E o
terceiro, 1000 0000, é o caso-limite: um zero repetido no sinal e magnitude, o menor
negativo do complemento de 1, e o \(-128\) que só o complemento de 2 consegue
representar.
Por que o complemento a 2 é o padrão?
Quatro razões concretas fazem do C2 o padrão universal:
- Subtração = adição: \(A - B = A + C2(B)\) — a UAL precisa apenas de um somador.
- Zero único: sem ambiguidade entre \(+0\) e \(-0\).
- Extensão de sinal trivial: para levar um número de 8 para 16 bits, basta repetir o bit de sinal à esquerda. \(11111011\) (\(-5\)) vira \(1111111111111011\), e continua valendo \(-5\). O complemento de 1 também tem essa propriedade; no sinal e magnitude, estender exige mover o bit de sinal de lugar.
- Comparação com os mesmos circuitos do inteiro sem sinal: somar, subtrair e comparar magnitudes usam exatamente o mesmo hardware que a versão unsigned — o que muda é apenas a interpretação das flags. Não há um segundo conjunto de circuitos para números com sinal.
O intervalo assimétrico (\(-128\) a \(+127\) em 8 bits) é às vezes listado como mais uma vantagem, mas não é: é consequência de ter só um zero. Com \(2^8\) padrões e um deles gasto no zero, sobram 255 para distribuir entre positivos e negativos, e a divisão não pode ser simétrica. E longe de ser vantagem, é a origem de um bug clássico: \(-128\) não tem oposto representável, então negar \(-128\) em 8 bits devolve \(-128\).
Operações em complemento a 2 #
Como calcular o C2 de um número (negação) #
O algoritmo tem três passos:
- Escrever o número em binário
- Inverter todos os bits (obter o complemento de 1)
- Somar 1 ao resultado
| Passo | Bits |
|---|---|
| \(+5\) em binário | 0000 0101 |
| Inverter todos os bits (C1) | 1111 1010 |
| Somar 1 → resultado | 1111 1011 = \(-5\) ✓ |
Verificação (\(+5 + (-5)\) deve ser zero):
$$0000\ 0101 + 1111\ 1011 = \underbrace{1}_{\text{carry}}\ 0000\ 0000 \xrightarrow{\text{descarta carry}} 0000\ 0000 = 0 \ \checkmark$$Subtração como adição: \(A - B = A + C2(B)\) #
Para entender como isso funciona na prática, vamos simular a operação 5 - 3.
Seguindo a fórmula acima, definimos \(A = 5\) e \(B = 3\). Em vez de usar um
circuito dedicado para subtrair, a CPU calcula o complemento de dois de 3
(obtendo a representação em bits de -3) e soma esse valor diretamente ao
número 5. A tabela a seguir detalha esse processo passo a passo usando 8 bits:
| Passo | Operação | Resultado |
|---|---|---|
| Representar \(+3\) | binário | 0000 0011 |
| Inverter bits (C1) | 1111 1100 |
|
| Somar 1 → \(C2(3) = -3\) | 1111 1101 |
|
| Somar \(5 + (-3)\) | 0000 0101 + 1111 1101 |
\(\underbrace{1}_{\text{carry}}\ 0000\ 0010\) |
| Descartar carry | 0000 0010 = \(2\) ✓ |
Exemplo — Adição, subtração e overflow em 8 bits
Considere \(A = 00110010_2 = +50_{10}\) e \(B = 11010000_2\). Para determinar o valor de B: como o MSB é 1, é negativo. \(C2(B) = 00110000_2 = 48\), portanto \(B = -48_{10}\).
a) \(A + B\): \(00110010 + 11010000 = 1\ 00000010_2\) → descarta carry → \(00000010_2 = +2_{10}\) ✓ (\(50 + (-48) = +2\) — sinais opostos nunca geram overflow)
b) \(B - A = B + C2(A)\): \(C2(A)\): inverter \(00110010 = 11001101\) + 1 = \(11001110_2\) \(11010000 + 11001110 = 1\ 10011110_2\) → descarta carry → \(10011110_2\) MSB=1 → negativo: \(C2(10011110) = 01100010 = 98\) → resultado = \(-98_{10}\) (\(-48 - 50 = -98\) ✓ — dentro do intervalo \([-128, +127]\))
c) Dois positivos podem somar para um resultado negativo? Sim — isso é exatamente o overflow. Exemplo: \(C = 01000001_2 = +65\) e \(D = 01100000_2 = +96\): \(C + D = 10100001_2\) → MSB=1 → interpretado como negativo (\(-95\)), mas \(65 + 96 = 161 > 127\) → overflow ❌
Detectando overflow #
Overflow em complemento a 2
O overflow ocorre quando o resultado correto não cabe no número de bits disponíveis:
- Dois positivos somados → resultado negativo = overflow ❌
- Dois negativos somados → resultado positivo = overflow ❌
- Positivo + Negativo → nunca gera overflow ✓
Regra de hardware: overflow ocorre quando o carry de entrada no bit de sinal é diferente do carry de saída do bit de sinal.
Caso essa parte do overflow tenha sido difícil para você, temos todo um artigo dedicado a isso na série Do Zero ao Float, onde explicamos o conceito de overflow em detalhes, com exemplos e exercícios.
Deslocamentos de bits (shifts) #
Essa eficiência estrutural do Complemento a 2 não se limita apenas à facilidade de somar números negativos; ela permite que o hardware utilize “atalhos” matemáticos. A operação mais eficiente possível para multiplicar ou dividir por potências de 2 não aciona somadores complexos, mas sim os deslocamentos de bits (shifts) — uma operação resolvida “empurrando” bits para os lados em um único ciclo de UAL.
| Operação | Efeito matemático | Bit inserido |
|---|---|---|
| Deslocamento à esquerda (1 bit) | Multiplica por 2 | 0 à direita |
| Deslocamento lógico à direita (1 bit) | Divide por 2 (inteiro sem sinal) | 0 à esquerda |
| Deslocamento aritmético à direita (1 bit) | Divide por 2 (inteiro com sinal) | Réplica do MSB (bit de sinal) |
A réplica do MSB funciona da seguinte forma: se o número é positivo (MSB = 0), o
deslocamento à direita preenche com 0, mantendo o resultado positivo. Se o
número é negativo (MSB = 1), o deslocamento preenche com 1, preservando o
sinal negativo. Isso faz com que o deslocamento aritmético à direita se comporte
como uma divisão inteira por 2, arredondando para baixo, mesmo para números
negativos. Por exemplo: \(-3\) em 8 bits é 1111 1101. Deslocar à direita aritmeticamente resulta em
1111 1110, pois o MSB é 1, indicando um número negativo, e 1 é inserido à
esquerda para manter o sinal. O resultado é \(-2\), que é o resultado esperado
de \(-3\) dividido por 2, arredondando para baixo.
Exemplos em 8 bits:
| Operação | Antes | Depois | Valor |
|---|---|---|---|
| Shift esquerdo | 0000 0011 (3) |
0000 0110 |
6 = 3 × 2 ✓ |
| Shift lógico direito | 0000 0110 (6) |
0000 0011 |
3 = 6 ÷ 2 ✓ |
| Shift aritmético direito | 1111 0000 (−16) |
1111 1000 |
−8 = −16 ÷ 2 ✓ |
Deslocamento aritmético à direita: cuidado com a interpretação #
O deslocamento aritmético à direita é frequentemente apresentado como uma forma rápida de “dividir por 2” inteiros com sinal. Isso é útil como intuição, mas merece uma observação:
- para inteiros sem sinal, o deslocamento lógico à direita equivale à divisão inteira por 2;
- para inteiros com sinal em complemento a 2, o deslocamento aritmético à direita preserva o bit de sinal, o que faz o resultado se comportar como um arredondamento para baixo em muitos casos negativos.
Vale então enunciar com cuidado: o deslocamento aritmético à direita é uma operação
de hardware que, em complemento a 2, costuma corresponder à divisão inteira por
potência de 2, preservando o sinal. “Costuma” porque o arredondamento não é o mesmo
da divisão da linguagem: o deslocamento arredonda para baixo (na direção de
\(-\infty\)), enquanto o operador de divisão inteira de muitas linguagens arredonda
na direção do zero. Para \(-13\) em 8 bits, o deslocamento de 2 bits dá \(-4\); em
C, -13 / 4 dá \(-3\).
Dica: aritmético × lógico
Use shift aritmético à direita para dividir inteiros com sinal
(replica o bit de sinal, preservando-o). Use shift lógico para inteiros
sem sinal (preenche com 0). Deslocar à esquerda multiplica por 2 em ambos
os casos — basta garantir que não há overflow.
Exemplo — Divisão por 2 repetida com deslocamento aritmético
Considere \(A = 01011110_2 = +94_{10}\) e \(B = 10011101_2 = -99_{10}\).
Dividindo A (positivo) por 2 com shift aritmético à direita: \(01011110 \to 00101111 = 47 \to 00010111 = 23 \to 00001011 = 11 \to 00000101 = 5 \to 00000010 = 2 \to 00000001 = 1 \to 00000000 = 0\) Cada step divide por 2 (truncando), até atingir zero.
Dividindo B (negativo) por 2: o shift aritmético replica o bit de sinal (MSB=1), preservando o sinal negativo: \(10011101 \to 11001110 = -50 \to 11100111 = -25 \to 11110011 = -13 \to 11111001 = -7 \to 11111100 = -4 \to 11111110 = -2 \to 11111111 = -1 \to 11111111 = -1\) Para números negativos, o processo converge para −1 (não para zero), pois o bit de sinal nunca é eliminado.
Ponto flutuante: o padrão IEEE 754 #
Embora os inteiros em Complemento a 2 sejam perfeitos para contagens exatas e manipulação de memória, o mundo físico — com suas distâncias microscópicas e grandezas astronômicas — exige uma flexibilidade que os bits fixos não conseguem oferecer. Para grandezas contínuas, precisamos de números reais aproximados. O ponto flutuante resolve isso utilizando uma notação científica normalizada em base 2:
$$(-1)^S \times 1{,}\text{mantissa} \times 2^E$$onde \(S\) é o bit de sinal (0 = positivo, 1 = negativo), \(E\) é o expoente inteiro e a mantissa são os bits fracionários após o 1. implícito.
Mas de onde vêm as regras para guardar isso em bits? Historicamente, cada fabricante de computador criava seu próprio jeito de representar números de ponto flutuante, o que causava um caos: um mesmo cálculo científico dava resultados diferentes dependendo de qual marca de computador o executasse. Para unificar a indústria, o IEEE (Institute of Electrical and Electronics Engineers — a principal organização mundial de padronização para engenharia elétrica e computação) publicou em 1985 a norma IEEE 754.
O padrão IEEE 754 original definiu com exatidão os formatos básicos de precisão simples e dupla, estabelecendo apenas requisitos mínimos para formatos “estendidos”. A tabela a seguir mostra os formatos de 32 e 64 bits definidos na norma, além do famoso formato extended de 80 bits (uma implementação específica da Intel/x86 que atende aos requisitos de formato estendido da norma):
| Precisão | Sinal | Expoente | Mantissa | Total | Bias |
|---|---|---|---|---|---|
| Single (32 bits) | 1 bit | 8 bits | 23 bits | 32 bits | 127 |
| Double (64 bits) | 1 bit | 11 bits | 52 bits | 64 bits | 1.023 |
| Extended (80 bits) | 1 bit | 15 bits | 64 bits | 80 bits | 16.383 |
O expoente é armazenado com bias (viés): o valor real é o armazenado menos
o bias, permitindo representar expoentes negativos sem bit de sinal próprio. O
bit 1 à esquerda do ponto é implícito no single e double — não precisa ser
armazenado, adicionando um bit extra de precisão efetiva (24 bits no single, 53
bits no double). Já no formato extended (80 bits), esse bit inteiro inicial é
explícito e precisa ser armazenado, ocupando um espaço real e resultando em
exatos 64 bits de precisão na mantissa. Hoje em dia, o formato extended de 80
bits é amplamente considerado legado: ele era o padrão interno dos antigos
coprocessadores matemáticos (x87 FPU) da arquitetura x86. Processadores modernos
geralmente realizam cálculos de ponto flutuante usando registradores vetoriais
(SSE/AVX) otimizados para os formatos single e double. Contudo, o extended
ainda é suportado nos processadores atuais por questões de retrocompatibilidade
(sendo frequentemente mapeado para o tipo long double em compiladores C/C++ na
arquitetura x86).
Abaixo, a estrutura de bits para o formato de precisão simples (32 bits) do IEEE 754, onde o bit de sinal é o mais significativo (MSB), seguido pelo expoente com bias e pela mantissa fracionária:
 31  30        23 22                       0
 ┌───┬──────────┬──────────────────────────┐
 │ S │ Expoente │        Mantissa          │
 │ 1 │  8 bits  │         23 bits          │
 └───┴──────────┴──────────────────────────┘
Casos especiais #
O IEEE 754 reserva padrões específicos para situações limite:
| Expoente | Mantissa | Significado |
|---|---|---|
00000000 |
000...0 |
Zero (\(\pm 0\)) |
00000000 |
\(\neq 0\) | Número denormalizado (subnormal) |
11111111 |
000...0 |
\(\pm\infty\) |
11111111 |
\(\neq 0\) | NaN (Not a Number) |
O vácuo perto do zero e o Underflow
Se você observar a matemática do IEEE 754, perceberá que existe um “salto” de
precisão considerável entre o menor número normalizado possível e o zero
absoluto. Para evitar que cálculos percam a precisão abruptamente e desabem
para zero ao lidar com valores atômicos (um problema conhecido como
underflow), o padrão introduziu os números denormalizados. Eles abrem
mão do 1. implícito na mantissa para conseguir representar valores
absurdamente pequenos (como \(1,4 \times 10^{-45}\) na precisão simples),
preenchendo esse “vácuo” com uma degradação suave de precisão.
Convertendo para IEEE 754 single precision #
flowchart TD
    A["Número decimal com sinal"] --> B["1. Converter para binário"]
    B --> C["2. Normalizar: 1.xxx × 2^E"]
    C --> D["3. Bit de sinal S
0 = positivo, 1 = negativo"]
    C --> Exp["4. Expoente com bias
E_real + 127"]
    C --> Mant["5. Mantissa
bits após o 1 implícito
(completar com zeros à direita)"]
    D --> R["Resultado: S | Expoente | Mantissa"]
    Exp --> R
    Mant --> R
Aplicando ao exemplo \(-5{,}75\):
| Passo | Operação | Resultado |
|---|---|---|
| 1. Converter para binário | \(5 = 101_2\); \(0{,}75 \times 2 = 1{,}50\) → 1; \(0{,}5 \times 2 = 1{,}0\) → 1 | \(-101{,}11_2\) |
| 2. Normalizar | Mover ponto 2 posições à esquerda | \(-1{,}0111 \times 2^2\) |
| 3. Bit de sinal | Negativo | 1 |
| 4. Expoente com bias | \(E_{\text{real}} = 2\); \(2 + 127 = 129\) | \(10000001_2\) |
| 5. Mantissa | Bits após 1.: 0111, completar com zeros |
01110000000000000000000 |
| Resultado final | 1 10000001 01110000000000000000000 |
Verificação:
$$(-1)^1 \times 1{,}0111_2 \times 2^{129-127} = -1{,}0111_2 \times 2^2 = -101{,}11_2 = -5{,}75_{10} \ \checkmark$$
Exemplo — Decodificando um formato personalizado de 16 bits
Um formato de 16 bits usa: 1 bit de sinal, 5 bits de expoente com bias 15, e 10 bits de mantissa (normalizado — parte inteira implícita = 1).
Esse formato não é hipotético: é o binary16, ou half precision, do próprio
IEEE 754 — e é o que as GPUs usam para treinar e executar modelos de aprendizado de
máquina, onde metade da precisão em troca de metade da memória e do dobro da banda é
um bom negócio.
Dado o padrão BA32₁₆ = 1011 1010 0011 0010₂:
- Sinal:
1→ negativo - Expoente:
01110₂ = 14→ \(E_{\text{real}} = 14 - 15 = -1\) - Mantissa:
1000110010₂
Valor: \(-(1{,}1000110010_2) \times 2^{-1}\)
Convertendo a mantissa: \(1 + 2^{-1} + 2^{-5} + 2^{-6} + 2^{-9} = 1 + 0{,}5 + 0{,}03125 + 0{,}015625 + 0{,}001953\ldots \approx 1{,}5488\)
Resultado: \(-1{,}5488 \times 0{,}5 \approx -0{,}7744\)
Maior valor positivo normalizado: expoente = 11110₂ = 30 → \(E = 15\); mantissa = 1111111111₂ → \(1{,}1111111111_2 \times 2^{15} = 65504\)
Menor valor positivo normalizado: expoente = 00001₂ = 1 → \(E = -14\); mantissa = 0000000000₂ → \(1{,}0 \times 2^{-14} \approx 0{,}000061\)
Exemplo — Decodificando um número IEEE 754
Número com: sinal = 0 (positivo), mantissa = 1100100₂, expoente real = −3.
Número normalizado: \(+(1{,}1100100)_2 \times 2^{-3}\)
Convertendo a mantissa: \(1 + 2^{-1} + 2^{-2} + 2^{-5} = 1 + 0{,}5 + 0{,}25 + 0{,}03125 = 1{,}78125\)
Resultado: \(1{,}78125 \times 2^{-3} = 1{,}78125 / 8 = \mathbf{0{,}222656}\)
Aprofundamento: a série “Do Zero ao Float”
O padrão IEEE 754 tem muitas nuances além do que cobrimos aqui:
arredondamento, números subnormais, operações especiais e as armadilhas de
comparar floats. Se você quiser explorar esses tópicos em profundidade —
incluindo por que 0.1 + 0.2 ≠ 0.3 em praticamente toda linguagem de
programação — a série Do Zero ao Float
cobre tudo isso com diversos exemplos.
Bônus Python: inspecionando representações de bits #
Python oferece ferramentas diretas para inspecionar como números são armazenados
em bits, usando o módulo struct (para ponto flutuante) e os operadores << e
>> (para inteiros).
import struct

# Representação IEEE 754 single precision de -5.75
raw = struct.pack(">f", -5.75)          # ">f" = big-endian single float
print(f"-5.75 como bytes : {raw.hex()}")
# c0b80000

bits = int.from_bytes(raw, "big")
print(f"Em binário (32)  : {bits:032b}")
# 11000000101110000000000000000000
# S=1 | Exp=10000001 | Mant=01110000000000000000000 ✓

# Desempacotando de volta
valor = struct.unpack(">f", raw)[0]
print(f"De volta ao float: {valor}")
# -5.75 ✓

# Shifts e complemento a 2 com inteiros Python
a = 0b00110010  # +50 em decimal
b = 0b11010000  # em 8 bits sem sinal = 208, em C2 = -48

print(f"\na = {a}  ({a:08b})")
print(f"a << 1 = {a << 1}  ({a<<1:08b})  (× 2)")
print(f"a >> 1 = {a >> 1}  ({a>>1:08b})  (÷ 2)")

# Complemento a 2 em Python (Python usa inteiros de precisão arbitrária)
def c2_negacao(n: int, bits: int = 8) -> int:
    """Retorna -n em representação complemento a 2 com 'bits' bits."""
    mascara = (1 << bits) - 1          # 0xFF para 8 bits
    return (~n & mascara) + 1

print(f"\n-50 em C2 (8 bits) : {c2_negacao(50):08b} = {c2_negacao(50)}")
# 11001110 = 206 (em unsigned) ou -50 (em C2)

# Adição com truncamento para 8 bits
def soma_c2(a: int, b: int, bits: int = 8) -> int:
    mascara = (1 << bits) - 1
    return (a + b) & mascara

print(f"50 + (-48) em 8 bits: {soma_c2(a, b):08b} = {soma_c2(a, b)}")
# 00000010 = 2 ✓

# Verificando -5.75 como double (64 bits)
raw64 = struct.pack(">d", -5.75)
bits64 = int.from_bytes(raw64, "big")
print(f"\n-5.75 double (64 bits): {bits64:064b}")
# 1 10000000001 0111000000000000000000000000000000000000000000000000
Conclusão e próximos artigos #
Bits sozinhos não têm significado — o significado emerge da convenção de interpretação. O ASCII transforma 7 bits em um caractere; o complemento a dois transforma um padrão de bits em um inteiro negativo; o IEEE 754 transforma 32 bits em um número fracionário de precisão. Entender essas convenções é entender como o computador funciona.
No próximo artigo, vamos explorar a representação de instruções de máquina — como os padrões de bits que compõem as instruções que a CPU executa, os diferentes formatos de instrução e os modos de endereçamento que determinam onde buscar os operandos. Compreender a representação de dados é o passo fundamental para entender a representação de instruções, pois as instruções também são apenas padrões de bits, mas com uma estrutura específica que o hardware interpreta para realizar operações.
Até lá!


