
No artigo anterior — Execução de Programas — descrevemos um pipeline clássico de compilação com seis etapas: análise léxica, sintática, semântica, geração de código intermediário, otimização e geração de código objeto. O Python tem algo raro do ponto de vista didático: ele expõe várias etapas importantes desse processo por meio de módulos da biblioteca padrão. Não de forma perfeitamente separada como em um compilador teórico, mas o suficiente para tornar concreta boa parte da teoria.
Vamos usar a mesma expressão do artigo anterior como fio condutor:
x = y + z * 2Cada seção se inspira em uma dessas etapas, buscando uma correspondência didática com ferramentas expostas pelo CPython.
Escopo real deste artigo
Este artigo faz uma ponte entre a teoria de compiladores e as ferramentas de
introspecção do CPython. Algumas etapas aparecem de forma muito nítida
(tokenize, ast, compile, dis); outras aparecem apenas de forma
indireta ou parcial. Portanto, o objetivo aqui não é afirmar que o Python
expõe publicamente “as seis fases” de um compilador clássico de forma
isolada, e sim mostrar como várias dessas transformações podem ser observadas
na prática.
Aliás, é comum ouvirmos que “Python é uma linguagem interpretada”, mas isso é apenas meia verdade. Na implementação padrão (CPython), o código não é lido e executado linha a linha diretamente do texto original. Antes de executar qualquer instrução, o Python compila o seu código-fonte para um formato intermediário de mais baixo nível chamado bytecode. Só então esse bytecode é interpretado por uma máquina virtual interna (a Python Virtual Machine — PVM). É exatamente esse processo de compilação silenciosa que vamos dissecar agora.
Fase 1 — Análise léxica: o módulo tokenize
#
A primeira fase transforma o código-fonte em uma sequência de tokens. O módulo
tokenize faz exatamente o que um analisador léxico real faz — e permite
inspecionar o resultado:
import tokenize
import io

codigo = "x = y + z * 2"

tokens = tokenize.generate_tokens(io.StringIO(codigo).readline)
for tok in tokens:
    print(tok)
Saída (simplificada):
TokenInfo(type=1 (NAME),   string='x',  ...)   # identificador
TokenInfo(type=55 (OP),    string='=',  ...)   # operador
TokenInfo(type=1 (NAME),   string='y',  ...)
TokenInfo(type=55 (OP),    string='+',  ...)
TokenInfo(type=1 (NAME),   string='z',  ...)
TokenInfo(type=55 (OP),    string='*',  ...)
TokenInfo(type=2 (NUMBER), string='2',  ...)
TokenInfo(type=4 (NEWLINE),string='\n', ...)
TokenInfo(type=0 (ENDMARKER), ...)
Os números dos tipos de token mudam entre versões
O mesmo alerta que este artigo faz sobre o bytecode vale aqui: token.OP vale 55
no Python 3.12, mas valia 54 no 3.11 e anteriores, porque o 3.12 acrescentou tipos
de token novos no meio da numeração. Os demais desta saída são estáveis há muito tempo
(NAME = 1, NUMBER = 2, NEWLINE = 4, ENDMARKER = 0), mas depender de qualquer um
deles por número é frágil.
A segunda versão do código, logo abaixo, é imune a isso: ela usa token.tok_name para
traduzir o número em nome, que é a forma correta de escrever código que sobrevive a
uma atualização do interpretador.
Compare com o que descrevemos na teoria em artigos anteriores:
Entrada:  x = y + z * 2
Tokens:   [ID: x] [OP: =] [ID: y] [OP: +] [ID: z] [OP: *] [NUM: 2]
O tokenize produz exatamente essa lista — mais metadados de posição (linha e
coluna) que seriam usados para mensagens de erro precisas.
# Versão mais legível: mostrar apenas tipo e valor
import tokenize, io, token

codigo = "x = y + z * 2"
for tok in tokenize.generate_tokens(io.StringIO(codigo).readline):
    if tok.type not in (token.NEWLINE, token.NL, token.ENDMARKER, token.ENCODING):
        print(f"{token.tok_name[tok.type]:10} | {tok.string!r}")
NAME | 'x'
OP | '='
NAME | 'y'
OP | '+'
NAME | 'z'
OP | '*'
NUMBER | '2'Fase 2 — Análise sintática: o módulo ast
#
A segunda fase organiza os tokens em uma estrutura hierárquica que reflete a
gramática da linguagem — a Árvore de Sintaxe Abstrata (AST). O módulo
ast expõe diretamente essa estrutura:
import ast

codigo = "x = y + z * 2"
arvore = ast.parse(codigo)

print(ast.dump(arvore, indent=2))
Saída (simplificada):
Module(
  body=[
    Assign(
      targets=[Name(id='x')],
      value=BinOp(
        left=Name(id='y'),
        op=Add(),
        right=BinOp(
          left=Name(id='z'),
          op=Mult(),
          right=Constant(value=2)
        )
      )
    )
  ]
)
Compare com a árvore desenhada no artigo anterior, aqui em forma de texto:
        assign
       /      \
      x         +
               / \
              y   *
                 / \
                z   2
São a mesma estrutura — ast.dump é apenas a versão serializada da árvore. O
BinOp com Mult aparece mais fundo que o BinOp com Add, capturando a
precedência de * sobre +.
Transformando a AST antes da compilação #
O módulo ast permite não apenas inspecionar, mas transformar a árvore
antes de compilar — a base de ferramentas como linters, formatadores e
otimizadores. Podemos, por exemplo, criar um script que varre a árvore
procurando multiplicações por potências de 2 e as substitui por deslocamentos de
bits (shifts). Como vimos no artigo sobre O Processador Hipotético, a UAL resolve shifts de forma
muito mais rápida do que usando somadores complexos:
import ast

class SubstituirMultiplicacaoPorShift(ast.NodeTransformer):
    """
    Substitui multiplicações por constantes que são potências de 2
    por deslocamentos à esquerda (mais eficientes).
    """
    def visit_BinOp(self, node):
        self.generic_visit(node)  # processa filhos primeiro
        if isinstance(node.op, ast.Mult) and isinstance(node.right, ast.Constant):
            n = node.right.value
            if isinstance(n, int) and n > 0 and (n & (n - 1)) == 0:
                shift = n.bit_length() - 1
                print(f"Otimizando: * {n} → << {shift}")
                return ast.BinOp(
                    left=node.left,
                    op=ast.LShift(),
                    right=ast.Constant(value=shift),
                )
        return node

codigo = "resultado = z * 4"
arvore = ast.parse(codigo)
arvore_otimizada = SubstituirMultiplicacaoPorShift().visit(arvore)
ast.fix_missing_locations(arvore_otimizada)

codigo_compilado = compile(arvore_otimizada, "<transformado>", "exec")
print(ast.dump(arvore_otimizada, indent=2))

# A prova de que a transformação chegou ao bytecode:
import dis
dis.dis(codigo_compilado)
Na saída do dis aparece um BINARY_OP 3 (<<) onde antes haveria
BINARY_OP 5 (*) — a árvore reescrita virou bytecode diferente, o que é a única
evidência que importa. Sem esse passo, o exemplo mostraria apenas que a AST mudou, não
que a mudança sobreviveu à compilação.
O que esse exemplo realmente mostra
Essa transformação com ast.NodeTransformer é um ótimo exemplo de reescrita
sintática da AST. Ela se parece com uma otimização de compilador, mas não
deve ser vendida aqui como uma “otimização real garantida de desempenho” em
Python. Em CPython, o custo de execução envolve objetos Python, dispatch
dinâmico e outros fatores que vão muito além da operação aritmética abstrata.
E há um problema mais sério: a transformação está errada
Não errada no código — errada como otimização. A reescrita
z * 4 → z << 2 só vale se z for inteiro. Se z for um float, z * 4
funciona perfeitamente e z << 2 levanta TypeError: unsupported operand type(s) for <<: 'float' and 'int'. O transformador só olha a sintaxe — vê uma
multiplicação por potência de 2 e reescreve — sem saber nada sobre o tipo de z.
E é exatamente esse o argumento de por que um compilador de verdade precisa da análise semântica antes de otimizar: é ela que descobre os tipos, e sem tipos não há como saber se uma reescrita preserva o significado do programa. A próxima seção é justamente sobre essa fase. Um otimizador que roda sem ela não otimiza: aposta.
Fase 3 — Semântica e verificações em runtime #
Em compiladores tradicionais, a análise semântica inclui tarefas como checagem de tipos, uso de nomes, compatibilidade de operações e consistência de escopo. No CPython, parte importante dessas verificações acontece em tempo de execução, e não como uma fase pública e separada da compilação.
Por isso, esta etapa deve ser entendida aqui de forma aproximada: o Python não expõe uma API pública de “análise semântica completa” comparável à de um compilador estático clássico.
Um exemplo útil é mostrar que certas expressões são aceitas sintaticamente, mas falham quando executadas:
# Verificação de tipo em tempo de execução (não compilação):
try:
    resultado = 3 + "5"
except TypeError as e:
    print(f"TypeError em execução: {e}")
    # TypeError em execução: unsupported operand type(s) for +: 'int' and 'str'
Também vale notar que ast.literal_eval() não é um analisador semântico
geral do Python. Ele apenas avalia com segurança estruturas literais simples,
como números, strings, listas, tuplas, dicionários, conjuntos, None e
booleanos.
import ast

# ast.literal_eval faz análise semântica segura de literais
# (sem executar código arbitrário — seguro para avaliar strings vindas do usuário)
try:
    resultado = ast.literal_eval("[1, 2, 3]")
    print(resultado)          # [1, 2, 3]
    print(type(resultado))    # <class 'list'>

    # Tentativa de avaliar expressão não-literal → ValueError
    ast.literal_eval("x + 1")  # ERRO: contém variável
except ValueError as e:
    print(f"Falha esperada: {e}")
A leitura correta desta fase, portanto, é:
- em compiladores clássicos: análise semântica explícita;
- em CPython: várias verificações semânticas relevantes aparecem no runtime.
Fase 4 — compile(): geração de objeto de código
#
A função compile() converte código-fonte Python — ou uma AST já construída —
em um objeto de código (code object). Esse objeto pode ser executado por
exec() ou eval().
Isso não deve ser interpretado como se o Python expusesse uma representação
intermediária clássica no estilo TAC (Three-Address Code). O objeto gerado
por compile() já está muito mais próximo da forma executável usada pela máquina
virtual do CPython do que de uma IR didática de compiladores.
# compile(source, filename, mode)
# mode: 'exec' para módulos, 'eval' para expressões, 'single' para REPL
obj = compile("x = y + z * 2", "<string>", "exec")

print(type(obj))           # <class 'code'>
print(obj.co_consts)       # constantes usadas: (2, None)
print(obj.co_names)        # nomes de variáveis globais: ('y', 'z', 'x')
print(obj.co_stacksize)    # tamanho máximo da pilha necessária
O objeto de código é a unidade executável interna do CPython — e é esse tipo de
objeto que pode ser serializado em arquivos .pyc para cache de carregamento.
Sobre escrever .pyc na mão
.pyc na mão
É tecnicamente possível serializar um objeto de código com o módulo marshal e
montar um .pyc manualmente, mas não vale a pena nem como demonstração. O formato
do marshal é específico do Python, deliberadamente não documentado em detalhe, e
muda entre versões; e o cabeçalho do .pyc começa com um magic number que
identifica a versão exata do interpretador — inventar esse número produz um arquivo
que o Python se recusa a importar.
Para observar .pyc na prática, o caminho é deixar o próprio Python gerar, que é o
que a seção a seguir faz.
Exemplo prático: deixando o próprio Python gerar o cache compilado #
Em vez de escrever manualmente um arquivo .pyc, o mais correto é deixar o
próprio Python gerar o cache automaticamente.
# Salve este conteúdo em um arquivo chamado exemplo_modulo.py:
#
# valor = 42
# def dobro(x):
#     return x * 2
#
# Depois, em outro arquivo Python ou no REPL:

import exemplo_modulo

print(exemplo_modulo.valor)       # 42
print(exemplo_modulo.dobro(10))   # 20
Após a importação, o Python tende a criar um diretório __pycache__/ com um
arquivo .pyc correspondente ao módulo, quando apropriado. Esse arquivo guarda
uma versão compilada em bytecode para acelerar carregamentos futuros.
Fase 5 — Algumas otimizações observáveis do compilador #
O CPython realiza algumas otimizações durante a compilação, mas elas não aparecem como uma “fase pública” separada e configurável do mesmo modo que em um compilador clássico. O exemplo mais fácil de observar aqui é o constant folding: expressões compostas apenas por constantes podem ser pré-calculadas em tempo de compilação.
import dis

# Sem constant folding: variáveis precisam ser resolvidas em runtime
codigo_vars = compile("resultado = y + z * 2", "<string>", "exec")

# Com constant folding: constantes puras são avaliadas na compilação
codigo_const = compile("resultado = 3 + 4 * 2", "<string>", "exec")

print("Com variáveis — constantes na AST:")
print(compile("y + z * 2", "<string>", "eval").co_consts)
# (2,)  ← só o literal 2 é constante

print("\nCom apenas constantes — após constant folding:")
print(compile("3 + 4 * 2", "<string>", "eval").co_consts)
# (11,)  ← Python pré-calculou 3 + 4*2 = 11 em tempo de compilação!
Por que o None aparece em exec e não em eval
None aparece em exec e não em eval
Compare com a seção anterior, onde
compile("x = y + z * 2", "<string>", "exec").co_consts devolveu (2, None). A
diferença é o modo. No modo exec, o objeto de código é um módulo, e todo módulo
termina implicitamente com return None — daí a constante extra. No modo eval, o
objeto de código é uma expressão, que devolve o próprio valor: não há retorno
implícito, e o None não aparece.
Vale saber disso porque a ordem e o conteúdo de co_consts já mudaram entre versões
do CPython, e é o tipo de detalhe em que um exemplo copiado de um texto antigo deixa
de bater com o que o interpretador mostra. Os valores aqui foram conferidos no
Python 3.12.
Fase 6 — Código objeto: o módulo dis
#
O módulo dis (disassembler) mostra as
instruções de bytecode que o CPython vai executar — a forma mais próxima que temos, em Python puro, de inspecionar o
código que a máquina virtual do CPython executará.
Importante: bytecode depende da versão do CPython
O módulo dis trabalha sobre o bytecode do CPython, e esse bytecode é um
detalhe de implementação. Ele pode mudar entre versões do Python e não deve
ser tratado como uma linguagem estável e portável entre VMs ou releases.
import dis

def calcular(y, z):
    x = y + z * 2
    return x

dis.dis(calcular)
Saída típica (Python 3.11+):
  2           0 RESUME                   0

  3           2 LOAD_FAST                0 (y)
              4 LOAD_FAST                1 (z)
              6 LOAD_CONST               1 (2)
              8 BINARY_OP               5 (*)
             12 BINARY_OP               0 (+)
             16 STORE_FAST               2 (x)

  4          18 LOAD_FAST                2 (x)
             20 RETURN_VALUE
Cada linha é uma instrução de bytecode: um opcode (como LOAD_FAST,
BINARY_OP) mais um argumento. Observe a correspondência com o TAC do artigo
anterior:
| Bytecode do CPython | Papel lógico aproximado |
|---|---|
LOAD_FAST y |
carrega y na pilha |
LOAD_FAST z |
carrega z na pilha |
LOAD_CONST 2 |
carrega a constante 2 |
BINARY_OP * |
combina z e 2 |
BINARY_OP + |
combina y com o resultado anterior |
STORE_FAST x |
armazena o resultado em x |
Essa tabela não pretende reproduzir um TAC clássico literalmente; ela só mostra a correspondência lógica aproximada entre o bytecode de pilha do CPython e as operações da expressão original.
A ordem pode parecer invertida, mas o CPython usa uma pilha de avaliação
(evaluation stack): cada LOAD empilha um valor; cada BINARY_OP desempilha
dois operandos, opera e empilha o resultado.
Arquitetura de Pilha vs. Registradores
Se você acompanhou nossos artigos sobre a CPU, deve lembrar que nosso processador hipotético usava um Acumulador ou Registradores para fazer contas. O interpretador CPython, no entanto, simula uma Máquina de Pilha (Stack Machine). Nela, não indicamos onde salvar o resultado de uma soma na própria instrução; as operações simplesmente pegam os dados que estão no topo da pilha, calculam, e colocam o resultado de volta no topo.
Inspecionando o bytecode de um módulo completo #
import dis, ast

# Pipeline completo: código-fonte → tokens → AST → bytecode
codigo_fonte = """
def soma_quadrados(a, b):
    return a**2 + b**2
"""

print("=== TOKENS ===")
import tokenize, io, token as tok_mod
for t in tokenize.generate_tokens(io.StringIO(codigo_fonte).readline):
    if t.type not in (tok_mod.NL, tok_mod.NEWLINE, tok_mod.ENDMARKER, tok_mod.ENCODING, tok_mod.INDENT, tok_mod.DEDENT):
        print(f"  {tok_mod.tok_name[t.type]:10} {t.string!r}")

print("\n=== AST ===")
arvore = ast.parse(codigo_fonte)
print(ast.dump(arvore, indent=2))

print("\n=== BYTECODE ===")
codigo_compilado = compile(codigo_fonte, "<inline>", "exec")
# a função está no interior do módulo — precisamos extraí-la
exec(codigo_compilado, globals())
dis.dis(soma_quadrados)
Juntando as peças #
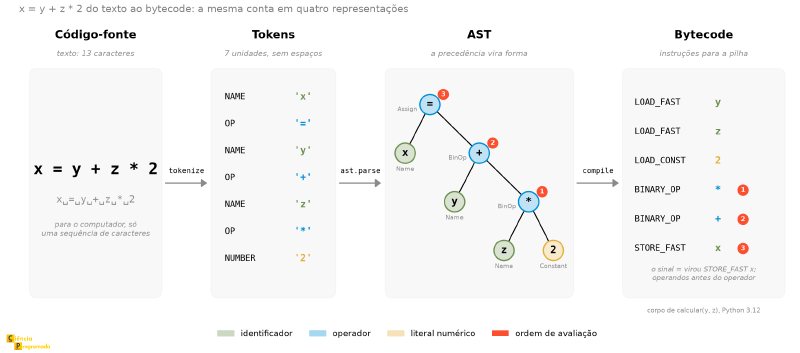
Antes da tabela, a expressão inteira de uma vez. A figura abaixo põe lado a lado as
quatro formas que x = y + z * 2 assumiu ao longo do artigo, com a ferramenta que leva
de uma à outra. As cores acompanham cada token do começo ao fim, e os números marcam a
mesma ordem de avaliação na árvore e no bytecode: a pilha executa os operadores na ordem
de baixo para cima da AST. A árvore tem o mesmo desenho da figura de Execução de
Programas.
A tabela a seguir mapeia cada fase teórica descrita em Execução de Programas para a ferramenta Python correspondente:
| Fase | Teoria | Ferramenta Python | O que observar |
|---|---|---|---|
| 1. Análise léxica | Tokenização | tokenize |
Lista de tokens com tipo e valor |
| 2. Análise sintática | Parser / AST | ast.parse() + ast.dump() |
Árvore hierárquica com precedências |
| 3. Semântica / verificações | Tipos e coerência operacional | Runtime (TypeError, etc.) |
Parte importante da coerência é verificada durante a execução |
| 4. Objeto de código executável | Representação executável interna | compile() → co_consts, co_names, co_stacksize |
Objeto de código que o CPython pode executar |
| 5. Otimização | Constant folding, etc. | co_consts (compare com/sem constantes) |
Expressões constantes pré-calculadas |
| 6. Código objeto | Bytecode | dis.dis() |
Instruções de bytecode da pilha de avaliação |
Leitura correta da tabela
A tabela acima não quer dizer que o CPython exponha uma API pública e independente para cada fase de um compilador clássico. Ela mostra, antes, uma correspondência didática aproximada entre a teoria e as ferramentas que o Python oferece para introspecção.
Conclusão e próximos artigos #
Python é uma linguagem excelente para observar várias transformações internas do
processo de compilação e execução. tokenize, ast, compile e dis tornam
concretas etapas que, em muitos compiladores, ficam escondidas atrás de
ferramentas internas ou saídas difíceis de inspecionar.
A próxima vez que você executar python script.py, você terá uma visão muito
mais clara do que acontece nos bastidores.
Para quem quiser descer mais um nível, o guia de desenvolvedores do CPython documenta o compilador por dentro — as mesmas fases vistas aqui, mas do ponto de vista de quem mantém o interpretador, com os arquivos-fonte de cada etapa. É gratuito, oficial, e cobre exatamente o pipeline deste artigo.
Sobre __pycache__
__pycache__
O Python armazena versões compiladas .pyc em __pycache__ para acelerar o
carregamento de módulos. Esse processo é automático: o interpretador compara o
cache com o fonte e recompila quando necessário.
No próximo artigo, vamos falar de entrada e saída — como o computador se comunica com o mundo externo: polling, interrupções e acesso direto à memória (DMA), e por que a escolha do mecanismo de E/S afeta o desempenho do sistema inteiro.
Até lá!


