
No artigo anterior — CPU — Componentes e Ciclo de Instrução — apresentamos os blocos que formam a CPU: UAL, UC, registradores, decodificador e clock. Descrevemos os microeventos do ciclo de busca em notação LTR e vimos como o CI, o REM e o RI cooperam para trazer uma instrução da memória. Mas descrevemos tudo em termos gerais. Agora vamos concreto: vamos acompanhar um processador hipotético executando instruções reais, bit a bit.
Usar um processador simplificado como modelo pedagógico é uma estratégia clássica na área: eliminamos a complexidade de arquiteturas comerciais (x86, ARM) e nos concentramos nos mecanismos fundamentais que qualquer processador real compartilha.
Neste artigo você vai entender:
- a organização do processador hipotético de 12 bits;
- o conjunto completo de instruções e sua notação em LTR;
- como codificar uma instrução em binário e hexadecimal;
- o fluxograma do ciclo de instrução completo;
- a execução passo a passo de LDA e ADD com tabelas de estado;
- os fundamentos da linguagem de montagem (assembly);
- programas assembly completos para problemas práticos.
O processador hipotético #
Apesar de toda essa complexidade física dos chips modernos, os fundamentos lógicos que operam lá dentro permanecem surpreendentemente parecidos com os de seus ancestrais. Para entendermos como a CPU busca e executa instruções sem a “poluição” de bilhões de transistores e pipelines complexos, vamos dar um passo atrás. Usaremos como base um modelo de computador hipotético de apenas 12 bits.
O processador hipotético tem uma organização enxuta que mantém todos os componentes essenciais de um processador real. Sua especificação completa:
| Componente | Tamanho | Justificativa |
|---|---|---|
| Palavra | 12 bits | Tamanho de todas as células de memória |
| Endereços | 8 bits | \(2^8 = 256\) células endereçáveis |
| Células de memória | 12 bits | Uma instrução ou dado por célula |
| ACC (Acumulador) | 12 bits | Mesmo tamanho da palavra |
| CI / PC | 8 bits | Basta endereçar as 256 células |
| REM / MAR | 8 bits | Mesmo tamanho dos endereços |
| RDM / MBR | 12 bits | Mesmo tamanho da palavra |
| RI / IR | 12 bits | Armazena instrução completa |
Perceba a coerência: o CI tem 8 bits porque 8 bits bastam para endereçar 256 células; o REM também tem 8 bits porque ele precisa transportar endereços; o RDM, o RI e o ACC têm 12 bits porque trabalham com palavras completas.
Formato das instruções #
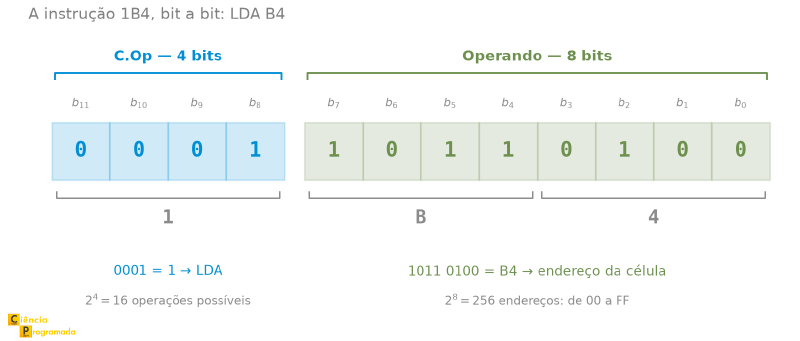
Cada instrução ocupa exatamente uma célula de memória — 12 bits divididos em dois campos:
$$\underbrace{b_{11}\ b_{10}\ b_9\ b_8}_{\text{C.Op (4 bits)}} \quad \underbrace{b_7\ b_6\ b_5\ b_4\ b_3\ b_2\ b_1\ b_0}_{\text{Operando (8 bits)}}$$- 4 bits de C.Op → \(2^4 = 16\) operações distintas possíveis
- 8 bits de operando → \(2^8 = 256\) endereços, cobrindo toda a memória
A figura abaixo mostra essa mesma divisão com uma instrução real preenchida — a
1B4, que aparece mais adiante no artigo. Vale reparar em duas coisas: cada dígito
hexadecimal corresponde a exatamente quatro bits, e é por isso que o C.Op ocupa o
primeiro dígito inteiro; e o operando, com seus oito bits, vai de 00 a FF, o
limite que todo endereço deste processador precisa respeitar.
O número de operações possíveis e o espaço de endereçamento crescem exponencialmente com os bits disponíveis. Adicionar 1 bit ao C.Op dobra o número de instruções; adicionar 1 bit ao operando dobra o espaço de memória endereçável.
Exemplo — Dimensionando um conjunto de instruções
Um processador tem 128 instruções distintas e memória com 512 palavras. Quantos bits são necessários para o C.Op e para o operando? Qual o tamanho total da instrução?
C.Op: \(\log_2 128 = \log_2 2^7 = \mathbf{7\ \text{bits}}\)
Operando: \(\log_2 512 = \log_2 2^9 = \mathbf{9\ \text{bits}}\)
Instrução = \(7 + 9 = \mathbf{16\ \text{bits}}\)
Registradores: CI e REM → 9 bits (endereçam memória); RDM e RI → 16 bits (armazenam palavras). Capacidade total: \(512 \times 16 = 8192\ \text{bits} = > 1\ \text{Kbyte}\).
Efeito de aumentar 1 bit no C.Op
Se esse processador passasse de 16 para 17 bits por instrução (mantendo o operando com 9 bits), o C.Op teria \(17 - 9 = 8\) bits → 256 operações possíveis. Um único bit a mais dobra o repertório de instruções.
O conjunto de instruções #
O conjunto de instruções do processador hipotético tem 15 entradas, cobrindo operações aritméticas, de movimentação de dados, desvios condicionais e incondicionais, e E/S:
| C.Op (hex) | Mnemônico | Operação em LTR | Descrição |
|---|---|---|---|
| 0 | HLT | — | Parar execução |
| 1 | LDA Op | \(\text{ACC} \leftarrow (Op)\) | Carregar da memória para o ACC |
| 2 | STR Op | \((Op) \leftarrow \text{ACC}\) | Armazenar ACC na memória |
| 3 | ADD Op | \(\text{ACC} \leftarrow \text{ACC} + (Op)\) | Somar |
| 4 | SUB Op | \(\text{ACC} \leftarrow \text{ACC} - (Op)\) | Subtrair |
| 5 | JZ Op | Se \(\text{ACC} = 0\): \(\text{CI} \leftarrow Op\) | Desvio se zero |
| 6 | JP Op | Se \(\text{ACC} > 0\): \(\text{CI} \leftarrow Op\) | Desvio se positivo |
| 7 | JN Op | Se \(\text{ACC} < 0\): \(\text{CI} \leftarrow Op\) | Desvio se negativo |
| 8 | JMP Op | \(\text{CI} \leftarrow Op\) | Desvio incondicional |
| 9 | GET Op | Entrada \(\rightarrow (Op)\) | Ler da porta de entrada |
| A | PRT Op | \((Op) \rightarrow\) saída | Imprimir/enviar para saída |
| B | MPY Op | \(\text{ACC} \leftarrow \text{ACC} \times (Op)\) | Multiplicar |
| C | DIV Op | \(\text{ACC} \leftarrow \text{ACC} \div (Op)\) | Dividir |
| D | INC | \(\text{ACC} \leftarrow \text{ACC} + 1\) | Incrementar ACC |
| E | DCR | \(\text{ACC} \leftarrow \text{ACC} - 1\) | Decrementar ACC |
O código F permanece livre para futuras extensões ou reservado.
Este processador tem parentes — e um deles roda no navegador
A máquina deste artigo não é uma invenção isolada. Praticamente toda disciplina de arquitetura constrói uma parecida, e várias delas têm nome, livro e implementação. As mais conhecidas são o Neander e o Ramses, definidos por Raul Weber em Fundamentos de Arquitetura de Computadores e usados em dezenas de cursos brasileiros; o MARIE, de Null e Lobur; o MIC-1, de Tanenbaum; o SAP-1, de Malvino; e o Little Man Computer, proposto por Stuart Madnick em 1965. O processador apresentado aqui é, em essência, um Neander com mais instruções: acumulador único, uma instrução por palavra, desvios condicionais que testam o ACC.
Saber disso tem uma vantagem prática — dá para rodar os programas em vez de
apenas segui-los no papel. O Little Man Computer tem um simulador
web que funciona no navegador, sem instalar
nada: você digita o programa, executa passo a passo e vê o acumulador e o contador
de instrução mudando a cada ciclo. O repertório dele é menor que o deste artigo,
mas traduz direto — LDA, ADD, SUB e STA fazem o mesmo, BRZ e BRP são os
desvios, INP e OUT são o GET e o PRT. Ver o CI avançando sozinho pela
primeira vez ensina mais que qualquer tabela de rastreamento.
Costumamos nos referir ao conjunto de instruções como ISA (Instruction Set Architecture). Ele define a interface entre o software e o hardware: quais operações o processador pode realizar e como elas são codificadas.
As instruções de desvio condicional (JZ, JP, JN) alteram o CI somente se a condição for verdadeira. Caso contrário, a execução continua normalmente — o CI já foi incrementado no ciclo de busca, portanto a próxima instrução sequencial é executada automaticamente.
Codificando instruções #
Para codificar uma instrução em hexadecimal, basta concatenar os bits do C.Op com os bits do operando:
LDA 180\(_{10}\):
- C.Op de LDA: \(1_{10} = 0001_2\)
- Endereço do operando: \(180_{10} = 1011\ 0100_2 = \text{B4}_{16}\)
- Instrução completa (12 bits): \(\underbrace{0001}_{\text{C.Op}} \underbrace{10110100}_{\text{operando}} = \mathbf{1\text{B}4}_{16}\)
ADD 181\(_{10}\):
- C.Op de ADD: \(3_{10} = 0011_2\)
- Endereço do operando: \(181_{10} = 1011\ 0101_2 = \text{B5}_{16}\)
- Instrução completa: \(\underbrace{0011}_{\text{C.Op}} \underbrace{10110101}_{\text{operando}} = \mathbf{3\text{B}5}_{16}\)
O processo inverso — decodificar uma instrução hexadecimal — é igualmente direto: basta separar os 4 bits mais significativos (C.Op) dos 8 bits menos significativos (operando):
Exemplo — Decodificando \(\text{135}_{16}\)
\(\text{135}_{16} = 0001\ 0011\ 0101_2\)
C.Op = \(0001_2 = 1_{10}\) → LDA
Operando = \(0011\ 0101_2 = \text{35}_{16} = 53_{10}\) → endereço 53
Instrução decodificada: LDA 53
O ciclo de instrução completo #
Com o conjunto de instruções definido, o fluxograma do ciclo de instrução fica completo. Ele opera indefinidamente até encontrar HLT:
flowchart TD
    START(["▶ INÍCIO"])

    subgraph BUSCA["Ciclo de Busca"]
        B1["REM ← CI
Envia endereço ao barramento"]
        B2["RDM ← M(REM)
Lê instrução da MP"]
        B3["RI ← RDM
CI ← CI + 1"]
    end

    subgraph EXEC["Ciclo de Execução"]
        E1{"Decodificar
C.Op de RI"}
        E2{"Precisa
buscar operando?"}
        E3["REM ← operando de RI
RDM ← M(REM)"]
        E4["Executar operação
(UAL ou UC)"]
    end

    HLT{"HLT?"}
    STOP(["⏹ PARAR"])

    START --> B1
    B1 --> B2
    B2 --> B3
    B3 --> E1
    E1 --> E2
    E2 -->|"Sim"| E3
    E3 --> E4
    E2 -->|"Não"| E4
    E4 --> HLT
    HLT -->|"Não"| B1
    HLT -->|"Sim"| STOP
Note que o CI é incrementado no ciclo de busca, antes da execução. Quando a instrução atual está sendo executada, o CI já aponta para a próxima. Isso é importante para as instruções de desvio: JMP e as variantes condicionais sobrescrevem o CI durante a execução, redirecionando o fluxo do programa.
Execução passo a passo — LDA #
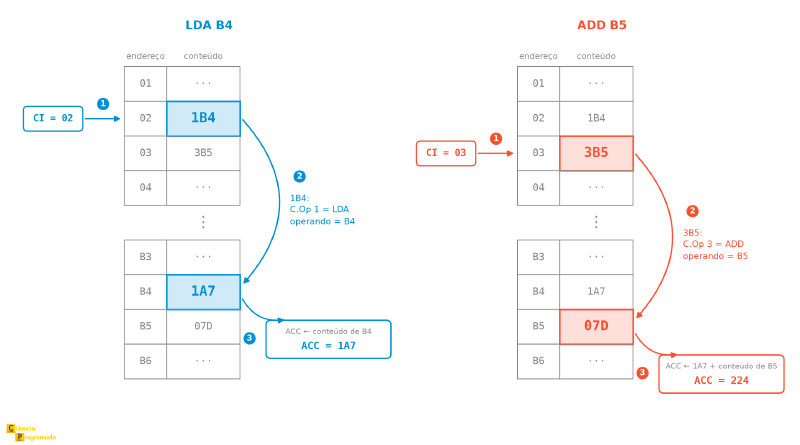
As duas tabelas a seguir acompanham LDA B4 e depois ADD B5 registrador por
registrador, e isso exige manter cinco endereços na cabeça ao mesmo tempo. A figura
abaixo serve de mapa para a leitura: ela mostra o trecho da memória que as duas
execuções usam e o caminho de cada uma, em três passos numerados — o CI aponta a
célula da instrução, o operando da instrução aponta a célula do dado, e o dado chega
ao acumulador.
Vamos acompanhar a execução de LDA B4 — a instrução que a codificação anterior
produziu, \(\text{1B4}_{16}\) — com o estado inicial: CI = 02;
MP[02] = \(\text{1B4}_{16}\) (a instrução); MP[B4] = \(\text{1A7}_{16}\) (o dado a
carregar).
| Passo | Operação em LTR | Estado dos registradores |
|---|---|---|
| 1 | \(\text{REM} \leftarrow (\text{CI})\) | REM = 02 |
| 2 | \(\text{RDM} \leftarrow M(\text{REM})\) | RDM = 1B4 |
| 3 | \(\text{RI} \leftarrow \text{RDM}\) | RI = 1B4 |
| 4 | \(\text{CI} \leftarrow \text{CI} + 1\) | CI = 03 |
| 5 | Decodificação: 4 MSBs de 1B4 = 0001 → LDA | — |
| 6 | Operando B4 → REM | REM = B4 |
| 7 | UC ativa READ no barramento de controle | — |
| 8 | \(\text{RDM} \leftarrow M(\text{B4})\) | RDM = 1A7 |
| 9 | \(\text{ACC} \leftarrow \text{RDM}\) | ACC = 1A7 ✓ |
Os passos 1–4 são o ciclo de busca (os mesmos \(t_0, t_1, t_2\) do artigo anterior). Os passos 5–9 são o ciclo de execução específico do LDA.
Execução passo a passo — ADD #
Continuando a partir do estado deixado pelo LDA: CI = 03; MP[03] = \(\text{3B5}_{16}\); ACC = \(\text{1A7}_{16}\); MP[B5] = \(\text{07D}_{16}\).
| Passo | Operação em LTR | Estado dos registradores |
|---|---|---|
| 1 | \(\text{REM} \leftarrow (\text{CI})\) | REM = 03 |
| 2 | \(\text{RDM} \leftarrow M(\text{REM})\) | RDM = 3B5 |
| 3 | \(\text{RI} \leftarrow \text{RDM}\) | RI = 3B5 |
| 4 | \(\text{CI} \leftarrow \text{CI} + 1\) | CI = 04 |
| 5 | Decodificação: 4 MSBs de 3B5 = 0011 → ADD | — |
| 6 | Operando B5 → REM | REM = B5 |
| 7 | UC ativa READ | — |
| 8 | \(\text{RDM} \leftarrow M(\text{B5})\) | RDM = 07D |
| 9 | UAL recebe ACC = 1A7 e RDM = 07D | — |
| 10 | UAL calcula: \(\text{1A7}_{16} + \text{07D}_{16}\) | — |
| 11 | \(\text{ACC} \leftarrow \text{resultado}\) | ACC = 224 ✓ |
Verificação: \(\text{1A7}_{16} = 423_{10}\); \(\text{07D}_{16} = 125_{10}\); \(423 + 125 = 548_{10} = \text{224}_{16}\) ✓
Executando desvios — JMP e JZ #
Os desvios diferem de LDA e ADD em um aspecto importante: em vez de buscar um
dado para a UAL processar, eles alteram o fluxo de execução por meio do
Contador de Instrução.
JMP 09 (desvio incondicional):
- Busca normal → RI recebe a instrução JMP; CI é incrementado.
- Decodificação: UC identifica JMP → sinaliza salto incondicional.
- \(\text{CI} \leftarrow 09\) — o operando vai direto para o CI, sem acesso à MP.
- A próxima busca ocorre no endereço
09.
JZ 07 (desvio se ACC = 0):
- Busca normal → RI = JZ 07; CI é incrementado.
- Decodificação: UC identifica JZ → sinaliza salto condicional.
- A UAL verifica se ACC = 0.
- Se ACC = 0: \(\text{CI} \leftarrow 07\) → próxima execução no endereço
07. - Se ACC ≠ 0: CI permanece incrementado → próxima instrução sequencial.
A mesma lógica se aplica a JP (desvio se ACC > 0) e JN (desvio se ACC < 0): a condição é avaliada pela UAL usando as flags de estado, e o CI só é sobrescrito se a condição for verdadeira.
Sobre flags neste processador hipotético
Em CPUs reais, desvios condicionais costumam depender de flags de estado
produzidas pela UAL, como Zero, Negative, Carry e Overflow.
Já falamos sobre flags neste artigo.
Neste processador didático, porém, os desvios JZ, JP e JN podem ser
entendidos de forma mais simples: eles testam diretamente o valor lógico do
acumulador (ACC = 0, ACC > 0, ACC < 0).
Da linguagem de máquina ao assembly #
Programar diretamente em hexadecimal é trabalhoso e propenso a erros. A linguagem de montagem (assembly) resolve isso substituindo os códigos binários por mnemônicos alfanuméricos que mantêm uma relação direta com as instruções de máquina.
| Aspecto | Detalhes |
|---|---|
| Relação com a máquina | 1:1 — uma instrução assembly = uma instrução de máquina |
| Legibilidade | Muito maior que código hexadecimal |
| Tradução | Realizada por um programa Montador (Assembler) |
| Portabilidade | Baixa — específica para cada arquitetura |
Compilador vs. Montador
- Montador (Assembler): traduz linguagem assembly para código de máquina da arquitetura alvo, normalmente preservando uma correspondência muito próxima com as instruções reais do processador.
- Compilador: traduz uma linguagem de mais alto nível para alguma forma de representação executável ou intermediária, que depois poderá ser convertida em código de máquina.
Em modelos didáticos como este, é comum tratar assembly como tendo relação quase direta com as instruções da máquina. Em ferramentas reais, porém, pseudoinstruções, macros e otimizações podem quebrar uma correspondência estritamente 1:1.
Estrutura de uma linha assembly #
Rótulo      Operação    Operandos    ; Comentário
INICIO:     LDA         A            ; Carrega valor de A no ACC
O rótulo é opcional e identifica o endereço da instrução (útil para desvios). A operação é o mnemônico. O comentário é ignorado pelo montador.
Exemplo: \(X = A + B - C\) #
Em alto nível, uma linha. Em assembly, quatro instruções — uma por operação primitiva da CPU:
LDA A    ; ACC ← (A)
ADD B    ; ACC ← ACC + (B)
SUB C    ; ACC ← ACC − (C)
STR X    ; (X) ← ACC
Cada linha corresponde exatamente a uma instrução de máquina. O compilador, ao processar a expressão de alto nível, gera uma sequência semelhante a essa.
Assembly na prática #
A seguir, programas completos que ilustram o uso do conjunto de instruções do processador hipotético em problemas reais. Os endereços de memória são expressos em hexadecimal.
Verificação de senha com embaralhamento #
Um sistema armazena a senha de forma embaralhada no endereço 42: o valor
guardado é \(S/2 - (30)\), onde \((30)\) é o conteúdo do endereço 30.
O usuário digita sua tentativa no endereço 20. O programa deve verificar se
a tentativa confere e gravar 1 em 22 (acerto) ou 0 (erro).
Endereços auxiliares: 40 = 0, 41 = 1, 43 = 2.
; Estratégia: embaralhar o que o usuário digitou e comparar com o armazenado
00: LDA 20   ; ACC ← tentativa do usuário
01: DIV 43   ; ACC ← ACC / 2
02: SUB 30   ; ACC ← ACC − (30)  — agora ACC tem a tentativa embaralhada
03: SUB 42   ; ACC ← embaralhado calculado − embaralhado armazenado
04: JZ 08    ; Se ACC = 0 → senhas conferem; pula para 08
05: LDA 40   ; ACC ← 0
06: STR 22   ; (22) ← 0 — senha errada
07: HLT
08: LDA 41   ; ACC ← 1
09: STR 22   ; (22) ← 1 — senha correta
0A: HLT
Repare que todos os endereços têm dois dígitos hexadecimais, e isso não é
estética: o operando tem 8 bits, então o maior endereço possível é FF. Um
programa que citasse um endereço como 120 estaria fora da memória desta máquina.
O padrão SUB → JZ/JP/JN é a forma de implementar uma comparação no processador
hipotético: subtrair os dois valores e verificar se o resultado é zero, positivo
ou negativo.
O embaralhamento por divisão tem um furo
A UAL deste processador só trabalha com inteiros, e DIV descarta o resto.
Isso significa que senhas consecutivas colidem: se a senha verdadeira for
\(S = 7\), o valor guardado é \(7/2 - (30) = 3 - (30)\) — e a tentativa
\(6\) produz \(6/2 - (30) = 3 - (30)\), exatamente o mesmo. O programa
aceitaria as duas.
O problema não está no assembly, está no esquema de embaralhamento: qualquer transformação que perca informação aceita mais de uma entrada. Um embaralhamento que só some, subtraia ou multiplique não teria esse efeito. Vale como lembrete de que divisão inteira não é divisão — o mesmo cuidado que aparece na média de sensores mais adiante.
A mesma coisa usando GET e PRT
GET e PRT
O enunciado diz que “o usuário digita sua tentativa no endereço 20” — mas quem
coloca o valor ali? No programa acima, alguém de fora. O repertório do processador
tem instruções justamente para isso: GET lê da porta de entrada e PRT escreve
na porta de saída. Com elas, o programa deixa de depender de mágica externa:
00: GET 20   ; lê a tentativa do usuário direto para (20)
01: LDA 20   ; ACC ← tentativa
02: DIV 43   ; ACC ← ACC / 2
03: SUB 30   ; ACC ← tentativa embaralhada
04: SUB 42   ; compara com a senha embaralhada armazenada
05: JZ 0A    ; confere → pula para 0A
06: LDA 40   ; ACC ← 0
07: STR 22   ; (22) ← 0
08: PRT 22   ; mostra o resultado (0 = senha errada)
09: HLT
0A: LDA 41   ; ACC ← 1
0B: STR 22   ; (22) ← 1
0C: PRT 22   ; mostra o resultado (1 = senha correta)
0D: HLT
Duas instruções a mais e o programa ganha entrada e saída de verdade. A versão anterior continua valendo: em provas e livros é comum que os dados já apareçam “postos na memória”, e saber ler os dois estilos é parte do jogo.
Folha de pagamento com teto salarial #
Calcular o ganho total de um funcionário:
$$\text{Ganho\_Total} = \min(\text{Ganho\_Bruto} + \text{Bônus},\ \text{Teto}) + \text{Ganho\_Adicional}$$Dados: 15 = Ganho_Bruto, 16 = Bônus, 17 = Teto, 18 = Ganho_Adicional, 19 = Ganho_Total.
00: LDA 15   ; ACC ← Ganho_Bruto
01: ADD 16   ; ACC ← Bruto + Bônus
02: SUB 17   ; ACC ← (Bruto + Bônus) − Teto
03: JP 07    ; Se ACC > 0 (excedeu o teto) → pula para 07
04: LDA 15   ; Não excedeu: refaz Ganho_Bruto
05: ADD 16   ; ACC ← Bruto + Bônus
06: JMP 08   ; Pula para somar adicional
07: LDA 17   ; Excedeu: usa o Teto como base
08: ADD 18   ; ACC ← base + Ganho_Adicional
09: STR 19   ; Ganho_Total ← ACC
0A: HLT
Média de quatro sensores #
Quatro leituras de sensores estão nos endereços 15, 16, 17 e 18.
Calcular a média e armazenar em 13. O endereço 14 contém o valor 2.
; Divisão por 4 = dois DIVs por 2 consecutivos
00: LDA 15   ; ACC ← sensor1
01: ADD 16   ; ACC ← ACC + sensor2
02: ADD 17   ; ACC ← ACC + sensor3
03: ADD 18   ; ACC ← ACC + sensor4  (soma total)
04: DIV 14   ; ACC ← ACC / 2
05: DIV 14   ; ACC ← ACC / 2  (total: dividido por 4)
06: STR 13   ; média ← ACC
07: HLT
Neste processador, DIV é uma instrução explícita do repertório. Em uma CPU real, dividir
por 4 também pode ser implementado por deslocamentos de bits, mas isso é um
detalhe de implementação da UAL, não uma exigência do programa assembly.
Dividir por 4 equivale a dois deslocamentos aritméticos de 1 bit à direita —
o mesmo que >> 2 em linguagens de programação modernas.
Média e contagem de valores críticos #
Três medições nos endereços 30, 31 e 32. (a) Calcular a média e
armazenar em 40. (b) Contar quantas medições superam 50 e armazenar em 41.
Endereços auxiliares: 50 = 0, 51 = 1, 53 = 3, 55 = valor crítico 50.
; --- Parte A: Média ---
00: LDA 30   ; ACC ← med1
01: ADD 31   ; ACC ← ACC + med2
02: ADD 32   ; ACC ← ACC + med3
03: DIV 53   ; ACC ← ACC / 3
04: STR 40   ; média ← ACC

; --- Parte B: Contagem de valores > 50 ---
05: LDA 50   ; ACC ← 0 (inicializa contador)
06: STR 41   ; contador ← 0

; --- Testa med1 > 50 ---
07: LDA 30
08: SUB 55   ; ACC ← med1 − 50
09: JN 0E    ; se med1 < 50, não conta
0A: JZ 0E    ; se med1 = 50, também não conta
0B: LDA 41
0C: ADD 51
0D: STR 41

; --- Testa med2 > 50 ---
0E: LDA 31
0F: SUB 55
10: JN 15
11: JZ 15
12: LDA 41
13: ADD 51
14: STR 41

; --- Testa med3 > 50 ---
15: LDA 32
16: SUB 55
17: JN 1C
18: JZ 1C
19: LDA 41
1A: ADD 51
1B: STR 41

1C: HLT
O padrão correto para testar “maior que” com esse processador é:
- subtrair o limiar;
- descartar o caso negativo com JN;
- descartar o caso igual com JZ;
- só então incrementar o contador.
A mesma coisa usando INC
INC
O trecho que incrementa o contador aparece três vezes no programa acima:
LDA 41   ; ACC ← contador
ADD 51   ; ACC ← contador + 1   — (51) guarda o número 1
STR 41   ; contador ← ACC
O repertório tem INC, que soma 1 ao ACC e não precisa de operando nenhum:
LDA 41   ; ACC ← contador
INC      ; ACC ← contador + 1
STR 41   ; contador ← ACC
O ganho aqui não é de instruções — são três nas duas versões. É de memória de
dados: o endereço 51, que existia só para guardar o número 1, deixa de ser
necessário. Numa máquina com 256 células, cada endereço economizado conta. A
instrução DCR faz o simétrico, e é o que se usa para contar de trás para frente
até zero — o padrão do laço da próxima seção.
Multiplicação por somas sucessivas #
Os programas até aqui usaram ADD, SUB e DIV. Falta o caso clássico: como
multiplicar quando não existe instrução de multiplicação? A resposta é um laço que
soma o multiplicando tantas vezes quantas o multiplicador manda. Vale construí-lo,
por dois motivos: é assim que a multiplicação existia antes de virar circuito, e é
o primeiro programa deste artigo com estrutura de repetição de verdade.
Vamos calcular \((62) = (60) \times (61)\).
Endereços auxiliares: 63 = 0, 64 = 1, 65 = contador de trabalho.
; produto ← 0; repete (61) vezes: produto ← produto + (60)
00: LDA 63   ; ACC ← 0
01: STR 62   ; produto ← 0
02: LDA 61   ; ACC ← multiplicador
03: STR 65   ; contador ← multiplicador
04: LDA 65   ; ACC ← contador
05: JZ 0D    ; contador = 0 → acabou
06: LDA 62   ; ACC ← produto parcial
07: ADD 60   ; ACC ← produto + multiplicando
08: STR 62   ; produto ← ACC
09: LDA 65   ; ACC ← contador
0A: SUB 64   ; ACC ← contador − 1
0B: STR 65   ; contador ← ACC
0C: JMP 04   ; volta ao teste
0D: HLT
Acompanhando com \((60) = 3\) e \((61) = 2\): o contador entra valendo 2, o
produto passa por 0, 3 e 6, o contador desce para 1 e depois para 0, e o JZ do
endereço 04 encerra a execução com \((62) = 6\). São catorze instruções para uma
multiplicação — e o tempo de execução cresce com o valor do multiplicador, não
com o número de bits dele. Multiplicar por 1000 custa mil voltas no laço.
A mesma coisa usando MPY
MPY
Este processador tem MPY no repertório, e com ela o programa inteiro desaba para
quatro instruções:
00: LDA 60   ; ACC ← multiplicando
01: MPY 61   ; ACC ← multiplicando × multiplicador
02: STR 62   ; produto ← ACC
03: HLT
Catorze instruções viram quatro, os três endereços auxiliares desaparecem e o tempo de execução deixa de depender do valor dos operandos. O trabalho não sumiu: desceu para o hardware, onde um circuito multiplicador faz em paralelo o que o laço fazia em série. É exatamente a troca que a discussão CISC × RISC apresenta — mais trabalho por instrução contra instruções mais simples — vista do lado de quem escreve o programa.
Vale saber fazer das duas formas. A versão com laço é o que se pede quando o
objetivo é entender a operação por dentro; a versão com MPY é o que se escreve
quando a instrução existe.
O caminho inverso: STR (Store) #
Enquanto as instruções LDA e ADD trazem dados da memória para a CPU, a
instrução STR faz o exato oposto: salva o resultado do Acumulador de volta na
Memória Principal. O fluxo de microeventos fecha o ciclo de comunicação:
(REM) <- (RI[endereço]): O endereço de destino (onde o dado será salvo) é copiado para o REM.(RDM) <- (ACC): O dado já calculado sai do Acumulador e vai para o RDM (a “sala de espera” da saída).(MP(REM)) <- (RDM): A Unidade de Controle emite o sinal de escrita pelo barramento de controle, e a memória grava o dado no endereço especificado fisicamente.
Esse fluxo fecha o ciclo completo de comunicação entre CPU e memória: buscar, processar e armazenar o resultado.
Por dentro da UAL: Como o silício calcula? #
Até esse ponto, tratamos a operação ADD sem muitos detalhes. O decodificador
manda um sinal e a UAL simplesmente “soma” os valores que chegaram da memória.
Mas como um pedaço de silício consegue resolver matemática?
A resposta é que a UAL não entende números; ela entende eletricidade. Ela é construída por milhares de interruptores microscópicos organizados em circuitos chamados portas lógicas (como AND, OR, NOT e XOR). Cada porta recebe sinais elétricos (zeros e uns) e emite uma resposta baseada em uma regra lógica simples. Caso tenha um pouco de dificuldade, recomendo o artigo desta série sobre Álgebra Booleana.
Para realizar a soma de verdade quando a instrução ADD é executada, a CPU
combina essas portas lógicas em blocos matemáticos:
- Meio Somador (Half-Adder): Um circuito simples que usa portas lógicas para somar dois bits individuais, gerando um resultado e um “vai-um” (carry). Seu defeito é não conseguir receber um “vai-um” de uma operação anterior.
- Somador Completo (Full-Adder): A evolução do circuito, capaz de somar três bits (os dois operandos mais o “vai-um” da coluna vizinha).
Ao enfileirar vários Somadores Completos lado a lado, a UAL consegue somar palavras inteiras de 12, 32 ou 64 bits em uma fração de nanossegundo, propagando o “vai-um” do bit menos significativo até o final. É assim que o comando abstrato do Assembly vira um fluxo elétrico real.
Deslocamentos de bits #
Além de usar desvios para otimizar o fluxo do programa, a CPU também possui “atalhos” implementados diretamente no hardware para acelerar a matemática pesada. Em vez de acionar os somadores múltiplas vezes para fazer multiplicações ou divisões simples, a UAL inclui operações de deslocamento (shift). Elas são equivalentes a multiplicar ou dividir por potências de 2, mas executadas quase instantaneamente ao “empurrar” os bits para os lados:
$$\text{Shift left}\ n\ \text{bits} = \times\ 2^n \qquad \text{Shift right}\ n\ \text{bits} = \div\ 2^n$$Já abordamos isso anteriormente em um artigo sobre operadores bitwise, que explorou as operações bit a bit. Vamos ver um exemplo prático para fixar a ideia.
Para \(5_{10} = 0101_2\):
| Operação | Resultado binário | Resultado decimal |
|---|---|---|
| Shift left 1 bit | \(1010_2\) | \(10_{10}\) (\(5 \times 2\)) ✓ |
| Shift right 1 bit | \(0010_2\) | \(2_{10}\) (\(5 \div 2\), truncado) ✓ |
O exemplo da média de sensores (dividir a soma por 4 com dois DIV 14 onde
(14) = 2) é exatamente dois shifts right consecutivos.
Escopo desta observação
O exemplo acima descreve um mecanismo comum em UALs reais. Ele não significa
automaticamente que o processador hipotético deste artigo possua instruções
explícitas de SHL ou SHR no seu repertório assembly.
O Rastreamento de Execução (Tracer) #
Para visualizar o comportamento da CPU ao longo do tempo, é útil montar uma tabela de rastreamento que registre o estado dos principais registradores a cada fase de busca e execução.
A tabela abaixo é uma construção didática, inspirada no funcionamento do
processador hipotético, para acompanhar a sequência LDA 20, ADD 21, STR 22
assumindo MP[20] = 5 e MP[21] = 3:
| Passo | Fase | CI (PC) | REM | RDM | RI | ACC |
|---|---|---|---|---|---|---|
| 1 | Busca | 01 | 00 | LDA 20 |
LDA 20 |
0 |
| 2 | Execução | 01 | 20 | 5 | LDA 20 |
5 |
| 3 | Busca | 02 | 01 | ADD 21 |
ADD 21 |
5 |
| 4 | Execução | 02 | 21 | 3 | ADD 21 |
8 |
| 5 | Busca | 03 | 02 | STR 22 |
STR 22 |
8 |
| 6 | Execução | 03 | 22 | 8 | STR 22 |
8 |
Esse tipo de tabela funciona como um “raio-x” do ciclo de instrução.
Observe o fluxo perfeito: no passo 6, o valor 8, que estava no Acumulador, foi
jogado para o RDM para ser fisicamente gravado no endereço 22 da memória. A
CPU funciona no ritmo do relógio.
Conclusão e próximos artigos #
O processador hipotético condensa os mecanismos essenciais de qualquer processador real: um repertório de instruções codificado em bits, um ciclo que busca e executa cada instrução em sequência, e desvios que alteram esse fluxo com base em condições. O assembly revela a correspondência direta entre essas instruções e o código que o hardware executa.
No próximo artigo, vamos avançar para a execução paralela de múltiplas instruções com a técnica de pipeline. Veremos como isso multiplica o desempenho, quais hazards podem interromper esse fluxo e como a unidade de controle coordena tudo para manter a execução fluida.
Até lá!


